Cassandra

Apache Cassandra 4.1 introduit le framework Guardrails

Soumis par fredericmazue le

Apache Cassandra est un système de gestion de base de données (SGBD) de type NoSQL conçu pour gérer des quantités massives de données sur un grand nombre de serveurs, assurant une haute disponibilité en éliminant les points de défaillance unique. Il permet une répartition robuste sur plusieurs centres de données, avec une réplication asynchrone sans nœud maître et une faible latence pour les opérations de tous les clients. Apache Cassandra vient de sortir en version 4.1.

Dans une note de version vraiment copîeuse, se distingue l'arrivé du framework Guardrails.

Ce framework aide les opérateurs à éviter certains pièges de configuration et d'utilisation qui peuvent dégrader les performances et la disponibilité d'un cluster Apache Cassandra lorsqu'il est mis à l'échelle.

Par exemple, côté schéma, les utilisateurs peuvent créer trop de tables ou d'index secondaires, ce qui entraîne une utilisation excessive des ressources. Du côté des requêtes, les utilisateurs peuvent exécuter des requêtes touchant trop de partitions susceptibles d'impliquer tous les nœuds du cluster. Pire encore, ils peuvent simplement exécuter une requête en utilisant un filtrage coûteux côté réplique, lisant potentiellement tout le contenu de la table en mémoire sur tous les nœuds du cluster. 

Tous ces exemples des anti-modèles Cassandra bien connus, et les administrateurs doivent être vigilants pour empêcher les utilisateurs de les subir. Mais même si l'on est parfaitement conscient des modèles d'utilisation corrects, il est facile de perdre de vue des éléments tels que la taille des collections non figées, soulignent les concepteurs de Cassandra.

Le nouveau framework Guardrails permet aux opérateurs de restreindre l'utilisation de Cassandra par :

  • Désactivation de certaines fonctionnalités.
  • Interdiction de certaines valeurs spécifiques.
  • Définir des limites souples et dures à certaines grandeurs de base de données.

Les Guardrails, ou garde-corps, ou garde-fous, sont définis comme des propriétés normales dans le fichier de configuration de Cassandra, cassandra.yaml. Ils ressemblent à:

tables_warn_threshold: -1
tables_fail_threshold: -1
secondary_indexes_per_table_warn_threshold: -1
secondary_indexes_per_table_fail_threshold: -1
allow_filtering_enabled: true
partition_keys_in_select_warn_threshold: -1
partition_keys_in_select_fail_threshold: -1
collection_size_warn_threshold:
collection_size_fail_threshold:

La plupart des garde-fous sont vérifiées au niveau de la couche CQL, sans impliquer le moteur de stockage ni des répliques supplémentaires. Les garde-gous booléenns pour désactiver les fonctionnalités, telles que allow_filtering_enabled, interrompent les opérations tentant d'utiliser la fonctionnalité désactivée.

Ce framework permet de travailler avec 22 types garde-fous différents pour le moment. Les développeurs de Cassandra prévoient de l'enrichir prochainement.

Cassandra 4.0 : des latences de queue réduites grâce au ramasse-miettes ZGC de Java 16

Soumis par fredericmazue le

Apache Cassandra est un système de gestion de base de données (SGBD) de type NoSQL conçu pour gérer des quantités massives de données sur un grand nombre de serveurs, assurant une haute disponibilité en éliminant les points de défaillance unique. Il permet une répartition robuste sur plusieurs centres de données, avec une réplication asynchrone sans nœud maître et une faible latence pour les opérations de tous les clients. Apache Cassandra vient de sortir en version 4.0.

Si la note de version  de Cassandra 4.0 est vraiment très volumineuse, la nouveauté la plus marquante est sans doute l'ajout de la prise en charge de Java 9 et versions ultérieures.

En effet cet ajout, outre les améliorations apportées à Cassandra elle-même, permet de bénéficier des améliorations de Java et en l'occurrence du ramasse-miette Z Garbage Collector, ou ZGC, qui est arrivé à titre expérimental dans Java 11, mis en production avec Java 15 et encore amélioré avec Java 16.

ZGC promet des temps de pause très courts pour les opérations de nettoyage de la mémoire : moins de 10 ms.

D'après un benchmark publié sur jaxenter.com, utiliser Cassandra et le ZGC de Java 16  conjointement débloque 30% de débit supplémentaire pour les charges de travail de clé/valeur et de séries temporelles, sans effet sur la charge de travail tabulaire. Ceci grâce à la réduction des latences de queue apportées par ZGC.

Scylla Open Source 3.0

Soumis par fredericmazue le

Scylla Open Spource, anciennement ScyllaDB est un système de base de données NoSQL distribué alternatif à Apache Cassandra. Mais tandis que Cassandra est écrit en Java, Scylla Open Source est écrit en C++ pour viser la performance.

ScyllaDB, la société éditrice, présente Scylla Open Source ainsi :

En tant que remplaçant immédiat d'Apache Cassandra et offrant des performances 10 fois supérieures, Scylla Open Source a ajouté des capacités de production très attendues par la communauté NoSQL, tout en introduisant de nouvelles fonctionnalités révolutionnaires qui améliorent l'utilisation et réduisent les coûts opérationnels.

Scylla Open Source 3.0 présente une conception proche du matériel qui permet une utilisation optimale des serveurs modernes. Conçu à partir de zéro en C ++ pour améliorer de manière significative le débit, la latence et l’administration, Scylla offre des performances d’augmentation de plus de 1 000 000 transaction âr seconde et par nœud, jusqu’à des centaines de nœuds et atteint systématiquement une latence de 99% de moins que 1 milliseconde.

Scylla Open Source vient de sortir en version 3.0 et apporte les nouvelles capacités suivantes :

  • OLTP et OLAP simultanés: Scylla permet à ses utilisateurs d’équilibrer en toute sécurité les charges de travail opérationnelles en temps réel avec les charges de travail analytiques de données volumineuses au sein d’un même cluster de bases de données. Le traitement des transactions en ligne (OLTP) et le traitement analytique en ligne (OLAP) ont des caractéristiques d'accès aux données très différentes. OLTP implique de nombreuses transactions de petite taille et variées, notamment des écritures mixtes, des mises à jour et des lectures, avec une sensibilité élevée à la latence. En revanche, OLAP met l’accent sur le débit d’analyses étendues dans les ensembles de données. En introduisant des fonctionnalités qui isolent les charges de travail, Scylla prend en charge de manière unique les charges de travail OLTP et OLAP simultanées sans sacrifier la latence ou le débit.
  • Vues matérialisées: version prête à la production d'une fonctionnalité expérimentale attendue depuis longtemps, conçue pour permettre la dénormalisation automatisée des tables côté serveur. La communauté Apache Cassandra a notamment rétabli cette fonctionnalité de Cassandra prête pour la production au mode expérimental en 2017.
  • Index secondaires: prêts pour la production avec sa version 3.0, les index secondaires globaux de Scylla peuvent s’adapter à n’importe quelle taille de cluster, contrairement à la méthode d’indexation locale adoptée par Apache Cassandra. Les index secondaires permettent l'interrogation de données via des colonnes de clé non primaire.
  • Compatibilité des formats de fichier Cassandra 3.x: Scylla Open Source 3.0 inclut le format de stockage compatible Apache Cassandra 3.x (SSTable), ce qui améliore les performances et réduit le volume de stockage de 3 fois.

Site : https://www.scylladb.com/open-source/

Spotify ouvre le code de cstar

Soumis par fredericmazue le

Spotify a récemment ouvert le code de cstar, qui est un outil d’orchestration de clusters Apache Cassandra en ligne de commande.

cstar est né de la nécessité d'exécuter des commandes shell dans les nœuds Cassandra. Ces commandes shell sont généralement liées aux performances, à la sécurité, à la cohérence, à la mise à niveau, etc.

En 2017, la flotte de Spotify Cassandra a atteint 3 000 noeuds, ce qui a rendu de plus en plus urgent pour la société de disposer d’une solution sûre et efficace pour exécuter des commandes de shell. La simple mise à jour de cette flotte prenant des allures de cauchemar.

A la différence de Ansible, cstar tient compte de la topologie des cluster.s A la différence de Fabric, cstart est thread-safe.

Pour utiliser ctsar toutes les machines doivent tourner avec un système d'exploitation de de type UNIX, tel que OS X ou Linux, avoir un shell Bourne et Python 3 installé.

cstar est disponible sur GitHub.

Evénement Paris JUG : Quelle JVM et Garbage Collector choisir et Le futur d'Apache Cassandra

Soumis par fredericmazue le

Le Paris JUG est un groupe d'utilisateurs du langage Java qui se retrouve mensuellement à Paris. En cette rentré, Paris Jug vous propose le programme suivant :

19h15 à 19h30 : Accueil

19h30 - JVM et Garbage Collection : découvrez les algos et configurations qui font (ou pas) la différence sur la BDD Cassandra

G1, CMS, Shenandoah, ou Zing ? Heap size à 8GB ou 31GB? pointers compressés ? Region size ? Quel temps de pause maximum ? Débit ou Latence ... Un vrai gain est-il à espérer ? Quels sont les paramètres ayant le plus d'impact ?

Après un bref recapitulatif des differents GC, vous verrez l'effet des paramètres de la JVM sur Cassandra, une base de donnée à faible latence.
par Quentin Ambard

20h15 - Le futur d'Apache Cassandra
Apache Cassandra devenant de plus en plus mainstream, nous allons tenter une prospective pour anticiper son évolution dans les 2-3 prochaines années

Seront abordés notamment les sujets suivants:

la roadmap de la Cassandra 4.0
la fragmentation de l'écosystème avec les divers forks
la menace du cloud
l'éternel débat OSS vs Propriétaire
par DuyHai Doan

22h00 à ... 
3ème mi-temps des juggers dans un lieu sélectionné par votre Crew ;-)

Inscription sur le site

Les inscriptions seront ouvertes le jeudi précédent l'évènement

Date et lieu
Mardi 11 septembre 2018
Dans les locaux de Criteo


Progress : de nouveaux connecteurs DataDirect pour Apache Cassandra

Soumis par fredericmazue le

Progress annonce la sortie de Progress DataDirect for Apache Cassandra, une nouvelle série de connecteurs au sein de sa gamme DataDirect. Grâce aux interfaces standard ODBC et JDBC basées sur le langage SQL et reconnues par l’ensemble de l’industrie, DataDirect for Apache Cassandra garantit la compatibilité des applications existantes avec la base de données NoSQL Cassandra.

« Les entreprises leaders adoptent les bases de données Cassandra pour répondre aux exigences des solutions déployées sur Internet en matière de performances, d'évolutivité et de disponibilité », déclare Dion Picco, General Manager, Data Connectivity & Integration, chez Progress. « En présentant ses données sous la forme de tables relationnelles normalisées, la solution Progress DataDirect permet aux entreprises d'utiliser une solution standard basée sur le langage SQL avec des interfaces de connectivité ODBC et JDBC pour intégrer plus facilement Cassandra à leur infrastructure de gestion de données existante. »

ScyllaDB : Cassandra réécrite en C++ pour être 10 fois plus rapide

Soumis par fredericmazue le
Image

Voici une nouvelle qui ne manquera pas d'amuser les détracteurs de Java, qui depuis toujours lui reprochent sa lenteur, en dépit des indéniables améliorations que la machine virtuelle Java et son compilateur JIT ont connus au fil des années.

Cassandra est une base de données NoSQL et distribuée écrite en Java. Notre confrère Silicon a remarqué  que la société Scylla vient de réécrire Cassandra en C++. Cette mouture s'appelle ScyllaDB.

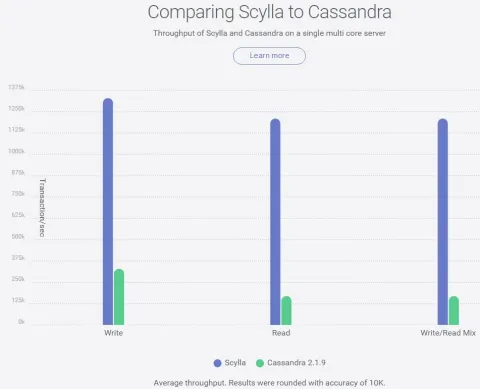
Scylla a publié un benchmark comparant ScyllaDB et Cassandra. Comme tous les benchmarks, il faut regarder les résultats avec un oeil critique. Cependant, ScyllaDB semble bien ridiculiser Cassandra sur le plan des performances.

Selon Scylla, ScyllaDB réalise jusqu'à 10 fois plus d'opérations par noeud que sa concurrente Cassandra. Un noeud ScyllaDB peut réaliser jusqu'à 1 million de transactions par seconde. Toujours selon l'éditeur, l'absence de ramasse-miettes permet de garantir un temps de latence au plus bas dans toutes les situations.

NoSQL Matters Paris 2015

Soumis par fredericmazue le

Après le succès des conférences de Cologne, Dublin et Barcelone, la 8ème édition de la Conférence NoSQL Matters se tiendra à Paris les 26 et 27 mars 2015. Zenika, société de services informatiques spécialisée dans l’Open Source et les méthodes Agiles, s’associe à cette édition française en tant que Conference Partner.

Dédié aux développeurs, cet événement est une occasion unique d’échanger avec les experts du NoSQL et Big Data et d’approfondir ses connaissances grâce au format innovant de l’événement : une journée de formations et une autre de conférences.

“L’engagement de Zenika dans le NoSQL Matters Paris renforce sa présence dans l’écosystème du Big Data et NoSQL, et le positionne comme acteur reconnu de ces technologies”, déclare Carl Azoury, CEO de Zenika. “Cet événement s’inclut dans la stratégie orientée innovation de notre entreprise” ajoute Laurent Delvaux, Directeur Général de Zenika.

Une série de formations a lieu le jeudi 26 mars, au sein des locaux de Zenika. Adaptées à tous types de niveaux, elles vous permettront de découvrir de nombreuses technologies et notamment Apache Cassandra, Redis, Riak.

Acteur de référence dans la formation sur les technologies Open Source et Agiles, Zenika anime l’une d’entre elle. Arnaud Cogoluègnes, Directeur Technique de Zenika Lyon, présente le « Traitement batch sur Hadoop en un clin d'oeil ».

Les participants peuvent également s’inscrire à des conférences thématiques qui ont lieu le vendredi 27 mars au Tapis Rouge, en plein coeur de Paris. Cette 2ème journée sera marquée par l’intervention de Rob Harrop, CTO de Bamboo, qui fera un focus sur le NoSQL. Les participants pourront bénéficier, tout au long de cette journée, des retours d’expérience de plus de 15 intervenants français et internationaux sur les dernières tendances, développements et actualités du NoSQL et Big Data : cas pratiques clients (dont Amazon, Criteo, Google, Booking.com...) et démonstrations de technologies sont au rendez-vous.

Expert du Big Data, Bruno Guedes, Directeur Technique Zenika Paris, prendra la parole sur le thème « Hadoop realtime for dummies » et vous donnera les clés pour vous approprier les bases d’Hadoop.

Zenika vous donne également rendez-vous sur son stand, n’hésitez pas à venir rencontrer leurs équipes.

Pour plus d'informations sur la conférence NoSQL Matters Paris 2015, et pour vous y inscrire, rendez-vous sur le site internet de Zenika.

Soirée Cassandra au Paris JUG

Soumis par fredericmazue le

Le Paris JUG consacre une soirée à Cassandra, une base de données NoSQL. Haute disponibilité et développement seront les principaux aspects abordés.

19h15 à 19h30 : Accueil

19h30 à 20h25 : Apache Cassandra 2.1, présentation et architecture.Présentation de Apache Cassandra 2.1 et son architecture. Comment la base de données peut garantir une scalabilité linéaire, une haute disponibilité tout en gardant un niveau de performance constant. Présentation du modèle de données sous-jacent et le langage CQL pour vous permettre de faire vos premiers pas avec Cassandra.Intervenant : Duy Hai Doan

20h25 à 21h05 : Buffet offert par la société Datastax 

21h05 à 22h00 : Cassandra pour les développeurs Java
Présentation du driver Java et DevCenter. Comment utiliser le driver Java pour interagir avec Cassandra, y compris de façon asynchrone, et comment utiliser l'Object Mapper pour créer un mapping entre Java et CQL. Présentation de  DevCenter, un outil pour créer et exécuter des scripts CQL qui apporte aux devs et aux ops de nombreux avantages comme la validation syntaxique, l'assistance à la saisie, les "templates", et bien sûr, l'affichage des résultats et le traçage des requêtes. Nous terminerons cette session par un petit kata de code live en TDD pour montrer le driver et l'Object Mapper en action.Intervenants : Alexandre Dutra

22h10 à ... : 3ème mi-temps des juggers au Canon des Gobelins (25, avenue des Gobelins, 75013 PARIS)

Date et lieu
Mardi 10 février 2015
Les inscriptions sont via ce lien
Dans les locaux de l'ESIEA

Cassandra au LorraineJUG

Soumis par fredericmazue le

Le Lorraine JUG (Java User Group de Lorraine) vous invite à prochaine conférence pour découvrir Cassandra en compagnie de Duy Hau DOAN et Michaël FIGUIERE.

Au programme de la soirée :

18:15 - Accueil et enregistrement

18:30 - Duy Hai DOAN et Michaël FIGUIERE

La présentation se découpe en 2 sessions.

    • la première session, 1h, est une présentation générale de Cassandra, de son modèle de données et les bonnes pratiques de modélisation: comment passer du monde SQL au monde NoSQL, par DuyHai DOAN
  • la deuxième session, 30 mins, présentera les outils pour aider le développeur Java à travailler efficacement avec Cassandra, par Michael Figuière

20:30 - Drink et tombola…

1 pass DEVOXX à gagner par tirage au sort pour les membres du LorraineJUG

30 septembre 2014, 18h30
TELECOM Nancy
193 avenue Paul Muller, 54602 Villers-lès-Nancy 

S'inscrire

Plus d'informations