LLM

Android Bench teste des tâches sur plusieurs jours, la réussite des LLM s'effondre
Soumis par francoistonic le
IA
Image

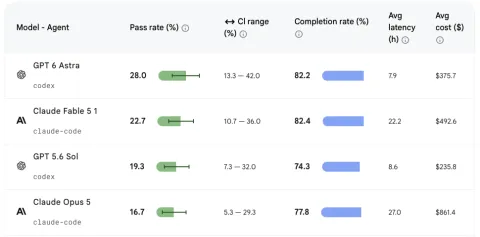
Android Bench est un benchmark des LLM du marché proposé par Google. Android Bench 2.0 pousse plus loin avec des tâches plus complexes sur plusieurs. Et là, les résultats peuvent d'effrondrer. Un des défis pour ces modèles n'est plus de générer du code mais mener à mener à son terme des tâches très complexes. Cette approche est appelée long-horizon tasks ou LHT. 

La premier bench avait mis en place une méthodologie avec des tâches "simples" sur quelques heures pour comparer les LLM. Pour améliorer les mesures face aux évolutions rapides des modèles, le comparatif s'appuie sur le framework Harbor. Et surtout, cette v2 pousse les LLM en demander des tâches nécessitant plusieurs jours pour pouvoir être résolues. 

Les résultats illustrent toute la difficulté pour LLM à rédoudre des tâches très complexes sur une longue durée. GPT 6 Astra affiche un ratio de réussite de 28 % pour un taux de complétion de 82,2 % pour une dépense total de 375 $. Fable 5.1 tombe à 22 % pour 492 $. Claude Opus 5 est le plus cher, 861 $ pour une réussite de 16,7 %. Dans le bench 1.0, les meilleurs LLM dépassaient largement les 80 %. 

Pour en savoir plus : https://developer.android.com/bench
Android Bench évalue les LLM pour les tâches Android, Claude Opus 5 arrive 1er mais...

Soumis par francoistonic le
IA
Image

Android Bench publie une évaluation de LLM pour les tâches de développement Android. Dans ce nouveau comparatif, 8 nouveaux modèles apparaissent. Les bases du comparatif :"Android Bench évalue la capacité des LLM à générer du code résolvant un problème en leur soumettant des cas concrets et des demandes de fusion issues de projets logiciels open source. Cette approche vise à garantir que les tâches soient représentatives des défis rencontrés quotidiennement par les développeurs. Pour établir une base de référence de performance, nous avons initialement inclus Gemini 2.5 Flash comme modèle de base, avec un taux de réussite de 16,1 % en mars 2026. Ainsi, nous disposions d'un seuil minimal pour tous les modèles évalués." On notera l'absence des modèles Grok.

Pour la mise à jour du 11 juillet, le top 5 est (classement par score) :

Claude Opus 91,8 %

Claude Fable 5 90,9 %

GPT 5.6 Sol 90,8 %

Kimi K7 90,2 %

GPT 5.6 Luna 87,6 %. 

Par contre, attention, si le score total affiche cet ordre, il faut regarder la latence et les coûts. Luna est le moins cher du top 5, Opus 5 le plus cher. Kimi K3 a une forte latence pour exécuter 100 tâces 5 fois. Notons que Qwen3.8 Max explose le coût du benchmark : 196,7 $, doublé d'une très mauvaise latence.

Conclusion : tout l'enjeu est de trouver un équilibre entre l'exécution des tâches, la latence du modèle et le coût, sans oublier la qualité des contenus générés. 

Page : https://developer.android.com/bench
Cast AI lance Kimchi Coding, un agent de codage

Soumis par francoistonic le
IA

Cast AI annonce Kimchi Coding. "Plutôt que de s’appuyer sur un seul modèle de pointe, une couche d’orchestration intelligente aiguille chaque tâche vers le modèle le mieux adapté, au meilleur coût. C’est déjà la direction que prennent beaucoup d’entreprises : réserver les modèles les plus puissants aux tâches vraiment complexes, et laisser les modèles open-weight gérer le reste." explique l'éditeur.

Kimchi orchestre plusieurs modèles pour utiliser le modèle plus pertinent pour telle ou telle tâche. L'autre objectif est de réduire la consommation des tokens. L’économie réalisée repose sur deux leviers : un routage qui envoie la majorité du travail vers des modèles open-weight, et une infrastructure d’inférence hébergée sur GPU, optimisée par Cast AI jusqu’au niveau du nœud Kubernetes. Testé en mode shadow face à une approche basée exclusivement sur des modèles commerciaux, Kimchi s’est révélé 2,5 fois moins coûteux, avec des résultats équivalents ou supérieurs sur la conformité aux spécifications et la réussite des tests. 

Plusieurs plans sont proposés :

- communautaire : 0 $ incluant CLI, un contxte de 250 000, pas de monitoring des coûts.

- Coder : 20 $ / mois pour les développeurs individuels

- Teams : 35 $ / mois / poste

Pour en savoir plus : https://kimchi.dev/

Faire tourner Qwen3.6 sur une GTX 1070 datant de... 2016

Soumis par francoistonic le
IA

Yves Rougy, qui travaille sur Linux et les IA souveraines, a voulu utiliser un matériel un peu ancien pour faire tourner des modèles localement : Asus G20AJ avec une GTX 1070 8 Go, pour la GPU. Le hardware propose un Core i7, 16 Go de RAM, Ubuntu 22.04 LTS, CUDA 12.8. Bref, un matériel un peu ancien mais à jour. Le PoC d'Yves est de faire tourner un LLM localement. Le choix se fait sur Qwen3.5 9B.

Pour optimiser son usage et minimiser les traitements, et la puissance GPU nécessaire, Yves opte pour une version quantisée disponible via Unsloth (Qwen3-35B-A3B-UD-IQ2_M). Il a fallu régler la configuration pour éviter la saturation de la RAM (côté GPU). 

Les performances mesurées sont :

- prefill (pp) : env. 375 tokens / seconde

- génération (tg) : env. 25 tokens / seconde

Comme le précise Yves, il a fallu faire une compilation de llama.cpp un peu spécifique pour le hardware cible puis il a fallu affiner les réglages. 

" J’ai essayé de trouver une bonne balance entre l’analyse de prompt et la génération de tokens. L’outil llama-benchy a été d’une grande aide. On voit que la génération reste stable autour de 23-25 tokens/seconde avec ces petits prompts, mais le prefill est autour de 375-400 tokens/seconde. Ce dernier est important en agentique. À l’usage, et ce n’est pas dans la mesure de llama-benchy, on notera que quand le contexte est plein, la vitesse de prefill tombe autour de 180-200 t/s et la génération autour de 15 t/s." explique Yves. 

Bilan : oui, il est possible de faire de l'IA au quotidien sur un hardware et un GPU non récents. Il avoue que pour la génération de code, il perd en précision à cause de la quantification. 

Pour découvrir le PoC complet : https://www.rougy.net/blog/20260526-qwen3.6-35b-a3b-gtx1070/

Commentaire actu

Programmez! 273 et hors série IA : les lectures incontournables

Soumis par francoistonic le
Image

Les derniers numéros sont toujours disponibles.

Programmez! 273

Toutes les nouveautés de PHP 8.5

Comprendre l'architecture ARM

Résumé de la Drupal AI Summit

Coder son propre assistant IA

Sommaire et pour le commander : https://www.programmez.com/magazine-papier/programmez-273

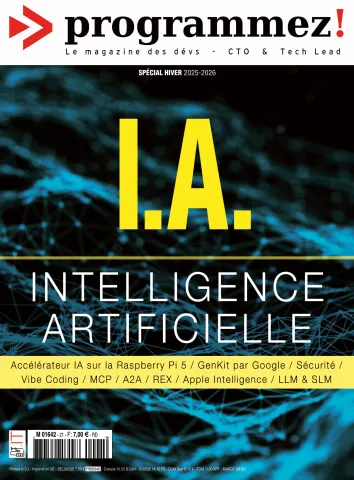
Programmez! hors série 21 : I.A.

Comprendre l'accélérateur HAILO-8L sur Pi 5

Genkit Go

Cursor

Agent Builder

Comprendre le MCP

Sommaire et pour le commander : https://www.programmez.com/magazine-papier/programmez-hors-serie-21

Et en bonus : Arpanet et les origines d'Internet

Technosaures publie un livre exceptionnel sur les origines d'Internet, le projet Arpanet : les différentes générations d'Arpanet, NSFnet et les origines d'Internet, la génération WWW. 150 pages de pur bonheur geek !

Vous pouvez le commander dès aujourd'hui : https://www.programmez.com/livres-mook/arpanet-et-lemergence-de-linternet-aux-origines-dinternet-1957-1999-une-histoire-de-la-micro

CompactifAI App : une IA hors ligne et locale sur son smartphone

Soumis par francoistonic le
IA

Multiverse Computing annonce annonce CompactifAI App. Il s'agit d'une application mobile permettant d’exécuter des modèles d’IA avancés directement sur smartphone ou tablette, sans connexion Internet. L’application permet également, lorsque cela est nécessaire, de basculer vers des modèles cloud via API. Elle s’adresse aux professionnels mobiles, aux organisations soumises à de fortes contraintes de confidentialité et aux équipes opérant dans des environnements à connectivité limitée.

CompactAI est inspiré de l'informatique quantique et permet de compression jusqu'à 95 % les modèles IA, sans perte significative de la précision. "À titre de comparaison, les méthodes de compression traditionnelles entraînent généralement une dégradation de performance de 20 à 30 % à des niveaux similaires." dixit l'éditeur. 

Les principales fonctionnalités

  • Fonctionnement 100 % hors ligne : Les modèles peuvent être téléchargés directement sur l’appareil et utilisés sans connexion Internet ;
  • Routage intelligent des requêtes : Selon la complexité de la demande, l’application oriente automatiquement la requête vers le modèle embarqué ou vers un modèle accessible via API ;
  • Confidentialité intégrée : Le traitement local garantit que les données sensibles restent sur l’appareil, sans exposition externe.

Plus d’informations : www.multiversecomputing.com

Les LLM utilisent les mêmes données : Larry Ellison prévient

Soumis par francoistonic le
IA

Quel est un des problèmes de l'IA actuelle ? Les modèles, principalement les LLM, utilisent grosso modo les mêmes données et, de facto, tous les grands LLM du marché sont peu ou prou identiques. Ils utilisent les mêmes données pour être entraînés, avec des variantes ici et là.

C'est Larry Ellison qui l'affirmait il y a quelques jours. Il n'y aurait donc pas assez de variations entre les LLM de Google, Meta, Open AI, etc. "Pour que ces modèles atteignent leur plein potentiel, il est nécessaire de les entraîner non seulement sur des données publiques, mais aussi sur des données privées." expliquait Ellison.

Oui, les LLM puisent dans les données accessibles et celles-ci ne sont pas extensibles à l'infini. Les sources sont donc, à un moment donné, les mêmes ou identiques. Chaque LLM est entraîné de manière différente. Cela détermine leurs comportements. Aujourd'hui, et encore plus demain, se pose la question : quelles nouvelles données pour alimenter les LLM ? Et sans ces nouvelles données, le risque est une stagnation des LLM.

Yan LeCun ne croit pas aux LLM et le chercheur voit l'avenir de l'IA dans une autre approche, ce qu'il appelle les modèles mondiaux. Ils doivent modéliser le monde réel pour le comprendre et le prédire. C'est une des raisons du départ de LeCun de Meta, une opposition stratégique sur le rôle des LLM et comment l'IA peut fonctionner. 

Pour Ellison, l'avenir, et l'efficacité des LLM, passe par les données des utilisateurs : les données internes des entreprises. Ce sont elles qui peuvent apporter du sens aux usages de l'IA par les utilisateurs.

L'autre risque est de vouloir faire grossir toujours plus les LLM, en multipliant toujours les paramètres. Ces modèles exigent une puissance de calcul colossale pour l'entraînement. Mais le LLM reste fondamentalement un modèle généraliste. 

Programmez! Hors-série 21 : I.A. édition 2026

Soumis par francoistonic le
Image
Image

Le magazine Programmez! vous propose l'édition 2026 dans son numéro IA. 

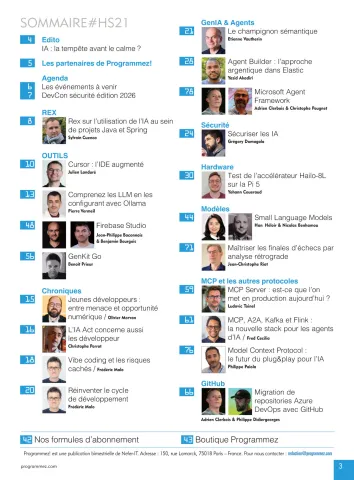
Au sommaire (extrait) :

Rex sur l’utilisation de l’IA au sein de projets Java et Spring / Sylvain Cuenca

Cursor : l’IDE augmenté / Julien Landuré

Comprenez les LLM en les configurant avec Ollama / Pierre Vermeil

Firebase Studio / Jean-Philippe Baconnais & Benjamin Bourgois

GenKit Go / Benoît Prieur

Vibe coding et les risques cachés / Frédéric Malo

Agent Builder : l’approche argentique dans Elastic / Yazid Akadiri

Microsoft Agent Framework / Adrien Clerbois & Christophe Peugnet

Sécuriser les IA / Grégory Domagala

Test de l’accélérateur Hailo-8L sur la Pi 5 / Yohann Coueraud

Ce numéro est disponible en kiosque, sur abonnement, en version papier et en PDF : https://www.programmez.com/magazine-papier/programmez-hors-serie-21

LLM, SLM, TRM : les différences entre les modèles utilisés par l'IA

Soumis par francoistonic le
IA

Késako ?


L'IA, qu’elle soit agentique ou générative, s'appuie sur des modèles, les fameux modèles de langage. Les modèles les plus connus sont les LLM ou Large Language Models. Ces modèles contiennent des milliards de paramètres qui permettent de prédire et de répondre aux requêtes. Les LLM sont avant tout des modèles généralistes. Ils sont entraînés sur des corpus de données colossaux et les plus variés possibles pour garder cette approche généraliste.

Les LLM exigent une puissance de traitements énorme pour supporter ces modèles. Gemini, GPT, Llama sont des LLM. 

Usages: généraliste et polyvalent. Très flexible dans son usage.

Les SLM (Small Language Models) sont des modèles plus légers que les LLM. Ils possèdent souvent quelques centaines de millions de paramètres, quelques milliards pour les plus gros. Le SLM n'est pas généraliste mais plutôt spécialisé et optimisée avec des données ciblés sur des domaines limités pour accroître l'efficacité dans les réponses. Le SLM exige moins de GPU. La taille réduire autorise une usage local élargi sans exiger une machine trop puissante. Phi-2 est un SLM.

Usages : tâches / demandes ciblées. Flexibilité relative dans la limite du corpus de départ.

Les TRM (Tiny Recursive Models) sont des modèles spécifiques à des tâches ou des domaines (très) précis. Ils sont entrainés et optimisés avec un corpus de données volontairement réduit et spécialisé. Par exemple : le médical, un langage de programmation, etc. Les ressources nécessaires sont proches d'un SLM.

Usages : idéal pour des tâches spécifiques et restreintes. Peu flexible dans l'usage car très spécialisé.

Source : post de Régis Sochard (Capgemini)


Gemini 3 est lancé par Google

Soumis par francoistonic le
IA
Image

Google a lancé Gemini 3. Naturellement, il est présenté par les équipes Google comme le meilleur LLM du marché pour générer du code. Gemini 3 se décline en plusieurs LLM : Gemini Pro 3 (preview) et Deep Think. Pour Google, les ambitions sont grandes : il s'agit de concurrencer frontalement GPT-5 et de rattraper OpenAI.

"Il se classe en tête du classement LMArena avec un score inégalé de 1501 Elo. Il fait preuve d'un raisonnement de niveau doctorat avec les meilleurs scores au "Humanity’s Last Exam" (37,5 % sans l'utilisation d'aucun outil) et au GPQA Diamond (91,9 %). Il établit également une nouvelle norme pour les modèles de frontière en mathématiques, atteignant une nouvelle référence de 23,4 % sur MathArena Apex." annonce Google

"Ses réponses sont intelligentes, concises et directes ; elles délaissent les clichés et la flatterie au profit d'une véritable perspicacité — en vous disant ce que vous avez besoin d'entendre, et pas seulement ce que vous voulez entendre. Il agit comme un véritable partenaire de réflexion qui vous offre de nouvelles façons de comprendre l'information et de vous exprimer, qu'il s'agisse de traduire des concepts scientifiques denses en générant du code pour des visualisations haute fidélité, ou de participer à un brainstorming créatif." explique Google.

Dès l'annonce, Gemini 3 Pro était disponible dans AI Studio, Vertex AI, Gemini CLI et dans les principaux IDE. GitHub a aussi annoncé la disponibilité du LLM dans Copilot. Ce support concerne les plans Pro, Pro+ Business et Enterprise. Il est disponible sur VS Code en mode Agent, Plan, Ask et Edit, sur github.com et GitHub CLI.