Programmation parallèle

TornadoVM: apporter aux applications Java l'accélération des GPU et des FPGA
Soumis par admin le
Image

TornadoVM est un plug-in pour OpenJDK et GraalVM qui permet aux programmeurs d'exécuter automatiquement des programmes Java sur du matériel hétérogène. TornadoVM cible actuellement les appareils compatibles OpenCL et fonctionne sur des processeurs multicœurs, des GPU (NVIDIA et AMD), des GPU intégrés Intel et des FPGA (Intel et Xilinx).

Les applications écrites pour TornadoVM sont à source unique - le même code est utilisé pour exprimer le code hôte et le code accéléré. TornadoVM étend le compilateur Graal JIT avec un nouveau backend pour OpenCL. A l'exécution, TornadoVM décharge les application Java sur les CPU multicoeurs, les GPU et les FPGA.

Soit une multiplication matricielle codée en Java :

class Compute {
   public static void matrixMultiplication(final float[] A, final float[] B, final float[] C, final int size) {
          for (int i = 0; i < size; i++) {
          for (int j = 0; j < size; j++) {
                    float sum = 0.0f;
                    for (int k = 0; k < size; k++) 
                   sum += A[(i * size) + k] * B[(k * size) + j];
                C[(i * size) + j] = sum;
          }
            }
    }
}

Pour accélérer ce code avec TornadoVM, on annote les boucles qui peuvent être parallélisées, comme ceci :

class Compute {
   public static void matrixMultiplication(final float[] A, final float[] B, final float[] C, final int size) {
          for (@Parallel int i = 0; i < size; i++) {
          for (@Parallel int j = 0; j < size; j++) {
                    float sum = 0.0f;
                    for (int k = 0; k < size; k++) 
                   sum += A[(i * size) + k] * B[(k * size) + j];
                C[(i * size) + j] = sum;
           }
         }
    }
}

Le compilateur TornadoVM JIT ne force pas la parallélisation. Au lieu de cela, il vérifie si les boucles annotées peuvent être parallélisées et il remplace les boucles for pour l'indexation parallèle équivalente dans OpenCL. Si les boucles for ne peuvent pas être parallélisées, TornadoVM sort et exécute le code séquentiel.

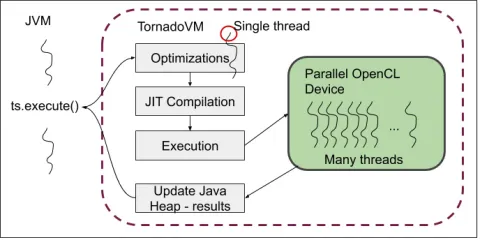
L'illustration ci-dessous montre une représentation du flux d'exécution entre JVM et TornadoVM.

TornadoVM  est un logiciel libre sous licence Apache 2.0, disponible sur GiHub.

Le créateur de TornadoVM a présenté celui en mars dernier lors de la conférence QCon-London. Les visuels et les démonstrations utilisés pour cette conférrence sont également disponible sur GitHub.

Le créateur de TornadoVM a également publié sur InfoQ un article très détaillé sur la mise en oeuvre de TornadoVM.

Concurnas : un langage pour la JVM, dédié à la programmation parallèle et distribuée

Soumis par fredericmazue le

En développement depuis trois ans, Concurnas est désormais un langage abouti qui mérite qu'on s'y attarde si l'on cherche un outil pour la programmation parallèle et/ou distribuée, ses champs de prédilection.

Concurnas est très inspiré de Python en ce qui concerne sa syntaxe, mais aussi de Java. C'est un langage compilé pour exécution sur une machine virtuelle Java.

Concurnas supporte la généricité et il est multi paradigmes : impératif, orienté objet et fonctionnel. A la programmation fonctionnelle, il emprunte notamment les fonctions lambdas, l'évaluation partielle et l'évaluation paresseuse, et il propose une boucle d'évaluation interactive, ou REPL, pour Read Eval Print Loop.

Une caractéristique très intéressante est son support de programmation GPU. Vous pouvez écrire votre code dans du code Concurnas idiomatique et l'exécuter sur le GPU sans avoir à passer en C/C++.

En ce qui concerne la sûreté du code, Concurnas est typé statiquement, avec un système d'inférence de type et il est sécurisé contre les pointeurs null.

Concurnas vous permet d'exécuter facilement le calcul, simultanément, dans des conteneurs de type thread appelés isolats via l'utilisation de l'opérateur bang ! lIln'y a pas besoin de créer / gérer des threads, des pools de threads, des cycles de vie, des verrous (ou des deadlocks... :-)

Tout le code Concurnas est exécuté dans des isolats. Les isolats sont mappés sur les threads matériels sous-jacents de la machine sur laquelle on exécute le code. Les isolats fonctionnent dans leur propre espace mémoire dédié.

Tous les états utilisés dans un isolat sont copiés à l'exception des références, des acteurs et de certaines classes partageables spécialement marquées. Cette isolation de l'état facilite le raisonnement et la conception d'algorithmes simultanés car elle réduit la nécessité de coder pour les conditions de synchronisation et de concurrence.

Quelques exemples :

Tout d'abord un 'Hello World' en Concurnas :

def complexFunc() {
  System.out.println("Hello world!")
}

complexFunc()!//execute concurrently in seperate isolate

Création et utilisation d'isolats

def gcd(x int, y int){//greatest common divisor of two integers
  while(y){
    (x, y) = (y, x mod y)
  }
  x
}

calc1 = gcd(8, 20)!//run this calculation in a isolate
calc2 = gcd(6, 45)!//run this calculation in a separate isolate

calc3 = calc1 if calc1 > calc2 else calc2
//^^^ wait for the results of calc1 and calc2 before assigning calc3

Références et calcul réactif

aRef int://this is a ref of type int
{//complex isolate executed concurrently eventually sets aRef...
  //complex code here...
  aRef = 10
}!

//aRef's current value is requested of it:
result int = aRef//If no value has yet been set execution will pause

System.out.println("The value of aRef is: " + result)

Concurnas est un logiciel libre sous licence MIT, disponible sur GitHub. Des plugins existent pour les EDI Atom, SublimeText et Visual Studio Code.

Site officiel : concurnas.com

Programmation parallèle, la 3ème saison du concours Accelerate est ouverte!

Soumis par fredericmazue le

Le programme Académique d'Intel organise entre le 16 Avril 2012 et le 16 Mai 2012 un grand concours de programmation parallèle. Ce concours de programmation parallèle est dédié aux étudiants afin de promouvoir son apprentissage auprès de ceux-ci. Le but est de résoudre un problème d’algorithmique avec un programme le plus rapide possible, et où la parallélisation joue un rôle très important.

Avec l'avènement des processeurs multi-coeurs et bientôt de l'informatique pluri-coeur, penser et développer ses logiciels en prenant en compte ce paradigme est essentiel pour tirer pleinement parti de la performance offertes par ces nouvelles évolutions. Il est nécessaire de repenser les algorithmes et les méthodes de développement que cela soit pour le HPC ou les logiciels grand public.

Afin de mettre les étudiants dans les meilleures conditions, il leur sera proposé de manière optionnelle  de télécharger gratuitement les outils de programmation Intel dédiés à la programmation parallèle, ainsi que les nombreux cours gratuits sur le sujet.

La dernière version du concours avait réunie 660 participants de plus de 30 pays différents  qui avaient pour la plupart échangé sur les forums avec nos ingénieurs  afin d’améliorer leur code et d’en apprendre un peu plus sur le sujet. Du 16 avril au 16 mai 2012, inscrivez-vous et votre classe et apprenez une nouvelle technique de programmation en échangeant avec les spécialistes Intel et une large communauté internationale

Participez en solo ou avec votre classe  prouvez votre valeur, et repartez  peut être avec un des 12 Ultrabooks mis en jeu!

Plus d'informations :

Page d'accueil du concours: http://intel.ly/AYC2012

Le site académique d’Intel : http://intel-software-academic-program.com/courses/index.html

Java : des extensions pour la programmation parallèle

Soumis par fredericmazue le

Des chercheurs de l'université de l'Illinois, à Urbana-Champaign, ont développé des extensions au langage Java destinés à prévenir les problèmes usuels du développement d'applications parallèles.

Distribué sous licence open-source, Deterministic Parallel Java (DJP) aide les développeurs à prévenir les bugs dûs à la programmation parallèle, en plein essor avec le passage massif de l'informatique aux processeurs multi-coeurs.

Source et plus d'informations : www.developpez.com

Le multicore, la programmation parallèle et le développeur Pourquoi penser parallèle ?

Soumis par fredericmazue le

Nous vous invitons à découvrons notre nouveau livre blanc "Le multicore, la programmation parallèle et le développeur Pourquoi penser parallèle ?", écrit par François Tonic pour Intel. Ce livre blanc est accessible de notre page dédiée Intel.

Formation Intel Microsigma -- Programmation parallèle

Soumis par fredericmazue le

MicroParallélisez vos applications C++ ou Fortran , une formation pratique 2 jours à Paris - 2 & 3 Juin 2010

Techniques et Outils de Programmation Intel® pour le multicore

Utilisez la programmation parallèle avec les outils Intel® spécialement conçus pour le multicore pour profiter de la puissance des derniers processeurs Intel

Pourquoi passer au parallèle ?

  • Utiliser les ressources des processeurs multicore
  • Améliorer les performances des applications
  • Vos concurrents l'ont déjà fait ou vont le faire

Pour démarrer participez à la prochaine formation "hands-on" les 2 et 3 Juin 2010.

Un portable Intel dual-core par stagiaire avec les outils de programmation parallèle Intel installés dans Visual Studio 2008 pour réaliser plus de 10 ateliers pratique.

Formation sous forme de sessions théoriques alternées avec les ateliers pratique en français. La présentation des techniques de mise en oeuvre des outils Intel, de l'intégration d'OpenMP et de Thread Building Blocks dans les applications sera suivie d'une analyse des résultats d'exécution. Les outils mis en oeuvre sont : compilateurs Intel C++ et Fortran, Thread Checker, Thread Profiler et VTune.

Inscrivez-vous dès maintenant car les places sont limitées à 10 participants. Le prix de cette formation est de 990 € HT pour 2 jours de formation. (Ce prix comprend les 2 repas du midi et la mise à disposition d'un ordinateur laptop dual core avec les outils Intel par personne, convention de formation sur demande, financement FAFIEC possible).

Objectifs :

A l'issue de cette formation les participants sauront

  • mettre en oeuvre les options de compilation principales, utiliser OpenMP et/ou Thread Building Blocks pour programmer parallèle, et les mettre en oeuvre.
  • exploiter les fonctionnalités d’optimisation des compilateurs Intel® C++ et Fortran, et outils annexes, comme l’incorporation de l’auto parallélisation et le support d’Open MP* et/ou Thread Building Blocks pour améliorer les performances des applications sur du multi-core.
  • lancer et utiliser les compilateurs C++ et Fortran, Thread Checker, Thread Profiler et VTune dans Visual Studio.

Pré-requis : Programmation C++ ou Fortran.

Le Lieu :

Espace Vinci, 25 rue des Jeûneurs 75002 Paris

Metro Bourse ou Grands Boulevards, Parking Bourse

Inscriptions

Formation aux Techniques et Outils de Programmation Intel pour le multicore

Soumis par fredericmazue le

Une formation pratique 2 jours pour apprendre à parallélisez vos applications C++ ou Fortran

Une formation sous forme de sessions théoriques alternées avec les ateliers pratiques en français. La présentation des techniques de mise en oeuvre des outils Intel, de l'intégration d'OpenMP et de Thread Building Blocks dans les applications sear suivie d'une analyse des résultats d'exécution. Les outils mis en oeuvre sont : compilateurs Intel C++ et Fortran, Thread Checker, Thread Profiler et VTune.

Objectifs :

A l'issue de cette formation les participants sauront

  • mettre en oeuvre les options de compilation principales, utiliser OpenMP et/ou Thread Building Blocks pour programmer parallèle, et les mettre en oeuvre.
  • exploiter les fonctionnalités d’optimisation des compilateurs Intel® C++ et Fortran, et outils annexes, comme l’incorporation de l’auto parallélisation et le support d’Open MP* et/ou Thread Building Blocks pour améliorer les performances des applications sur du multi-core.
  • lancer et utiliser les compilateurs C++ et Fortran, Thread Checker, Thread Profiler et VTune dans Visual Studio.

Pré-requis : Programmation C++ ou Fortran.

Le Lieu :

Espace Vinci, 25 rue des Jeûneurs 75002 Paris

Dates :

16 et 17 mars 2010

Inscrivez-vous dès maintenant car les places sont limitées à 10 participants. Le prix de cette formation est de 990 € HT pour 2 jours de formation. (Ce prix comprend les 2 repas du midi et la mise à disposition d'un ordinateur laptop dual core avec les outils Intel par personne, convention de formation sur demande, financement FAFIEC possible).

Inscrivez-vous

Formation Intel MicroSigma pratique 2 jours : Programmation parallèle

Soumis par jean le

29 et 30 Sept 2009 à Paris

Techniques et Outils de Programmation Intel® pour processeurs multicore

Suite au succès des 4 dernières formations organisées à Paris depuis 2008 par MicroSigma, et à la demande des participants pour des sessions de formation encore plus poussées, le distributeur  organise la prochaine formation "hands-on" les 29 et 30 septembre 2009..

Votre participation à ces deux journées sur l’utilisation des outils de développement Intel vous aidera à maximiser les performances de vos applications sur les processeurs multi-core.

Un portable Intel® duo-core à disposition par stagiaire, avec les outils Intel® pour le Multi-Core et la programmation parallèle installés dans Visual Studio

Cette formation avec des ateliers pratiques abordera la programmation parallèle et la mise en oeuvre de Thread Checker™, Thread Profiler et VTune™ dans le contexte d'une programmation C++ et Fortran avec les compilateurs Intel sous Visual Studio.

Attention : Les places sont limitées à 12 participants, inscrivez-vous vite !

Renseignements et inscriptions :

http://www.microsigma.fr/seminaires/FormationIntel090929web.html

Lieu : Espace Vinci, 25 rue des Jeûneurs  - 75002 Paris  (Metro: Bourse ou Grands Boulevards -  Parking: Bourse)


Etes vous QuadCore Ready ?

Soumis par fredericmazue le

Suite au succès des 4 dernières formations organisées à Paris depuis 2008 et à la demande des participants pour des sessions de formation encore plus poussées, Micro Sigma organise la prochaine formation "hands-on" les 17 et 18 juin 2009.

Votre participation à ces deux journées sur l’utilisation des outils de développement Intel vous aidera à maximiser les performances de vos applications sur les processeurs multi-core.

Cette formation avec des ateliers pratiques abordera la programmation parallèle et la mise en oeuvre de Thread Checker™, Thread Profiler et VTune™ dans le contexte d'une programmation C++ et Fortran avec les compilateurs Intel sous Visual Studio.

Ces deux jours seront animés par

• Michèle Delsol (Directeur Technique de Micro Sigma)
• Xavier Michaud (Directeur Commercial de Micro Sigma)

Formation sous forme de sessions théoriques alternées avec les ateliers pratiques en français. Elles seront dédiées à la présentation des techniques de mise en oeuvre des outils Intel, de l'intégration d'OpenMP et de Thread Building Blocks dans les applications, et d'une analyse des résultats d'exécution. Les outils mis en oeuvre seront : compilateurs Intel C++ et .

Inscrivez-vous dès maintenant car les places sont limitées à 15 participants. Le prix de cette formation est de 790 € HT pour 2 jours de formation. (Ce prix comprend les 2 repas du midi et la mise à disposition d'un ordinateur laptop duo core avec les outils Intel par personne, convention de formation sur demande, financement FAFIEC possible).

Le Lieu :
Espace Vinci, 25 rue des Jeûneurs 75002 Paris

Objet de la formation :
Programmation C/C++ et Fortran avec les outils Intel sur multicore Windows, Linux et Mac. (Formation pratique sous Windows/Vista)

Objectifs :
Découvrir et comprendre les outils nécessaires pour effectuer une programmation parallèle efficace pour les performances de l'application et les temps de développement via une connaissance des outils Intel (Compilateurs C/C++ et Fortran, Intel Thread Checker, Intel Thread Profiler et VTune) et une présentation des outils de parallélisation portables OpenMP (C++ et Fortran) et Thread Building Blocks (C++). A l'issue de cette formation les participants sauront mettre en oeuvre les options de compilation principales, utiliser OpenMP et/ou Thread Building Blocks pour programmer parallèle, et mettre en oeuvre les trois outils Thread Checker, Thread Profiler et VTune.

Pré-requis :

Programmation C++ ou Fortran.

Agenda :

• Compilateurs Intel - maîtrisez les options de compilation. Avant de programmer parallèle, optimiser le code. Mise en oeuvre de la vectorisation pour exploiter du parallélisme sur les données même sur applications monothread.
• OpenMP - présentation des directives/pragmas de compilation. Cette présentation sera complétée par une mise en oeuvre pratique.
• Thread Building Blocks - présentation des classes C++ de parallélisation. Comme pour OpenMP il y aura également des ateliers pratiques de mise en oeuvre.
Intel Thread Checker - présentation. La parallélisation est truffée de pièges difficiles à déceler. Thread Checker trouvera la plupart.
• Intel Thread Profiler - présentation. Les problèmes de parallélisation étant réglés à l'aide de Thread Checker, les participants utiliseront Thread Profiler pour optimiser l'utilisation des cores.
• VTune Performance Monitor - Jusqu'à présent, les programmeurs avaient une attitude boîte noire quant à l'utilisation du processeur. Mais il s'avère qu'une analyse de la mise en oeuvre spécifique par l'application reflète une programmation peu efficace. Via quelques aménagements peu coûteux en temps d'analyse et de programmation, il peut s'avérer que des gains de performance allant jusqu'à 50%, voir plus peuvent être obtenus.

Modalités de la formation :

• Cette formation de deux jours s'appuiera sur la présentation des outils, plus de 10 ateliers pratiques sur machines Duo Core mises à disposition des participants et support de cours correspondant.

Lors de ces deux jours exceptionnels d'un total de 16 heures vous pourrez disposer d'un PC et utiliser les compilateurs Intel ainsi que les outils Thread Checker, Thread Profiler et VTune. Vous apprendrez comment les mettre en oeuvre et comment les utiliser pour paralléliser et améliorer les temps d'exécution de votre code.

Avec ces deux journées de formation en français vous pourrez beaucoup plus rapidement exploiter les fonctionnalités d’optimisation des compilateurs Intel® C++ et Fortran, et outils annexes, comme l’incorporation de l’auto parallélisation et le support d’Open MP* et/ou Thread Building Blocks pour améliorer les performances des applications sur du multi-core. Vous apprendrez également comment lancer et utiliser les compilateurs C++ et Fortran, Thread Checker, Thread Profiler et VTune sous Visual Studio.

Inscrivez-vous dès maintenant

Intel Software Conference : Développeurs, adoptez le multicore !

Soumis par francoistonic le

Une journée de sessions, d’explications pour convaincre de l’intérêt de passer à la programmation parallèle. C’était l’ambition de l’Intel Software Conference qui s’est tenue le 21 avril à Salzburg et où Programmez ! était bien évidemment présent.

Le mot d’ordre est : parallélisation du code, d’où de nombreux explications et démonstrations autour de Parallel Studio, la suite d’outils d’Intel pour le tuning, pour optimiser et debugguer le code parallèle. Un des focus de la journée fut de montrer l’intégration de Parallel Studio dans Visual Studio qui va simplifier la vie du développeur parallèle.

Cependant, si l’outil simplifie le travail, il ne le rend pas forcément plus trivial au quotidien. Le fondeur a bien précisé que ce n’est pas un outil miracle. Le développeur doit apprendre et maîtriser les librairies, les outils, les techniques de la programmation parallèle. Mais aussi bien Microsoft que Intel veulent évangéliser pour le plus grand nombre de développeurs alors qu’à peine 3 % d’entre eux ont utilisé des fonctions parallèles ces 6 derniers mois.

Pas d’annonces ou de sorties durant la conférence mais plusieurs éléments intéressants. Le premier sera la disponibilité d’un nouveau module Advisor courant 2010. Autre informatique intéressante : plusieurs fonctions de Parallel Studio se retrouveront dans les autres outils d’Intel comme vTune, ce qui est une bonne nouvelle. Par contre, il n’est pas (encore ?) prévu de sortir Parallel Studio sur Linux ou Eclipse…

Mais au-delà de la parallélisation du code, Intel travaille sur d’autres aspects tout aussi intéressants comme la parallélisation des données, un peu comme on peut le faire avec PLinq mais aussi niveau natif. Il s’agit de la technologie Ct dont une bêta publique sera disponible fin 2009. Les premières implémentations devraient apparaître courant 2010.