SGBD

Relate : Neo4j lance une base de données in-memory pour les agents IA

Soumis par francoistonic le
Image
Relate

Selon les prévisions de Gartner, “Les utilisateurs-machines représenteront 75 % des charges de travail des systèmes de gestion de bases de données (SGBD) d’ici 2029, contre 10 % en 2025. Alors que les premières adoptions de l’IA en entreprise se concentraient principalement sur des assistants conversationnels simples, destinés à la recherche et à la synthèse d’informations, les charges de travail et les investissements s’orientent aujourd’hui vers des systèmes autonomes plus avancés, capables de planifier, d’exécuter et de coordonner de manière indépendante des opérations complexes. Apparaît alors une nouvelle catégorie de consommateurs de ressources informatiques. Car ces agents d’IA génèrent entre 10 et 100 fois plus d’interactions avec les bases de données que les opérateurs humains, entraînant une forte augmentation du nombre de connexions simultanées. Cette évolution entraîne une forte hausse des besoins en calcul, en stockage et en traitement des données, poussant les entreprises à renforcer leurs infrastructures informatiques et à accroître leurs investissements dans les systèmes de gestion de bases de données”.

Relate a été conçue dès l’origine comme une base de données en mémoire à très faible latence, spécifiquement adaptée au fonctionnement des agents d’IA.

Disponible en open source sous licence Apache 2.0, Relate permet aux agents d’IA d’exploiter le raisonnement à plusieurs étapes et GraphRAG pour fournir des réponses plus précises et limiter les risques d’hallucinations. La base de données a été conçue spécifiquement pour les cycles d’exécution des agents autonomes. Elle détecte automatiquement les environnements d’exécution des agents et renvoie des erreurs structurées, accompagnées d’indicateurs explicites précisant si une nouvelle tentative est possible. Ces indicateurs permettent aux agents de gérer les exceptions et de corriger eux-mêmes leurs erreurs, sans avoir à développer de mécanismes spécifiques pour les interpréter.

Site : https://github.com/relatedb/relate


Réduire l’empreinte des vecteurs : la quantification vectorielle partie 1

Soumis par francoistonic le
Image

Dossier de Han HELOIR, EMEA Gen AI Solutions Architect (MongoDB)

Introduction : la révolution des embeddings et ses défis cachés

L’intelligence artificielle générative, notamment à travers le Retrieval-Augmented Generation (RAG), révolutionne la gestion des données en combinant la puissance des modèles génératifs avec des bases de connaissances structurées. Cette approche permet d’automatiser des tâches complexes tout en accédant en temps réel à des informations précises et pertinentes provenant de multiples sources. 

Au cœur de ces systèmes se trouvent les embeddings, des vecteurs mathématiques capables de représenter des données non structurées telles que des textes, des images, ou des vidéos. Ces vecteurs permettent de réaliser des tâches avancées comme les recherches sémantiques, les recommandations, ou encore l’analyse de similarité.

Cependant, derrière l’innovation se cache une complexité technique. Lors de la phase de PoC (Proof of Concept), la gestion des embeddings peut sembler relativement simple. Mais une fois en production, ces vecteurs deviennent une source importante de coûts, de latence, et de problèmes d’évolutivité. En effet, leur stockage, leur traitement, et leur recherche à grande échelle exigent des infrastructures coûteuses et complexes.

Dans cet article, nous explorons comment la quantification vectorielle, associée à des techniques de l’indexation comme HNSW(Hierarchical Navigable Small World), peut réduire significativement ces obstacles. Ces approches permettent de maintenir des performances élevées tout en rendant la scalabilité plus accessible.

Les défis techniques des embeddings en production

1. Explosion des coûts de stockage

Chaque embedding est une représentation numérique haute dimension, souvent en format float32. Cela signifie que chaque élément du vecteur utilise 32 bits de mémoire. Multipliez cela par des millions, voire des milliards d’embeddings, et vous obtenez des volumes de données astronomiques.

Prenons un exemple concret : une base contenant 250 millions d’embeddings, chacun ayant 1 024 dimensions. En format float32, cette base occuperait 7,5 To d’espace et coûterait environ 3 600 $ par mois sur une plateforme comme AWS. À cela s’ajoutent les frais pour les sauvegardes, la redondance, et la haute disponibilité. Ces coûts deviennent rapidement prohibitifs, notamment pour des start-ups ou des projets avec des budgets limités.

Embeddings et le coût associé (Source: HuggingFace)

2. Latence accrue et surcharge computationnelle

Les embeddings ne se limitent pas au stockage ; ils doivent également être interrogés pour effectuer des recherches rapides et précises. Ces recherches, appelées recherches de voisins les plus proches (Nearest Neighbor Search), nécessitent des calculs dans des espaces vectoriels de haute dimension. Chaque vecteur doit être comparé à d’autres pour déterminer les éléments les plus similaires.

Plus les vecteurs sont longs (haute dimension) et plus la base de données est volumineuse, plus la recherche devient longue. Cela pose un problème critique dans les applications en temps réel, où les utilisateurs s’attendent à des réponses quasi instantanées. Par exemple, une application de recommandations doit répondre en moins de 300 millisecondes pour maintenir une expérience utilisateur satisfaisante. Une recherche trop lente peut entraîner une frustration des utilisateurs et une perte de clients.

3. Scalabilité limitée

À mesure que le nombre d’utilisateurs et de données augmente, les exigences en calcul et en mémoire explosent. Cela entraîne des frais supplémentaires en matériel (serveurs, RAM) et en infrastructure cloud, créant un goulot d’étranglement financier. Les entreprises sont alors confrontées à un dilemme : réduire la qualité du service ou augmenter leurs dépenses.

HNSW : Une indexation intelligente pour les recherches rapides

1. Une structure hiérarchique

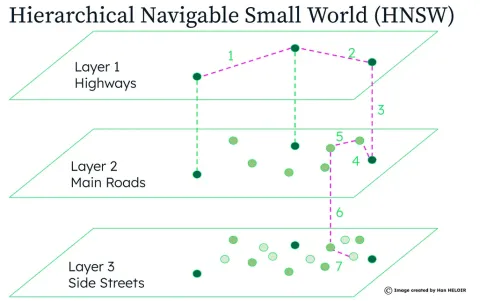
HNSW (Hierarchical Navigable Small World) est une méthode d’indexation conçue pour accélérer les recherches dans des bases vectorielles. Contrairement à une recherche linéaire, qui comparerait chaque vecteur à l’ensemble des autres, HNSW construit un graphe multi-niveaux pour organiser les données de manière plus efficace.

Ce graphe hiérarchique fonctionne comme une carte routière :

-        Niveau supérieur : Les autoroutes, qui permettent de parcourir rapidement de grandes distances.

-        Niveaux intermédiaires : Les routes principales, qui affinent la recherche.

-        Niveau le plus bas : Les petites rues, qui mènent aux résultats finaux.

En utilisant cette approche, HNSW réduit drastiquement le nombre de comparaisons nécessaires pour trouver les voisins les plus proches d’un vecteur, tout en garantissant une recherche rapide et précise.

2. Avantages et limitations

HNSW est particulièrement efficace car il :

-        Réduit les temps de recherche, même dans des bases massives.

-        Permet des mises à jour incrémentielles (ajout de nouveaux vecteurs sans reconstruire tout l’index).

Cependant, cette méthode exige une grande quantité de RAM, car le graphe doit être entièrement chargé en mémoire pour offrir des performances optimales. C’est ici que la quantification vectorielle devient essentielle, car elle réduit la taille des vecteurs et, par conséquent, les besoins en mémoire.
SQL Server 2008 r2 en 2010

Soumis par francoistonic le

Après Windows 7, Windows Server 2008 r2, voici maintenant la prochaine version majeure de SQL Server 2008, la base de données de Microsoft : la r2. Connue jusqu’à présent sous le nom de code Kilimandjaro, cette version n’aura pas de nouveau millésime. Une pré-version technique, CTP, est désormais disponible. La montée en charge, l’administration seront deux focus importants de cette version ainsi que le très attendu nouveau module de Business Intelligence, un modèle de reporting entièrement revu et corrigé. Cette version intégrera les nouveautés présentées en 2008 : Gemini pour l’intégration Excel – OLAP, Synthesis pour la gestion cluster et le déploiement, Madison pour une meilleure gestion temps réel des événements, le support de plus de 64 processeurs logiques.

Cette version sera disponible courant 2010, la date n’est pas précisée.

SGBD : de Firebird 2.1 à 3.0

Soumis par francoistonic le

Attendue depuis des mois, la base de données Firebird arrive en version 2.1 (disponible sur Windows, Linux, MacOS X, etc.). Cette mouture apporte de nombreuses nouveautés : possibilité de faire des triggers sur les bases, création de tables temporaires, requêtes récursives, support du 64 bits (Windows / MacOS X), monitoring de la base par SQL, interface distante…

À noter que le projet lance d’ores et déjà une alpha de sa future version 2.5. Cette édition doit conforter et étendre les nouveautés de la 2.1, offrir des extensions de monitoring, de nouvelles fonctions, la possibilité de faire des procédures externes en Java (sous réserve). Cette version est censée arriver durant le 3e trimestre. Enfin, les premières réflexions autour de la v3 commencent déjà (alpha prévue fin de l’année) : architecture unifiée, multithreading amélioré et optimisé avec un cache partagé, nouvelles fonctions SQL, requête multi base de données.

Linagora s’impose sur les bases de données

Soumis par francoistonic le

Le français Linagora continue de s’étendre et souhaite s’attaquer au marché américain, particulièrement actif et bien plus structuré que le marché français. Il y a quelques jours, la société a signé un accord stratégique avec EnterpriseDB, un des leaders des bases de données open source (PostgreSQL). Pour EnterpriseDB il s’agit de s’étendre en Europe et notamment sur les marchés francophones. Linagora apportera le support technique, les services professionnels, les formations pour PostgreSQL Plus et PostgreSQL Plus Advanced Server. De fait, Linagora devient revendeur de cette base de données, réputée par sa robustesse. L’accord a été exposé lors d’une soirée spéciale à Paris devant la presse informatique avec les représentants légaux des sociétés et Talend qui a aussi signé un partenariat avec EnterpriseDB. Cet accord permet aux utilisateurs EnterpriseDB d’accéder aux outils ETL de Talend.

Continuant sur sa lancée, Linagora sera présent à la Ingres Partner Summit à Pragues. « Nous sommes heureux de rallier la Communauté Ingres en tant que Partenaire stratégique. Ingres, reconnu depuis des décennies dans le monde du logiciel est devenu aujourd'hui un acteur incontournable dans le domaine de l'open source. Nous collaborons d'ores et déjà sur des projets significatifs en France et développons, grâce à l'écosystème Ingres, des opportunités d'affaires à l'international », souligne Alexandre Zapolsky, Président directeur général du Groupe LINAGORA.

Sun rachète MySQL et devient un poids lourd de la base de données

Soumis par francoistonic le

Qui l’aurait cru il y a quelques heures encore ? L’annonce surprise du rachat de MySQL par Sun bouleverse singulièrement le marché de la base de données. Le coût de l’opération s’élève à un milliard de dollars pour Sun. Pour l’éditeur, il s’agit de prendre position sur un marché important pesant plus de 15 milliards et surtout de se mesurer aux autres géants que sont Oracle, IBM et Microsoft. MySQL est devenu en quelques années, un acteur incontournable de la base de données et préparait activement la version 6.0 de son SGBD, devant sortir à la fin de l’année. Pour Sun, ce rachat est un moyen de renforcer sa place au sein du monde Open Source. D’autre part, l’ajout de MySQL dans les gammes « logiciels » de l’éditeur peut permettre à Sun de renforcer ses ventes de serveurs et de toucher un grand nombre de développeurs et d’utilisateurs. Reste à savoir comment MySQL trouvera sa place chez Sun.

La transaction devrait être terminée vers septembre – octobre.

On assiste ainsi à la poursuite d’une certaine concentration des poids lourds de l’open source après le rachat de JBoss par Red Hat.

L’avis de Thomas Petazzoni (April).
« Tout d'abord, ce rachat confirme une nouvelle fois la stratégie de Sun en direction du Logiciel Libre : la suite bureautique OpenOffice.org, la machine virtuelle et le langage Java, le système d'exploitation OpenSolaris, le serveur d'applications Glassfish. L'April ne peut que se féliciter d'une telle stratégie, notamment de la part d'une entreprise membre de l'association. D'autre part, ce rachat, pour un montant d'un milliard de dollars, confirme la viabilité du modèle économique de MySQL, basé sur la distribution gratuite de la version libre sous licence GPL de son produit, et sur la commercialisation d'une version sous une autre licence pour les entreprises souhaitant développer des applications propriétaires basées sur MySQL. Ce modèle économique de double licence, également retenu par la société Trolltech pour la bibliothèque Qt, est un des modèles étudiés par le Livre Blanc sur les modèles économiques du Logiciel Libre, publié par l'April au mois de décembre. »

Talend lance officiellement la v2.2

Soumis par francoistonic le

L’éditeur open source d’intégration de données, Talend, vient de lancer la version 2.2 de son environnement Talend Open Studio, ainsi que d’Activity Monitoring Consol/Personnal Edition. L’éditeur indique que 100 000 utilisateurs ont téléchargé l’outil d’intégration. La v.2 prend mieux en compte SOA, introduit de nouveaux connecteurs et assure la gestion de procédures stockées Oracle, SQL Server, Ingres, MySQL, DB 2.

La partie monitoring est un axe important pour l’éditeur. Il centralise le contrôle de l’exécution distribuée des jobs d’intégration de données et permet de créer des rapports et alertes. On peut ainsi finement analyser l’exécution et identifier les éventuels problèmes. « Grâce à la nouvelle console Activity Monitoring Console/Personal Edition, les entreprises sont en mesure de s’affranchir des limites de la surveillance des jobs individuels, en bénéficiant d’une maintenance simplifiée, de seuils d’alerte et de la possibilité d’analyser des tendances » déclare Fabrice Bonan, co-fondateur et Directeur Général de Talend. Activity Monitoring Console/Personal Edition est disponible en souscription annuelle incluant les services de support technique.

Pervasive renforce son SGBD embarqué

Soumis par francoistonic le

L’éditeur a dévoilé la version 10 de son PSQL Summit. Il s’agit d’un SGBD embarqué. Non disponible pour l’utilisateur final, cette solution vise les ISV, VAR et autres intégrateurs pour incorporer une base de données embarquée de taille réduite. Cette version apporte plusieurs nouveautés intéressantes : compatibilité avec Windows Vista (le support de Windows Server 2008 est déjà en cours), support du 64-bit, support du Xtreme I/O. Il s’agit d’un système d’entrée / sortie haute performance pour les gros débits. Sur SQL, on bénéficie d’une extension de syntaxe pour assurer une meilleure compatibilité avec les applications SQL. Pour migrer et déployer plus rapidement, Pervasive a pris les technologies d’installation d’InstallShield, une référence du marché. Une version est disponible gratuitement sur le site de l’éditeur.
www.pervasive.com

MySQL fait son show en France

Soumis par francoistonic le

Pour la première fois, MySQL va organiser une conférence. Elle aura lieu le 23 octobre à Paris sur le thème « Scaling the modern enterprise ». En bref, tout pour pouvoir optimiser son SGBD en entreprise. Alcatel-Lucent, Skyblog et le Crédit Mutuel viendront présenter leurs techniques, leurs expériences. Il sera aussi possible de rencontrer des experts pour parler technique, problématique de performances, etc.

Durant la conférence vous pourrez:
- Découvrir comment tirer au mieux parti de MySQL
- Bénéficier de conseils d'experts sur l'optimisation des performances
- Assimiler les meilleures pratiques MySQL
- Découvrir les nouvelles fonctionnalités et services pour mieux planifier vos déploiements de MySQL
- Mieux comprendre comment sélectionner la solution de haute disponibilité pour MySQL la plus adaptée à vos besoins
- Poser toutes vos questions aux experts MySQL, et avoir l'opportunité de faire part de votre feedback et de vos commentaires
- Nouer des relations avec l'équipe de MySQL AB
- Découvrir comment vous pouvez bénéficier des solutions de leurs partenaires

L’événement aura lieu à l’hôtel Sofitel Le Parc de 9h à 18h.

SQLBase arrive en version 11

Soumis par francoistonic le

L’éditeur Unify vient d’annoncer la disponibilité de la version 11 de son SGBD maison : SQLBase. L’environnement prend désormais pleinement en charge les portables comme s’il s’agissait d’un serveur. Un module de mise à jour automatique est aussi disponible, ainsi qu’une génération de clé automatique. D’autre part, on bénéficie de nouveaux algorithmes de verrouillage, ce qui est très utile en transactionnel et reporting. SQLBase 11 est disponible sous Windows (Vista inclus) et Linux. Version d’évaluation disponible gratuitement.
