Unicode

Unicode 18 : 13 007 nouveaux caractères

Soumis par francoistonic le
Image

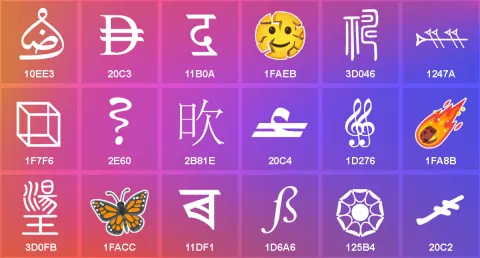
Quand Unicode décide de mettre à jour les caractères et symboles, il voit grand. Avec la version 18, 13 007 nouveaux caractères apparaissent pour un total de 172 808. Plusieurs nouvelles monnaires sont disponibles.

Le projet précise : "Chacun de ces symboles a été autorisé pour un usage public par l'autorité monétaire compétente il y a plus d'un an, mais son utilisation était freinée par l'absence d'un encodage standardisé. Avec la publication d'Unicode 18.0, les fournisseurs peuvent désormais prendre en charge ces symboles." Le groupe écriture sigilaire historique rassemble le plus de nouveautés. Aucun nouvel algorithme n'a été ajouté mais 3 nouveaux scripts apparaissent : proto-cunéiforme, Jurchen, les sceaux. Les nouveaux fichiers sont JurchenSources et SealSources. 

Tous les détails : https://www.unicode.org/versions/Unicode18.0.0/

Le consortium Unicode publie ICU4X 1.0, une bibliothèque d'internationalisation écrite en Rust

Soumis par fredericmazue le

Le Consortium Unicode, après 2 ans et demi de travail auquel ont participé Google, Mozilla, Amazon et les partenaires de la communauté, publie la bibliothèque ICU4X 1.0.

Cette bibliothèque écrite en Rust a été conçue à partir de zéro pour être légère, rapide, portable et sécurisée. Le Consortium unicode souligne que ICU4X tire les leçons de décennies d'expérience pour apporter un formatage de date localisé, un formatage de nombre, un classement, une segmentation de texte, etc. à des appareils qui, jusqu'à présent, n'avaient pas de solution appropriée.

ICU4X est la première bibliothèque d'Unicode à prendre en charge le découpage de données statiques et le chargement de données dynamiques. Avec ICU4X, les applications clientes peuvent inspecter leur code compilé pour créer facilement de petits packs de données de paramètres régionaux optimisés, puis charger ces packs de données à la volée, permettant aux applications de s'adapter à plus de langues que jamais auparavant. Même lorsque la plate-forme i18n est disponible, ICU4X convient comme polyfill pour ajouter des fonctionnalités ou des langues supplémentaires.

En ce qui concerne la portabilité, ICU4X prend en charge plusieurs langages de programmation prêts à l'emploi. ICU4X peut être utilisé nativement dans le langage de programmation Rust, avec des wrappers officiels en C++ via l'interface de fonction étrangère (FFI) et JavaScript via WebAssembly. Plus de langages de programmation peuvent être ajoutés en écrivant des plugins, sans avoir besoin de toucher à la logique de base i18n. ICU4X permet également de mettre à jour les fichiers de données indépendamment du code, ce qui facilite le déploiement des mises à jour Unicode.

En ce qui concerne la sécurité, le Consortium Unicode souligne que le système de type et le modèle de propriété de Rust garantissent la sécurité de la mémoire et la sécurité des threads, empêchant ainsi de grandes classes de bogues et de vulnérabilités.

ICU4X ne cherche pas à remplacer ICU4C ou ICU4J, elle cherche plutôt à remplacer le grand nombre de bibliothèques i18n non Unicode, souvent non entretenues et souvent incomplètes qui ont été écrites pour apporter i18n à de nouveaux langages de programmation et à des environnements à ressources limitées.

ICU4X est un logiciel libre sous licence UNICODE, disponible sur GitHub. Un didactitiel pour sa prise en main est disponible sur GitHub également.
Maîtriser la programmation avec Unicode

Soumis par fredericmazue le

La programmation avec Unicode n'est pas un thème très sexy, que l'on aborde facilement. Mais tôt ou tard le développeur y est confronté.

Si vous devez apprendre à travailler avec Unicode, ce très intéressant billet vous aidera énormément.

Après une partie expliquant comment les caractères Unicode sont codés, et expliquant pourquoi UTF-8 est souvent le meilleur choix, le billet donne des exemples de programmatione en langage C avec la bibliothèque ICU, pour International Components for Unicode, une bibliothèque mature et portable, souligne le billet.

ICU supporte des API C, C++ et Java, mais les auteurs ont choisi le langage C pour leurs exemples car ils estiment que cela apporte une meilleure vision des éléments internes. Toutefois ils précisent que les concepts expliqués sont facilement applicables au langage de votre choix.

MySQL 8.0 est en Release Candidate

Soumis par fredericmazue le
Image

L'équipe de développement de MySQL vient d'annoncer la disponibilité de MySQL 8.1 en Release Candidate. Une mouture qui rend MySQL meilleur pour les applications modernes, souligne le billet d'annonce.

Une application moderne est avant tout une application mobile, explique l'équipe de développement, c'est-à-dire une application qui tient compte de la localisation de son utilisateur et du fait qu'il faut réduire au maximum le nombre de clics qu'il doit effectuer. Sur cette base, MySQL apporte de nombreuses nouveautés, dont voici les plus remarquables selon nous.

Un support JSON amélioré

L'usage de JSON, qui est au départ le format de données pour le langage JavaScript, tend à généraliser, d'où l'importance de soigner son support pour l'équipe de MySQL. Ainsi arrive une fonction permettant de vérifier la taille, en terme d'espace disque, d'une données JSON. Arrivent des fonctions qui permettent d'agréger des tableaux et des objets, et arrive le support des plages de données (ranges). Ce qui permet d'extraire des éléments précis d'un tableau. Par exemple :

Du NoSQL dans MySQL

Le Document Store, introduit avec MySQl 7.5, permet de travailler avec des API NoSQL pour la lecture, l'écriture, la modification et l'effacement des données, tout en gardant la consistance des données. Le développeur n'est pas obligé d'abandonner SQL pour autant, car il reste possible d'accéder aux données du Docuement Store par ce moyen.

Unicode 9

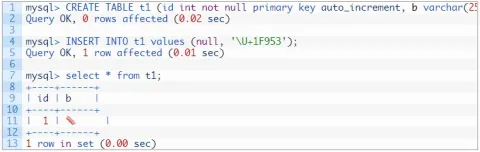
Avec l'internationalisation des applications, l'usage d'Unicode, et en particulier d'UTF-8, tend à se généraliser. MySQL 8.0 supporte le dernier standard Unicode 8 et laisse tomber (enfin...) latin1 comme jeu de caractères par défaut. Le jeu de caractères par défaut est désormais utf8mb4. Désormais, vos résultats de requêtes peuvent afficher des émojis :-)

Google Noto : une police open source pour 800 langues, connaissant les 110 000 caractères Unicode

Soumis par fredericmazue le
Image

Tous ceux qui partagent des documents écrits dans des langues étrangères ont rencontré le 'Tofu', ce petit carré qui est affiché par défaut en remplacement d'un caractère non reconnu par la police utilisée pour lire le document.

Les tofus nuisent à la communication, voire l'empêchent totalement, quand les documents sont écrits dans une langue très exotique, ceci dit d'un point de vue occidental.

Dans le contexte de la mondialisation que nous connaissons, ce problème se devait d'être résolu, et Google, qui l'a rencontré pour ses smartphones Android, s'y est attelée.

Après 5 ans de travaux, et en collaboration avec des experts du sujet, tels que Monotype ou Adobe, Google annonce dans un communiqué la sortie de la police Google Noto.

Il s'agit d'une police open source True Type, sous licence Open Font License (OFL). Elle s'appelle Noto pour No Tofu :-). Elle prend en charge 800 langues et les 110 000 caractères Unicode actuellement standardisés.

La Police vient en un peu plus de 180 fichiers pour couvrir tous les cas particuliers, comme les caractères qui changent en fonction du texte qui suit, par exemple en Arabe, ou les caractères réordonnés, séparés en deux ou fusionnés comme pour les langues indiennes, par exemple le Bengali ou Sanscrit.  

La police peut être téléchargée depuis son site officiel. Les sources sont déposés sur GitHub.

Chacun peut utiliser cette police, y compris pour des applications commerciales, ou la modifier, à condition de placer les modifications sous l'Open Font License.

[video:https://vimeo.com/185700918 autoplay:0]

Google place sa police Roboto en open source

Soumis par fredericmazue le

Roboto est la police de caractères par défaut d'Android et de Chrome OS. Google l'a créée en 2011 pour Android 4.0, alias Ice Cream Sandwich. Roboto était alors placée sous licence Apache 4.0.

Dans un billet Google annonce que désormais Roboto est un projet complètement open source. Non seulement Roboto est open source, mais la chaîne d'outils utilisée pour la créer l'est aussi.

Roboto elle-même est améliorée, avec la prise en charge de nouveaux caractères Unicode. Tous les caractères latins, cyrilliques et grecs d'Unicode 7.0 sont désormais couverts, ainsi que le symbole du Lari d'Unicode 8.0. Le Lari est le symbole de la devise monétaire géorgienne.  

 Le projet Roboto est sur GitHub.

Comment les pirates exploitent Unicode pour bidouiller les noms de fichiers

Soumis par fredericmazue le

L'éditeur AVAST a publié un rapport indiquant l'arrivée d'une nouvelle vague de mails malveillants qui utilisent habilement UTF-8 pour tromper les internautes en leur faisant croire qu'ils reçoivent en pièces attachées des fichiers inoffensifs.

L'idée est de montrer un nom de fichier trafiqué, et table sur le fait que les utilisateurs se fient trop aveuglément à la seule extension d'un nom de fichier. Un utilisateur peut ainsi penser recevoir une image s'il voit un nom de fichier avec une extension .jpg, alors qu'en fait il s'agit de tout autre chose.

Pour obtenir ce résultat, les pirates utilisent Unicode qui permet d'afficher des textes en format droite gauche, comme pour l'arabe ou l'hébreu, pour afficher la fin d'un nom, séparée de son début par des caractères invisibles, qui basculent l'affichage en mode "right-to-left". Le début du nom étant normalement affiché en gauche droite.

Ainsi un fichier dont le nom apparaît comme photo_D18727_Collexe.jpg sera en fait un fichier dont le nom est photo_D18727_Colljpg.exe. Et lorsque l'utilisateur ouvre le fichier pour tenter de visionner une image, c'est bien un exécutable qu'il lance, contenant un virus de préférence :-)

Forum PHP 2008 : gros succès

Soumis par francoistonic le
Web

On ne présente plus PHP et le Forum PHP qui s’est tenu cette semaine à Paris fut un grand succès, avec plus de 250 personnes par jour, plus qu’à l’édition 2007. L’accent a été mis sur les retours d’expérience avec plusieurs projets tels que Drupal, BNP ou encore 20Minutes. Cela démontre parfaitement la capacité de PHP à s’intégrer dans les gros projets.

Bien entendu la partie technique ne fut pas oubliée. Avec comme l’un des temps forts la présentation des grandes nouveautés de PHP 5.3 qui promet de changer pas mal de choses comme l’apparition de goto, des espaces de noms, une meilleure internationalisation. Cette version devrait arriver dans les prochains. Et la v6 ? Pas grand chose à se mettre sous la dent. La principale nouveauté sera de l’unicode de bout en bout mais actuellement, aucune liste précise des nouveautés, et encore moins la moindre de sortie… Occasion aussi de se rafraîchir la mémoire sur PHP et Eclipse !

Parmi les exposants, nous pouvions noter la présence d’un stand Oracle ! L’éditeur veut mieux s’insérer avec le monde PHP, car les clients le demandent. Oracle travaille déjà avec Zend mais cela ne devrait pas s’arrêter !