IA

DeepSeek : l'IA chinoise qui fait (un peu) trembler OpenAI

Soumis par francoistonic le
Image

Il y a un an, on pouvait lire ici et là, des prédictions sur la fin de ChatGPT qui sera remplacé par un autre service. La réalité est arrivée plus vite que prévue avec DeepSeek, un startup chinoise.

Cette IA / GenIA, repose sur :

- un modèle open source pour les LLM et le code source

- un investissement officiellement bien moindre que OpenAI et les autres même si nous ne connaissons pas tous les éléments

Le potentiel de DeepSeek, la diffusion de son app, une licence MIT pour son LLM, des tarifs plus accessibles pour les services payants, font que la startup chinoise fait trembler une partie de l'univers IA américain. Surtout, DeepSeek propose des tarifs bien plus faibles qu'OpenAI alors que les investissements vont être colossaux en 2025. La question est de savoir quelle est l'infrastructure derrière DeepSeek et comment les LLM chinois sont entraînés. Les milliards ne font pas tout ni la qualité d'une app ou d'une IA. La preuve. Des analystes prédisent déjà la fin des investissements monstres (Jefferies). 

Mais d'autres, tels que JPMorgan, soulèvent d'autres questions qui nuancent l'exploit : DeepSeek est financé par un important fonds chinois, High-Flyer. Ce dernier aurait permis à DeepSeek d'utiliser plus de 50 000 GPU NIVIDIA Hopper, soit grosso modo l'équivalent de l'infrastructure d'OpenAI. L'efficacité des LLM de DeepSeek vient forcément d'une inférence sur 10-12 mois et qu'une puissance de calcul est nécessaire pour le réaliser. Elon Musk ne dit pas autre chose : Évidemment, DeepSeek a bien plus de GPU NVIDIA qu'ils ne le disent. Officiellement, la startup affirme utiliser 10 000 GPU A100... 

Après, que DeepSeek baisse les tarifs, est-ce à dire que les infrastructures soient nécessairement moindres ? Ou alors, la startup mise sur la masse d'utilisateurs payants pour amortir les coûts, quitte à adopter une stratégie tarifaire agressive à perte.

Les restrictions sur l'exportation technologique des Etats-Unis poussent sans aucun doute les startups chinoises à chercher des contournements et des solutions techniques équivalentes. Il n'en fallait pas plus pour que NVIDIA chute fortement à Wall Street : - 13 %. Notons tout de même que l'IA de DeepSeek est soumise aux contraintes légales chinoises, notamment sur le domaine politique.

VLC : 6 milliards de téléchargement et IA

Soumis par francoistonic le

VLC est un des logiciels open source les plus populaires au monde. Au CES 2025, l'équipe de VLC a mis en avant le succès incroyable du lecteur vidéo : 6 milliards de téléchargement depuis sa création. L'outil montre aussi de nouvelles fonctionnalités sur la traduction et le sous-titrage. VLC mise sur le LLM et un traitement local pour générer automaniquement les sous-titres et pour les traductions dans une centaine de langues (à terme).

L'objectif est de réaliser le traitement uniquement local, sur la machine et non en utilisant un service cloud. On pouvait déjà réaliser le sous-titrage avec un plug-in tel que Whisper, là, l'avantage est une intégration native au logiciel.  

Pour le moment, aucune date de disponibilité n'est connue ni les LLM qui seront utilisés, ni les langues qui seront disponibles immédiatement. 

NVIDIA Project DIGITS : un ordinateur IA surpuissant dans un barebone

Soumis par francoistonic le

Il existe déjà des PC IA mais NVIDIA va bien au-delà en dévoilant le projet DIGITS. Le PC reprend le format barebone des Intel NUC et Mac Mini. DIGITS n'est pas un autre micro-ordinateur mais plutôt un HPC dédié à l'IA.

Il utilise un NVIDIA G10 Grace Blackweel, 128 Go de RAM, un stockage ultra rapide de 4 To. Le puce NVIDIA embarque une GPU de 1 petaflop de calculs et un CPU intégrant 20 coeurs ARM. DIGITS n'est pas là pour faire du jeu ou de la bureautique, il est taillé pour les LLM de 200 milliards de paramètres, faire de l'entrainement, développer des IA. Il sera possible de mettre en cluster plusieurs DIGITS pour pouvoir utiliser des LLM de 400 milliards de paramètres. La connexion entre les DIGITS pourra se faire via ConnectX qui sont des interfaces Ethernet hautes performantes (jusqu'à 400 Gb/s).

La machine utilise un OS dédié basé sur Linux : DGX OS. Il travaillera en transparence avec DGX Cloud. Tous les SDK et frameworks NVIDIA pourront être utilisés sur la machine. 

DIGITS devrait être disponible à partir de mai 2025 pour un prix de départ de 3 000 $. Reste à voir la configuration de base et les options proposées. DIGITS est un nom de code, peu de chance que ce soit le nom commercial de la machine. 

Réduire l’empreinte des vecteurs : la quantification vectorielle partie 2

Soumis par francoistonic le
Image
Image
Image

Dossier de Han HELOIR, EMEA Gen AI Solutions Architect (MongoDB)

La quantification vectorielle : Réduire pour mieux produire

1.   Pourquoi compresser les vecteurs ?

La quantification vectorielle est une méthode de compression des embeddings, qui consiste à réduire la précision des vecteurs pour diminuer leur taille en mémoire et leurs besoins en calcul. Cette approche s’inscrit dans une stratégie globale d’optimisation des systèmes d’IA générative, où chaque milliseconde et chaque octet comptent.

Sans quantification, les vecteurs sont généralement stockés en float32, un format numérique utilisant 32 bits par dimension. Cela garantit une précision élevée mais engendre des coûts de stockage exorbitants, une augmentation des latences, et des contraintes pour la scalabilité. La quantification répond à ces défis en réduisant la taille des vecteurs tout en maintenant une précision suffisante pour les tâches courantes.

2.   Les trois grandes méthodes de quantification

Chaque méthode de quantification propose un équilibre différent entre compression, précision, et performance. Voici un tour d’horizon des principales approches :

a) Quantification scalaire (int8) : La solution universelle

La quantification scalaire réduit la précision de chaque élément d’un vecteur en le mappant à un ensemble pré-défini de niveaux, comme les 255 niveaux disponibles en format int8. Cette méthode divise la taille des vecteurs par 4x à 32x, tout en conservant une grande partie de leur précision.

Comment ça marche?

  1. Les valeurs maximales et minimales de chaque dimension sont identifiées dans l’ensemble de données.
  2. L’espace entre ces valeurs est divisé en niveaux équidistants (ex. : 255 pour int8).
  3. Chaque élément du vecteur est associé au niveau le plus proche, réduisant ainsi sa précision.

Exemple:

Un vecteur original avec des valeurs précises comme [0.456, 0.789, -0.123] pourrait être réduit à [46, 78, -12], tout en maintenant sa signification dans les recherches.

Bénéfices:

-        Réduction importante des coûts de stockage.

-        Compatible avec la majorité des cas d’usage, des moteurs de recherche aux systèmes de recommandations

-        Conservation d’une précision élevée (jusqu’à 96 % dans certains scénarios).

b) Quantification binaire : La compacité maximale

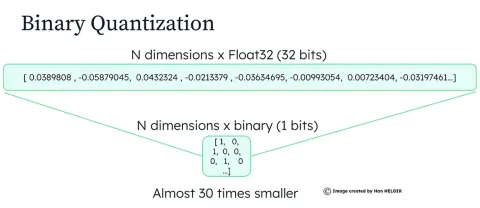
La quantification binaire pousse la compression encore plus loin en réduisant chaque élément à une valeur binaire (0 ou 1). Cela réduit drastiquement les besoins en stockage, mais au prix d’une perte de précision plus marquée.

Comment ça marche?

  1. Les vecteurs sont normalisés dans un espace restreint, souvent entre -1 et 1.
  2. Chaque élément est évalué : s’il est positif, il devient 1 ; sinon, 0.

Exemple :

Un vecteur [0.45, -0.23, 0.78] deviendrait [1, 0, 1].

Bénéfices :

-        Compression maximale, divisant les besoins de stockage par 32x à 64x.

-        Temps de calcul réduit grâce à des représentations simplifiées.

Risque de perte de précision, nécessitant des techniques complémentaires comme le rescoring ou l’oversampling.

c) Quantification par produit (PQ) : La solution modulaire

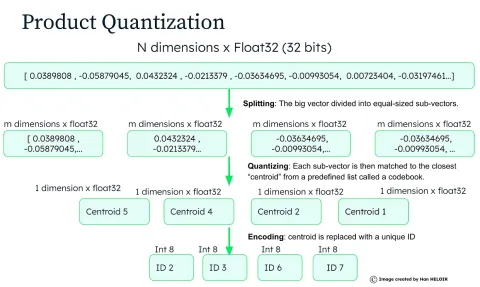
La quantification par produit (Product Quantization - PQ) divise un vecteur de haute dimension en sous-vecteurs de taille plus petite, chacun étant compressé indépendamment. Cette méthode offre un compromis idéal entre compression, précision, et efficacité computationnelle.

Comment ça marche?

  1. Le vecteur est divisé en plusieurs segments (ou sous-vecteurs).
  2. Chaque sous-vecteur est associé à un centroïde préalablement calculé (via des algorithmes comme k-means).
  3. Au lieu de stocker les sous-vecteurs eux-mêmes, on ne conserve que les indices des centroïdes correspondants.

Exemple :

Un vecteur [0.45, -0.23, 0.78, -0.11] pourrait être divisé en deux sous-vecteurs [0.45, -0.23] et [0.78, -0.11], chacun étant compressé indépendamment.

Bénéfices:

-        Permet une compression adaptative selon les besoins.

-        Très efficace pour des systèmes traitant des milliards de vecteurs, comme FAISS (Facebook AI Similarity Search).

Performances légèrement inférieures pour les recherches en temps réel.

Cas d’usage recommandé :

-        Systèmes nécessitant une forte scalabilité, comme les plateformes de commerce électronique ou les moteurs de recherche visuelle.

4.   Pourquoi choisir la quantification vectorielle en production ?

a) Réduction des coûts

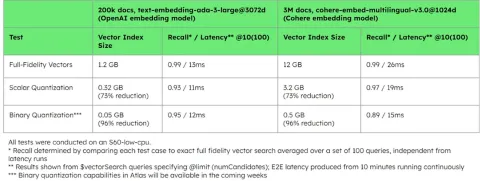
Selon une étude réalisée par HuggingFace, la quantification scalaire ou binaire peut réduire les coûts de stockage par un facteur de 20x à 30x, tout en maintenant une précision suffisante pour la majorité des cas d’usage. Par exemple : Une base contenant 250 millions de vecteurs passe de 7,5 To à 240 Go.

b) Amélioration des performances

Avec des vecteurs compressés, les recherches deviennent plus rapides car il y a moins de données à traiter. Cela se traduit par une réduction significative de la latence, essentielle pour les applications en temps réel.

Significant storage reduction + good recall and latency performance with quantization on different embedding models(Source: MongoDB blog)

c) Scalabilité accrue

La compression permet de gérer des bases de données volumineuses sans augmenter proportionnellement les coûts en matériel ou en infrastructure cloud. Cela ouvre la voie à une scalabilité durable, même avec une augmentation rapide des utilisateurs et des requêtes.

4.   Techniques avancées pour compenser la perte de précision

Oversampling : Récupère un plus grand nombre de résultats initiaux pour maximiser les chances d’inclure les éléments pertinents.

Rescoring : Affine les résultats en recalculant leur pertinence avec les vecteurs originaux (float32), garantissant des recommandations de haute qualité.

Conclusion : Construire une IA générative scalable

Grâce à des techniques comme la quantification vectorielle et l’indexation HNSW, les entreprises peuvent réduire leurs coûts, améliorer leurs performances, et garantir une scalabilité durable. Ces approches sont essentielles pour transformer les PoC prometteuses en solutions de production robustes et économiques.

Invitation à l’action : Explorez ces techniques dans vos projets et découvrez leur impact sur vos systèmes IA !

Références : 

  1. HuggingFace: Binary and Scalar Embedding Quantization for Significantly Faster & Cheaper Retrieval (https://huggingface.co/blog/embedding-quantization#quantization-experiments)
  2. MongoDB blog: Significant storage reduction + good recall and latency performance with quantization on different embedding models (https://www.mongodb.com/blog/post/vector-quantization-scale-search-generative-ai-applications)
Réduire l’empreinte des vecteurs : la quantification vectorielle partie 1

Soumis par francoistonic le
Image

Dossier de Han HELOIR, EMEA Gen AI Solutions Architect (MongoDB)

Introduction : la révolution des embeddings et ses défis cachés

L’intelligence artificielle générative, notamment à travers le Retrieval-Augmented Generation (RAG), révolutionne la gestion des données en combinant la puissance des modèles génératifs avec des bases de connaissances structurées. Cette approche permet d’automatiser des tâches complexes tout en accédant en temps réel à des informations précises et pertinentes provenant de multiples sources. 

Au cœur de ces systèmes se trouvent les embeddings, des vecteurs mathématiques capables de représenter des données non structurées telles que des textes, des images, ou des vidéos. Ces vecteurs permettent de réaliser des tâches avancées comme les recherches sémantiques, les recommandations, ou encore l’analyse de similarité.

Cependant, derrière l’innovation se cache une complexité technique. Lors de la phase de PoC (Proof of Concept), la gestion des embeddings peut sembler relativement simple. Mais une fois en production, ces vecteurs deviennent une source importante de coûts, de latence, et de problèmes d’évolutivité. En effet, leur stockage, leur traitement, et leur recherche à grande échelle exigent des infrastructures coûteuses et complexes.

Dans cet article, nous explorons comment la quantification vectorielle, associée à des techniques de l’indexation comme HNSW(Hierarchical Navigable Small World), peut réduire significativement ces obstacles. Ces approches permettent de maintenir des performances élevées tout en rendant la scalabilité plus accessible.

Les défis techniques des embeddings en production

1. Explosion des coûts de stockage

Chaque embedding est une représentation numérique haute dimension, souvent en format float32. Cela signifie que chaque élément du vecteur utilise 32 bits de mémoire. Multipliez cela par des millions, voire des milliards d’embeddings, et vous obtenez des volumes de données astronomiques.

Prenons un exemple concret : une base contenant 250 millions d’embeddings, chacun ayant 1 024 dimensions. En format float32, cette base occuperait 7,5 To d’espace et coûterait environ 3 600 $ par mois sur une plateforme comme AWS. À cela s’ajoutent les frais pour les sauvegardes, la redondance, et la haute disponibilité. Ces coûts deviennent rapidement prohibitifs, notamment pour des start-ups ou des projets avec des budgets limités.

Embeddings et le coût associé (Source: HuggingFace)

2. Latence accrue et surcharge computationnelle

Les embeddings ne se limitent pas au stockage ; ils doivent également être interrogés pour effectuer des recherches rapides et précises. Ces recherches, appelées recherches de voisins les plus proches (Nearest Neighbor Search), nécessitent des calculs dans des espaces vectoriels de haute dimension. Chaque vecteur doit être comparé à d’autres pour déterminer les éléments les plus similaires.

Plus les vecteurs sont longs (haute dimension) et plus la base de données est volumineuse, plus la recherche devient longue. Cela pose un problème critique dans les applications en temps réel, où les utilisateurs s’attendent à des réponses quasi instantanées. Par exemple, une application de recommandations doit répondre en moins de 300 millisecondes pour maintenir une expérience utilisateur satisfaisante. Une recherche trop lente peut entraîner une frustration des utilisateurs et une perte de clients.

3. Scalabilité limitée

À mesure que le nombre d’utilisateurs et de données augmente, les exigences en calcul et en mémoire explosent. Cela entraîne des frais supplémentaires en matériel (serveurs, RAM) et en infrastructure cloud, créant un goulot d’étranglement financier. Les entreprises sont alors confrontées à un dilemme : réduire la qualité du service ou augmenter leurs dépenses.

HNSW : Une indexation intelligente pour les recherches rapides

1. Une structure hiérarchique

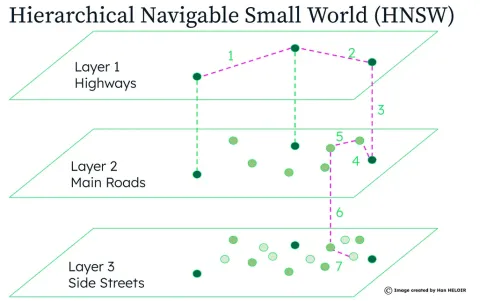
HNSW (Hierarchical Navigable Small World) est une méthode d’indexation conçue pour accélérer les recherches dans des bases vectorielles. Contrairement à une recherche linéaire, qui comparerait chaque vecteur à l’ensemble des autres, HNSW construit un graphe multi-niveaux pour organiser les données de manière plus efficace.

Ce graphe hiérarchique fonctionne comme une carte routière :

-        Niveau supérieur : Les autoroutes, qui permettent de parcourir rapidement de grandes distances.

-        Niveaux intermédiaires : Les routes principales, qui affinent la recherche.

-        Niveau le plus bas : Les petites rues, qui mènent aux résultats finaux.

En utilisant cette approche, HNSW réduit drastiquement le nombre de comparaisons nécessaires pour trouver les voisins les plus proches d’un vecteur, tout en garantissant une recherche rapide et précise.

2. Avantages et limitations

HNSW est particulièrement efficace car il :

-        Réduit les temps de recherche, même dans des bases massives.

-        Permet des mises à jour incrémentielles (ajout de nouveaux vecteurs sans reconstruire tout l’index).

Cependant, cette méthode exige une grande quantité de RAM, car le graphe doit être entièrement chargé en mémoire pour offrir des performances optimales. C’est ici que la quantification vectorielle devient essentielle, car elle réduit la taille des vecteurs et, par conséquent, les besoins en mémoire.

Microsoft Connect(); 2017 : ouverture, productivité et IA au service des développeurs

Soumis par fredericmazue le

C'est hier que s'est ouverte l’édition 2017 de Microsoft Connect(); la e-conférence dédiée aux développeurs, Scott Guthrie, Executive Vice-President de Microsoft, présente de nouvelles solutions destinées aux développeurs qui souhaitent gagner en productivité, optimiser leurs applications grâce à l’Intelligence Artificielle, et ce, quels que soient la plateforme, la base de données et l‘appareil qu’ils utilisent.

Du 15 au 17 novembre 2017, la e-conférence Microsoft Connect(); s’inscrit dans la volonté de Microsoft de libérer le potentiel et la créativité des développeurs, à travers le lancement d’un large éventail de solutions autour de l’Open Source, l’Intelligence artificielle, l’analyse intelligente de données, le Cloud et la collaboration.

L’open source au cœur des solutions de Microsoft

Microsoft souhaite accompagner chaque développeur dans la création et le développement d’applications, quels que soient la plateforme, la base de données et l’appareil. Ainsi, Microsoft annonce cette année plusieurs nouveautés en lien avec le monde de l’Open Source :

· En preview – Azure Databricks, la plateforme d’analyse développée en partenariat avec les fondateurs d’Apache Spark (en savoir plus);

· En preview – Les API de Cassandra disponibles sur Azure Cosmos Database pour permettre à Cassandra de se développer en mode « as-a-service »;

· Présentation de la roadmap GitHub pour l’adoption des Git Virtual File Systems (GVFS) (en savoir plus);

· Preview de SQL Operations Studio qui permet d’administrer des SQL Servers depuis Windows, Linux et Mac (gratuit).

Par ailleurs, un an après être devenu membre Platinium de la Fondation Linux, Microsoft annonce rejoindre au même titre la Fondation MariaDB et présente Azure Database for MariaDB en preview.

L’Intelligence Artificielle et l’analyse des données pour libérer le potentiel des développeurs

Microsoft annonce cette année de nouveaux outils et API conçus pour accompagner les développeurs dans la création d’applications nourries à l’intelligence artificielle et au Machine Learning pour des analyses de données toujours plus pertinentes et pointues.

· En preview – Azure IoT Edge : Microsoft injecte de l’intelligence artificielle au-delà du cloud dans les objets et déplace ainsi l’analyse de données temps réel ;

· Visual Studio Tools for AI : pour développer des modèles d’intelligence artificielle dans n’importe quel langage et contexte ;

· Azure SQL Server Database Machine Learning Services : pour développer des modèles de machine learning directement dans la base de données et ainsi créer des analyses prédictives au sein d’applications toujours plus intelligentes.

Augmenter la productivité des développeurs 

Pour optimiser la création, le déploiement et la gestion des applications, Microsoft lance un ensemble de solutions pour faciliter le travail collaboratif et permettre aux développeurs de se concentrer sur leur cœur de métier : le code / la conception des applications de demain.

· Visual Studio App Center, hébergé sur le Cloud Azure, a pour objectif de faciliter le lancement des applications les plus complexes et, par conséquent, d’accroître la productivité des développeurs (en savoir plus);

· Visual Studio Live Share, la solution qui permet à différents développeurs de travailler simultanément et de façon sécurisée sur un même projet sans être devant le même écran ;

· Azure DevOps Projects, assistant qui permet aux développeurs de créer un pipeline d’intégration et de déploiement continu à travers le portail Azure en utilisant les services de Visual Studio Team Service (VSTS).

NVIDIA double ses performances en matière d'intelligence artificielle

Soumis par fredericmazue le

NVIDIA a effectué des mises à jour sur ses GPU accélérés pour doubler les performances des systèmes de formation à l’intelligence artificielle (« Deep Learning »).

Le nouveau logiciel permettra aux scientifiques et aux chercheurs de dynamiser leurs projets de deep learning et le développement produit en créant des réseaux de neurones plus précis à l’aide d’un modèle d’apprentissage rapide doté d’un design plus complexe.

La nouvelle version du système de formation au deep learning GPU NVIDIA DIGITS (DIGITS 2) et la troisième version de NVIDIA CUDA Deep Neural Network (cuDNN 3) offrent une augmentation considérable des performances ainsi que de nouvelles fonctionnalités.

Pour les scientifiques, DIGITS 2 réalise désormais une graduation automatique de la formation des réseaux de neurones grâce à des GPU multiples hautement performants. La vitesse de formation des réseaux de neurones profonds pour la classification des images peut ainsi être doublée par rapport à un GPU unique.

La nouvelle bibliothèque cuDNN 3 devrait être intégrée dans les futures versions de deep learning Caffe, Minerva, Theano et Torche, qui sont essentiellement utilisées pour former des réseaux de neurones en profondeur.

«Les GPU haute performance sont la technologie fondamentale pour alimenter la recherche sur le deep learning et le développement produits dans les universités et dans les grandes entreprises du secteur informatique », a déclaré Ian Buck, vice-président de l’informatique accélérée chez NVIDIA. « Nous travaillons en étroite collaboration avec des scientifiques, des développeurs et la communauté du deep learning, pour appliquer les technologies GPU les plus puissantes et repousser les limites de l’impossible. »

DIGITS 2 – Une formation jusqu’à 2 fois plus rapide grâce à la graduation automatique multi-GPU

DIGITS 2 est un système graphique, tout en un, qui guide les utilisateurs à travers le processus de création, de formation et de validation des réseaux de neurones en profondeur pour la classification des images.

La nouvelle fonction de graduation automatique multi-GPU installée sur le DIGITS 2 augmente les ressources disponibles du GPU en distribuant automatiquement la charge de travail du deep learning sur tous les GPU du système. En utilisant DIGITS 2, les ingénieurs de NVIDIA ont entraîné le fameux modèle de réseau de neurones AlexNet deux fois plus vite en utilisant quatre GPU à l’architecture basée sur NVIDIA Maxwell™ qu’avec un GPU unique.1 Les résultats préliminaires issus des premiers clients montrent des résultats encore meilleurs.

« Entraîner un de nos réseaux en profondeur à l’étiquetage automatique sur un seul NVIDIA GeForce GTX TITAN prend environ 16 jours, alors qu’en utilisant la nouvelle graduation multi-GPU sur quatre GPU TITAN X, la formation est achevée au bout de seulement cinq jours », explique Simon Osindero, architecte en intelligence artificielle pour Flickr, Yahoo. « C’est un avantage clé et cela nous permet de voir les résultats plus vite, mais également d’explorer plus en détails l’espace des modèles pour atteindre des résultats plus précis ».

cuDNN 3 – Entraîne plus rapidement des modèles plus grands et plus complexes

CuDNN est une bibliothèque de GPU accélérés basée sur des méthodes mathématiques pour les réseaux de neurones en profondeur que les développeurs intègrent à des systèmes d’apprentissage automatique de niveau supérieur.

CuDNN 3 ajoute 16 bits de stockage de données en virgule flottante à la mémoire GPU, ce qui double la quantité de données pouvant être stockées et optimise la bande passante. Grâce à cette capacité, cuDNN 3 permet aux chercheurs d’entraîner des réseaux de neurones plus grands et plus complexes.

« Nous pensons que le mode de stockage FP16 des bibliothèques NVIDIA nous permettra de graduer encore mieux nos modèles, puisqu’il augmentera la capacité de mémoire effective de notre hardware, et d’augmenter notre efficacité puisque nous classifierons la formation d’un seul modèle sur plusieurs GPU », explique Bryan Catanzaro, chercheur chez Baidu Research. « Ainsi, nous obtiendrons des modèles plus précis ».

CuDNN 3 accélère également de manière significative les performances de formation de réseaux de neurones sur un seul GPU en comparaison avec cuDNN 2. Les ingénieurs d’NVIDIA ont formé le modèle AlexNet deux fois plus vite sur un seul GPU NVIDIA GeForce GTX TITAN X.2

Disponibilité

La version beta de DIGITS 2 est disponible dès aujourd’hui en téléchargement libre pour les développeurs inscrits dans le programme NVIDIA.

La bibliothèque cuDNN 3 devrait être disponible sur les principaux systèmes de deep learning dans les prochains mois. Pour en savoir plus, veuillez consulter la page cuDNN.

Code of War 2014 arrive !

Soumis par fredericmazue le
Image

La nouvelle plateforme ouvrira ses portes le Mercredi 25 Juin, en ligne et en live au Cesi de Blanquefort.

Cette année Code of War met à l'honneur Open Data et VCub, dont voici le synopsis :

"La Cub lance un appel d'offre pour choisir la société qui gèrera la camionnette de ramassage des VCub."

Les équipes représenterons une de ces sociétés et devront gérer au mieux leurs deux camionnettes pour l'emporter.
La plateforme de jeu sera disponible 6 mois avant la semaine digitale pour que les équipes puissent s'organiser et commencer à préparer leur IA.
Le jour de l'évènement, elles pourrons se mesurer aux autres et aurons toute la matinée pour améliorer leur robot.
Enfin, les équipes s'affronteront lors d'un tournoi pour désigner le vainqueur.

Le 25 Juin prochain vous pourrez non seulement découvrir en ligne cette nouvelle plateforme et commencer à vous préparer pour la finale, mais également participer en live à une journée spéciale organisée au Cesi.

Déroulé de la journée :

  • 09h00 accueil
  • 09h30 1h de présentation et d’explication par David Mouton
  • 10h30 Lancement de la première itération -> IA nulle
  • 12h00 Fin de la première itération
  • 12h30 Rétro
  • 13h30 Début de la seconde itération -> IA plus forte
  • 15h00 Fin et rétro
  • 15h15 Présentation du gros boss et lancement de la dernière itération -> IA Gros boss et Score RAZ
  • 16h30-17h00 Bilan et remise.

Inscrivez vous dès maintenant, et venez avec votre ordinateur portable pour participer à cette folle journée.

Toutes les infos, sdk, api, sont sur codeofwar.net

Code of War

Soumis par fredericmazue le

Code of War est une compétition de programmation en équipe, gratuite et ouverte à tous. Deux ou trois personnes peuvent composer une équipe, dont au moins une personne avec des notions de programmation.
Ce tournoi ne va pas récompenser le meilleur programmeur, mais la meilleure tactique.

Chaque équipe aura à programmer l'IA de son robot au travers d'un SDK disponible en Javascript, TypeScript, CoffeeScript, Haxe, ou Dart. Les robots s'affronteront alors dans des batailles sans merci où un seul sortira vainqueur.
Stratégie et tactique de jeux sont les compétences nécessaires pour s'assurer la victoire. 

Déroulement :

10h à 10h30 : Présentation de l’événement et des équipes

10h30 à 13h00 : Coding Time : Analyse des concurrents et amélioration des robots

15h00 à 17h00 : Tournoi

17h00 à 18h00 : Remise des récompenses.


Organisateur : TTFX
http://www.tamina-online.com/ttfx/

Lieu : Epitech Bordeaux
85 rue du jardin publique 
Bordeaux 33000

Date : le 02/11/2013 à partir de 10h

Prix : Gratuit

Audience : Développeur, Etudiant, Joueur

Inscriptions : codeofwar.eventbrite.com 

Les tontons flexeurs organisent un coding context d'intelligence artificielle

Soumis par fredericmazue le

Les tontons flexeurs organisent un tournoi de développement en équipe, dans le genre de ce qu'on peut voir sur e=m6 avec les combats de robots. Vous aurez à développer la stratégie de votre robot logique, son IA, et le faire affronter les autres.

Ce n'est pas le meilleur développeur qui gagnera mais bien la plus habile stratégie qui sera récompensée.

Pour participer il suffit d'avoir au moins un membre de l'équipe maitrisant un des langages orientés objet les plus populaires. Il peut être développeur PHP, Javascript, Java, ActionScript, C#, C++, Python, etc...

Les organisateurs s'assureront que la technologie choisie pour le tournoi ne soit un frein pour personne. Attention, vous devrez venir avec votre ordinateur, au moins un par équipe, et votre bonne humeur.

L'équipe organisatrice a prévu un buffet campagnard et des boissons pour ceux qui veulent rester sur place.

C'est gratuit, alors n'hésitez pas, et venez vous amuser avec les tontons flexeurs le samedi 18 février, à ENSEIRB-MATMECA 1 avenue du Docteur Albert Schweitzer 
33402 Talence

Inscrivez vous ici : http://codingcontest.eventbrite.com/