intelligence artificielle

Oups ! La présentation de Bard coûte 120 milliards de dollars à Google

Soumis par fredericmazue le

Ainsi que nous vous le rapportions hier, Google a présenté Bard, une intégration de son service d'IA conversationnel expérimental à son moteur de recherche. Vues les circonstances, on a même envie de dire: s'est précipitée à présenter ce nouveau service. Avec bien sûr l'intention de répondre à l'intégration de ChatGPT à Bing par Microsoft. 

Seulement voilà... Dans sa présentation, Sundar Pichai a écrit Bard peut être un exutoire pour la créativité et une rampe de lancement pour la curiosité, vous aidant à expliquer les nouvelles découvertes du télescope spatial James Webb de la NASA à un enfant de 9 ans. Tout en fournissant une animation montrant la question posée et la réponse donnée par l'I.A. Selon cette dernière : JWST a pris les toutes premières photos d'une planète en dehors de notre propre système solaire.

Format vidéo non pris en charge

Pas de chance... La première image jamais prise d'une planète en dehors du système solaire - une exoplanète - a été capturée en 2004 par le réseau du Very Large Telescope au Chili. Cette exoplanète s'appelle 2M1207b, fait environ cinq fois la taille de Jupiter et est située à environ 170 années-lumière de la Terre.

Un couac retentissant qui, selon notre confrère Telegraph, a fait que le cours de l'action de la société mère Alphabet a chuté de 8% après le lancement de l'outil Google Bard. A son point le plus bas mercredi, l'action Alphabet se négociait à 98,08$, soit une baisse de 8,1% par rapport au prix de la veille de 106,77$, ce qui correspond, toujours selon Telegraph, à une perte de 120 milliards de dollars.

Depuis, Google a essayé de se rattraper aux branches, en déclarant, par la voie d'un porte-parole : Cela souligne l'importance d'un processus de test rigoureux, quelque chose que nous lançons cette semaine avec notre programme Trusted Tester. Nous combinerons les commentaires externes avec nos propres tests internes pour nous assurer que les réponses de Bard atteignent un niveau élevé de qualité, de sécurité et d'ancrage dans les informations du monde réel.

Commentaire actu

Bard : la réponse de Google à l'intégration de ChatGPT dans Bing

Soumis par fredericmazue le

Hier, nous vous rapportions que Microsoft travaille à intégrer l'intelligence artificielle de ChatGPT à Bing. Ceci pour aboutir à un 'nouveau Bing' capable de menacer le moteur de recherche de Google.

L'entreprise de Mountain View n'a pas été longue à réagir. Celle-ci travaille sur l'intelligence artificielle depuis longtemps et a d'ailleurs présenté, lors de Google I/O 2021, LaMDa, un robot conversationnel similaire à ChatGPT. Mais les choses viennent de s'accélérer par la plume de Sundar Pichai, d'abord avec un tweet, ensuite avec un long billet de blog pour présenter Bard, un service d'IA conversationnel expérimental destiné à être intégré au moteur de recherche de Google.

Nous avons travaillé sur un service d'IA conversationnel expérimental, propulsé par LaMDA, que nous appelons Bard. Et aujourd'hui, nous franchissons une nouvelle étape en l'ouvrant à des testeurs de confiance avant de le rendre plus largement accessible au public dans les semaines à venir.

Bard cherche à combiner l'étendue des connaissances du monde avec la puissance, l'intelligence et la créativité de nos grands modèles linguistiques. Il s'appuie sur les informations du Web pour fournir des réponses fraîches et de haute qualité, écrit Sundar Pichai. La dernière phrase est un tacle au passage à Microsoft, car, comme l'indique OpenAI, ChatGPT a une connaissance limitée du monde et des événements après 2021.

La mariée n'est pas trop belle pour Sundar Pichai : Bard cherche à combiner l'étendue des connaissances du monde avec la puissance, l'intelligence et la créativité de nos grands modèles linguistiques. Il s'appuie sur les informations du Web pour fournir des réponses fraîches et de haute qualité. Bard peut être un exutoire pour la créativité et une rampe de lancement pour la curiosité, vous aidant à expliquer les nouvelles découvertes du télescope spatial James Webb de la NASA à un enfant de 9 ans, ou à en savoir plus sur les meilleurs attaquants du football en ce moment, puis obtenez des exercices pour développer vos compétences...

Format vidéo non pris en charge

Sundar Pichai ajoute que le mois prochain, Google commencera à intégrer des développeurs, des créateurs et des entreprises individuels afin qu'ils puissent essayer l'API Generative Language, initialement optimisée par LaMDA avec une gamme de modèles à suivre. Au fil du temps, Google à l'intention de créer une suite d'outils et d'API qui permettront à d'autres de créer facilement des applications plus innovantes avec l'IA.

OpenAI propose un outil gratuit pour identifier les textes écrits par l'intelligence artificielle

Soumis par fredericmazue le

L'intelligence artificielle, et notamment ChatGPT qui fait le buzz du moment, inquiète (entre autres) les enseignants. En effet, nombre d'élèves commencent à rendre des devoirs générés par l'IA en les faisant passer pour leur propre travail.

ChatGPT a été développé par OpenAI. Et voilà que cette même société OpenAI vient de publier un classificateur, c'est-à-dire un outil d'intelligence artificielle, pour faire la distinction entre le texte écrit par un humain et le texte écrit par des IA de divers fournisseurs.

Voilà qui rappelle Coluche, quand il disait 'jusqu'où s'arrêteront-ils ?...' Bref voilà donc un outil pour ne pas se faire berner par l'IA. OpenAI précise que de bons classificateurs peuvent éclairer les atténuations des fausses allégations selon lesquelles le texte généré par l'IA a été écrit par un humain : par exemple, lancer des campagnes de désinformation automatisées, utiliser des outils d'IA pour la malhonnêteté académique, et positionner un chatbot IA comme un humain.

Seulement voilà, toujours selon OpenAI, le classificateur proposé n'est pas un bon classificateur... Notre classificateur n'est pas entièrement fiable [...] Notre classificateur identifie correctement 26 % du texte écrit par l'IA (vrais positifs) comme « probablement écrit par l'IA », tout en étiquetant incorrectement le texte écrit par l'homme comme écrit par l'IA indique OpenAI. L'IA serait-elle en plus mégalo en se croyant intelligente comme les humains ? :-) Il est encore précisé que le classificateur est très peu fiable sur les textes courts, d'une longueur inférieure à 1000 caractères. Ce classificateur ne doit pas être utilisé comme un outil de prise de décision principal, mais plutôt comme un complément à d'autres méthodes de détermination de la source d'un morceau de texte, indique encore OpenAI.

Microsoft s'apprêterait à investir 1O milliards de dollars sur ChatGPT

Soumis par fredericmazue le

Selon Semafor, Microsoft s'apprêterait à investir 10 milliards de dollars sur l'application de chat ChatGPT d'OpenAI, application  qui est le buzz du moment.

Un accord compliqué serait en passe d'être conclu entre Microsoft et OpenAI. Selon cet accord Microsoft obtiendrait 75% des bénéfices d'OpenAI jusqu'à ce qu'elle récupère son investissement. A la suite de quoi les bénéfices seraient répartis entre Microsoft, 49%, d'autres investisseursn 49% et OpenAI qui est une société à but non lucratif, 2%

Microsoft aurait l'intention d'utiliser ChatGPT pour améliorer son moteur de recherche Bing ainsi que sa suite Office. Les capacités de ChatGPT seraient apportées Word, PowerPoint, Outlook et d’autres applications, afin que les utilisateurs puissent générer automatiquement du texte de manière simple.

Pour mémoire, en 2014, Google avait acheté DeepMind pour 628 millions de dollars.

Amazon Fortuna : une bibliothèque open source pour quantifier l'incertitude des modèles ML

Soumis par fredericmazue le
Image

Une estimation précise de l'incertitude prédictive est cruciale pour les applications d'intelligence artificielle qui impliquent des décisions critiques. L'incertitude permet d'évaluer la fiabilité des prédictions du modèle, de s'en remettre aux décideurs humains ou de déterminer si un modèle peut être déployé en toute sécurité. 

Dans le domaine de l'intelligence artificiel, être trop confiant peut être problématique dans la pratique. Un médecin peut ne pas prescrire des tests supplémentaires pertinents, à la suite d'un diagnostic sain trop confiant produit par une IA. Une voiture autonome peut décider de ne pas freiner parce qu'elle a évalué avec confiance que l'objet devant n'était pas une personne. Un gouverneur peut décider d'évacuer une ville parce que la probabilité d'une catastrophe naturelle majeure estimée par une IA est trop élevée. Malheureusement, de nombreux réseaux de neurones profonds entraînés sont mal calibré, ou en d'autres termes sont trop confiants.

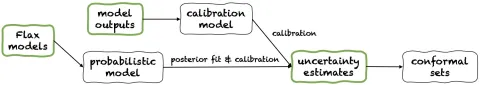
Pour aider à travailler ce sujet, Amazon publie Fortunea qui est une bibliothèque open source pour quantifier l'incertitude des modèles ML.

Fortuna propose trois modes d'utilisation : à partir de modèles Flax, à partir de sorties de modèles et à partir d'estimations d'incertitude . Leurs pipelines sont représentés dans la figure suivante, chacun partant d'un des panneaux verts.

La bibliothèque Amazon Fortuna est un logiciel libre sous licence Apache 2.0 et est entièrement documentée ici.

Bientôt un Windows dopé à l'intelligence artificielle ?

Soumis par fredericmazue le

Lors de l'événement CES 2023 qui se déroule actuellement, Panos Panay, le responsable Windows et matériels Windows de Microsoft a fait une intervention remarquée. Cette intervention a été faite dans le contexte de l'annonce faite par le fondeur AMD de ses nouveaux processeurs mobiles Ryzen 7000. Des processeurs qu'AMD a présenté comme étant les premières puces x86 à contenir un moteur d'intelligence artificielle dédié.

Au cours de la présentation, Lisa Su, la présidente d'AMD a invité Panos Panay, qui a alors déclaré : "L'IA va réinventer la façon dont vous faites tout sur Windows, littéralement".

Par contre Panos Panay n'est pas entré dans les détails sur les futurs rapports que pourrait entretenir Windows avec l'intelligence artificielle. Il a seulement évoqué le fait que, grâce à ces nouveaux processeurs, la webcam d'un PC pourrait ajouter un flou d'arrière-plan, détecter le contact visuel et cadrer automatiquement quelqu'un lors d'une conférence téléphonique tout en utilisant beaucoup moins de batterie.

Projet Wisdom : Red Hat intègre de l'intelligence artificielle dans sa plate-forme Ansible

Soumis par fredericmazue le

Red Hat et IBM Research, dévoilent « Project Wisdom », le premier projet communautaire visant à doter la plate-forme Ansible d’une capacité de traitement intelligent du langage naturel. Le projet s’appuie sur un modèle d’IA stimulant, selon les partenaires,  la productivité des développeurs d’automatisation informatique, en faisant de cette dernière une approche plus facile à appliquer et à comprendre pour les professionnels de l’IT, quelles que soient leurs compétences et leurs parcours.

Le projet Wisdom, qui repose sur des modèles d’IA dérivés du programme AI for Code d’IBM, permet à un utilisateur d’effectuer une commande sous la forme d’une simple phrase en anglais. Il analyse ensuite la phrase énoncée et construit le workflow d’automatisation demandé, avant de le livrer sous la forme d’un playbook Ansible, qui peut être utilisé pour automatiser un certain nombre de tâches informatiques. Contrairement à d’autres outils de codage pilotés par l’IA, le projet Wisdom ne se concentre pas sur le développement d’applications, mais s’applique plutôt à résoudre le problème de la complexité croissante de l’informatique d’entreprise à mesure que de plus en plus d’organisations adoptent le cloud hybride.

Red Hat et IBM soulignet que devenir un expert en automatisation exige de déployer des efforts et d’utiliser des ressources considérables au fil du temps, avec une courbe d’apprentissage pour explorer et maîtriser différents domaines. Le projet Wisdom vise à combler le fossé entre le code YAML d’Ansible et le langage humain, afin que les utilisateurs puissent s’exprimer dans un anglais simple pour pouvoir générer un contenu d’automatisation syntaxiquement correct et fonctionnel.

Un tel contenu pourrait permettre à un administrateur système, qui fournit généralement des services sur site, de naviguer entre ces différents domaines pour construire, configurer et exploiter d’autres environnements en utilisant le langage naturel pour générer des instructions issues d’un playbook. Un développeur qui serait capable de créer une application, mais qui ne disposerait pas des compétences nécessaires pour l’installer sur une nouvelle plate-forme dans le cloud, pourrait se servir du projet Wisdom pour développer ses compétences dans ces nouveaux domaines et contribuer à la transformation de l’entreprise. Les novices issus de chaque service pourraient être en mesure de générer du contenu de manière immédiate, tout en développant des connaissances de base et n’auraient pas à dépendre des modèles d’enseignement traditionnels.

Chris Wright, CTO and SVP of Global Engineering chez Red Hat : « Ce projet illustre comment l’intelligence artificielle a le pouvoir de modifier fondamentalement la façon dont les entreprises innovent, en accordant des capacités généralement réservées aux équipes opérationnelles à d’autres services. Grâce à des solutions intelligentes, les entreprises peuvent diminuer les obstacles à la participation, combler les lacunes croissantes en matière de compétences et éliminer les cloisonnements à l’échelle de l’entreprise pour repenser les manières de travailler dans le monde de l'entreprise. »

Ruchir Puri, chief scientist chez IBM Research; IBM Fellow; VP de la IBM Technical Community : « Le projet Wisdom est la preuve que des opportunités considérables peuvent être concrétisées grâce à la technologie et à l’entreprise en combinant les dernières nouveautés en matière d’IA et de logiciels. Nous vivons une époque fascinante, où nous continuons de faire progresser la manière dont l’IA et les technologies de cloud hybride d’aujourd’hui construisent les ordinateurs et les systèmes de demain. »

Lancement de la fondation PyTorch

Soumis par fredericmazue le

Mark Zuckerberg a annoncé sur sa page Facebook que PyTorchera sera désormais géré par la nouvelle fondation indépendante PyTorch, sous l’égide de la fondation Linux. 

La fondation PyTorch a pour vocation de démocratiser l’accès à des outils d’IA de pointe, des bibliothèques et d’autres composants, dans le but de faire progresser l’IA. Meta continuera d’investir dans PyTorch et de l’utiliser comme framework principal pour la recherche dans le domaine de l’IA et les applications de production dans l’entreprise.

Le projet rejoindra la Fondation Linux avec un conseil d'administration diversifié composé de représentants d'AMD, Amazon Web Services, Google Cloud, Meta, Microsoft et Nvidia, avec l'intention de s'étendre au fil du temps. 

Intel publie des kits de référence open source pour l'intelligence artificielle

Soumis par fredericmazue le

Intel a publié un ensemble de kits de référence AI open source, spécialement conçus pour rendre l'IA plus accessible aux organisations dans les environnements sur site, dans le cloud et en périphérie. Présentés pour la première fois à Intel Vision, les kits de référence comprennent : le code du modèle d'IA, des instructions de pipeline d'apprentissage automatique de bout en bout, des bibliothèques et des composants Intel oneAPI pour des performances inter-architectures. Ces kits permettent aux data scientists et aux développeurs d'apprendre à déployer l'IA plus rapidement et plus facilement dans les secteurs de la santé, de la fabrication, du détail et d'autres industries, avec une plus grande précision, de meilleures performances et un coût total de mise en œuvre plus faible. 

« L'innovation prospère dans un environnement ouvert et démocratisé. L'écosystème logiciel d'IA ouvert accéléré par Intel, y compris les frameworks populaires optimisés et les outils d'IA d'Intel, repose sur la base d'un modèle de programmation unifié oneAPI ouvert, basé sur des standards. Ces kits de référence, construits avec des composants du portefeuille de logiciels d'IA de bout en bout d'Intel, permettront à des millions de développeurs et de data scientists d'introduire rapidement et facilement l'IA dans leurs applications ou de dynamiser leurs solutions intelligentes existantes. » - Wei Li, Ph.D., vice-président et directeur général d'Intel pour l'IA et l'analytique.

Les charges de travail de l'IA continuent de croître et de se diversifier avec des cas d'utilisation dans la vision, la parole, les systèmes de recommandation et plus encore. Les kits de référence AI d'Intel, élaborés en collaboration avec Accenture, sont conçus pour accélérer l'adoption de l'IA dans tous les secteurs. Il s'agit d'IA open source, pré-construite, avec des contextes d'entreprise significatifs pour l'introduction de l'IA greenfield et les changements stratégiques des solutions d'IA existantes. Quatre kits sont disponibles au téléchargement dès aujourd'hui :

·        Santé des actifs des services publics : La consommation d'énergie ne cessant de croître dans le monde, les actifs de distribution d'électricité sur le terrain devraient augmenter. Ce modèle d'analyse prédictive a été formé pour aider les services publics à offrir une plus grande fiabilité de service. Il utilise XGBoost optimisé par Intel via la bibliothèque Intel oneAPI Data Analytics Library pour modéliser la santé des poteaux électriques avec 34 attributs et plus de 10 millions de points de données.  Les données comprennent l'âge des actifs, les propriétés mécaniques, les données géospatiales, les inspections, le fabricant, l'historique des réparations et de la maintenance, et les enregistrements des pannes. Le modèle de maintenance prédictive des actifs apprend continuellement au fur et à mesure que de nouvelles données sont fournies, comme le nom du fabricant du poteau, les pannes et autres changements d'état.

·        Contrôle visuel de la qualité : Le contrôle de la qualité (CQ) est essentiel dans toute opération de fabrication. Le problème des techniques de vision par ordinateur est qu'elles nécessitent souvent une puissance de calcul graphique importante pendant l'apprentissage et un réapprentissage fréquent lorsque de nouveaux produits sont introduits. Le modèle AI Visual QC a été formé à l'aide d'Intel AI Analytics Toolkit, y compris Intel Optimization for PyTorch et Intel Distribution of OpenVINO toolkit, tous deux alimentés par oneAPI, afin d'optimiser la formation et l'inférence pour qu'elles soient respectivement 20 % et 55 % plus rapides, par rapport à l'implémentation de base du kit de contrôle de la qualité visuelle d'Accenture sans les optimisations Intel pour les charges de travail de vision par ordinateur sur les CPU, GPU et autres architectures basées sur des accélérateurs. En utilisant la vision par ordinateur et la classification SqueezeNet, le modèle AI Visual QC a utilisé le réglage et l'optimisation des hyperparamètres pour détecter les défauts des pilules pharmaceutiques avec une précision de 95 %.

·        Chatbot client : Les chatbots conversationnels sont devenus un service essentiel pour soutenir les initiatives à travers l'entreprise. Les modèles d'IA qui prennent en charge les interactions des chatbots conversationnels sont massifs et très complexes. Ce kit de référence comprend des modèles de traitement du langage naturel par apprentissage profond pour la classification des intentions et la reconnaissance des entités nommées à l'aide de BERT et PyTorch. Intel Extension for PyTorch et Intel Distribution of OpenVINOtoolkit optimisent le modèle pour de meilleures performances (inférence 45 % plus rapide par rapport à l'implémentation de base du kit chatbot du client Accenture sans les optimisations Intel) sur des architectures hétérogènes, et permettent aux développeurs de réutiliser le code de développement du modèle avec des modifications minimales du code pour la formation et l'inférence.

·        Indexation intelligente des documents : Les entreprises traitent et analysent des millions de documents chaque année, et bon nombre de ces documents semi-structurés et non structurés sont acheminés manuellement. L'IA peut automatiser le traitement et la catégorisation de ces documents pour un acheminement plus rapide et une réduction des coûts du travail manuel. Utilisant un modèle de classification par vecteurs de support (SVC), ce kit a été optimisé avec Intel Distribution of Modin et Intel Extension for Scikit-learnpowered by oneAPI. Ces outils améliorent les temps de prétraitement des données, d'apprentissage et d'inférence pour les rendre respectivement 46 %, 96 % et 60 % plus rapides que l'implémentation en stock du kit d'indexation de documents Accenture Intelligent sans les optimisations Intel pour l'examen et le tri des documents avec une précision de 65 %.

Les développeurs cherchent à intégrer l'IA dans leurs solutions et les kits de référence contribuent à cet objectif. Ces kits s'appuient sur le portefeuille de logiciels d'IA d'Intel, qui comprend des outils de bout en bout et des optimisations de frameworks, et le complètent. Construits sur la base du modèle de programmation ouvert, standard et hétérogène oneAPI, qui offre des performances sur de nombreux types d'architectures, ces outils aident les scientifiques à former des modèles plus rapidement et à moindre coût en surmontant les limites des environnements propriétaires.

Prochaines étapes : Au cours de l'année prochaine, Intel publiera une série de kits de référence AI open source supplémentaires avec des modèles d'apprentissage automatique et d'apprentissage profond formés pour aider les organisations de toutes tailles dans leur parcours de transformation numérique.

AWS a ajouté une API et la formation incrémentielle à Amazon SageMaker JumpStart

Soumis par fredericmazue le

Amazon SageMaker JumpStart est disponible depuis décembre 2020. Il s'agit d'une fonctionnalité d'Amazon SageMaker qui aide à démarrer rapidement avec l'apprentissage automatique (ML). SageMaker JumpStart permet d'ajuster et de déployer en un clic une grande variété de modèles pré-formés pour les tâches ML courantes, ainsi qu'une sélection de solutions de bout en bout qui résolvent les problèmes commerciaux courants. Ces fonctionnalités simplifient chaque étape du processus de ML, ce qui facilite le développement de modèles et réduit le temps de déploiement.

Récemment, AWS a ajouté l'API JumpStart en tant qu'extension du SDK Python SageMaker, vous permettant de déployer et d'affiner par programme une vaste sélection de modèles pré-formés pris en charge par JumpStart sur vos propres ensembles de données.

De plus, AWS vient d'annoncer que tous les modèles JumpStart pouvant être formés prennent désormais en charge la formation incrémentielle. La formation incrémentielle vous permet de former un modèle que vous avez déjà affiné à l'aide d'un jeu de données étendu qui contient un modèle sous-jacent non pris en compte dans les exécutions de réglage fin précédentes, ce qui a entraîné de mauvaises performances du modèle. AWS souligne que la formation incrémentielle permet d'économiser du temps et des ressources car vous n'avez pas besoin de recycler le modèle à partir de zéro.