LiteRT

LiteRT.js : Google lance une Web AI dans le navigateur
Soumis par francoistonic le
Image

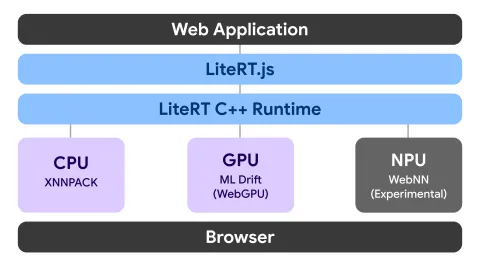
Il y a quelques semaines Google a annoncé LiteRT.js. Il s'agit d'un runtime IA haute performance directement accessible sur le navigateur. Il permet d'exécuter des modèles .tflite dans le navigateur en s'appuyant sur le WebGPU et le futur standard WebNN. 

Pourquoi ?

- avoir un écosystème accessible sur le web, Android et iOS

- compatible PyTorch

- optimisation 

- compatible TF.js et intégration avec les flux Tensorflow.js

"En portant la bibliothèque d'inférence LiteRT, reconnue pour sa fiabilité et initialement conçue pour les appareils mobiles, sur le web, les développeurs web peuvent désormais exécuter des modèles de ML et d'IA avec des performances optimales, entièrement en local. Cela se traduit par une confidentialité accrue des utilisateurs, l'absence de coûts serveur et une latence ultra-faible pour des expériences en temps réel. Pour les développeurs disposant déjà de modèles .tflite, LiteRT.js simplifie considérablement le déploiement sur les navigateurs web mobiles et de bureau, représentant une évolution majeure de TensorFlow.js pour l'exécution de ces modèles." explique Google. 

LiteRT.js doit obtenir de bonnes performances en exécutant les modèles .tflite directement dans le navigateur, avec l'accélération matérielle incluant XNNPACK pour le CPU, ML Drift pour le GPU et la future technologie WebNN pour les NPU.

Il peut être s'intégrer à JavaScript, TypeScript. 

Pour utiliser LiteRT :

import { loadLiteRt, loadAndCompile, Tensor } from '@litertjs/core';await loadLiteRt('path/to/wasm/directory/');const model = await loadAndCompile('path/to/your/model.tflite',{ accelerator: webgpu });const inputTypedArray = new Float32Array(1 * 3 * 244 * 244);const inputTensor = new Tensor(inputTypedArray, [1, 3, 244, 244]);const results = await model.run(inputTensor);// results is a Tensor stored on GPU. To move it to CPU & convert to a typedArray we useconst resultArray = (await results[0].moveTo('wasm')).toTypedArray();

Annonce : https://developers.googleblog.com/litertjs-googles-high-performance-web-ai-inference/
LiteRT : TensorFlow Lite est mort, vive LiteRT, Google veut un runtime IA unique partout

Soumis par francoistonic le
Image
Image

TensorFlow Lite s'appelle désormais LiteRT et surtout, le développement de LiteRT se fait désormais en dehors de la branche principale de TensorFlow. Ce dernier continue sa vie de son côté. LiteRT a l'ambition d'être un runtime d’inférence avec accélération matérielle pour réaliser de l'inférence locale.

LiteRT dispose de fonctions avancées d’accélération GPU/NPU. Il peut offrir des performances élevées pour les modèles d’IA et la GenAI, tout en simplifiant l’inférence sur le matériel dédié à l’IA.

Google annonce d'ailleurs :

  • des performances jusqu’à 1,4× supérieures par rapport à TensorFlow Lite, en s’appuyant sur les GPU et NPU

  • un modèle unifié pour mieux exploiter le matériel

  • la possibilité d’utiliser des modèles open source tels que Gemma

  • le support de PyTorch et JAX

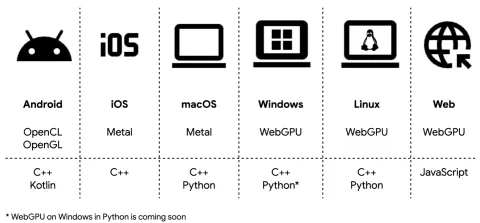
Comment obtenir des performances nettement supérieures ? Il n'y a pas de mystère : tout passe par l'accélération matérielle et l’utilisation des moteurs natifs. Par exemple : OpenCL et OpenGL sur Android, Metal sur iOS et macOS, WebGPU sur Windows, Linux et le Web.

C++ et Python sont les deux langages les plus répandus. L'équipe veut pousser plus loin l'intégration de LiteRT avec OpenCL, OpenGL, Metal et WebGPU. D'autre part, le framework intègre des optimisations importantes, par exemple sur la latence, l'exécution asynchrone et la gestion des ressources. Il faut éviter les surcharges inutiles (overheads)lors de la charge GPU.

Exemple d'une accélération GPU avec la nouvelle API CompiledModel API en C++ :

// 1. Create a compiled model targeting GPU in C++.auto compiled_model = CompiledModel::Create(env, "mymodel.tflite", kLiteRtHwAcceleratorGpu);// 2. Create an input TensorBuffer that wraps the OpenGL buffer (i.e. from image pre-processing) with zero-copy.auto input_buffer = TensorBuffer::CreateFromGlBuffer(env, tensor_type, opengl_buffer);std::vector<TensorBuffer> input_buffers{input_buffer};auto output_buffers = compiled_model.CreateOutputBuffers();// 3. Execute the model.compiled_model.Run(inputs, outputs);// 4. Access model output, i.e. AHardwareBuffer.auto ahwb = output_buffer[0]->GetAhwb();

L'autre intégration majeure concerne le NPU. Là encore, cette intégration doit fournir des gains de performances significatifs, tout en simplifiant le déploiement des flux sur le NPU. Cela passe par une compilation AOT (Ahead-of-Time) sur les SoC cibles, le déploiement PODAI sur Android et l’utilisation de LiteRT Runtime pour l’inférence, en déléguant la charge au NPU et en basculant vers le GPU si nécessaire.

Google fournit plusieurs composants :

  • LiteRT Torch Generative API : modèle Python permettant de créer et de convertir des modèles PyTorch vers les formats LiteRT-LM / LiteRT

  • LiteRT-LM : couche d’orchestration au-dessus de LiteRT pour gérer la complexité des LLM

  • LiteRT Converter & Runtime : moteur permettant d’exécuter, convertir et optimiser les modèles, avec une accélération matérielle transparente pour les développeurs et les applications

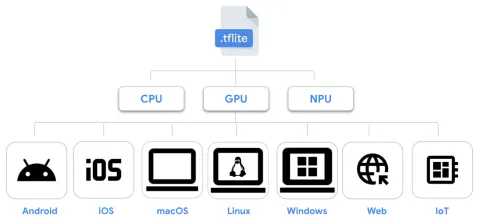
LiteRT n'est pas isolé. Il supporte PyTorch, TensorFlow et JAX. L'un des avantages majeurs de LiteRT est son support multiplateforme : IoT, Web, Windows, Linux, macOS, iOS et Android. Bref, Google peut proposer un modèle unifié presque partout.

Annonce : https://developers.googleblog.com/litert-the-universal-framework-for-on-device-ai/

GitHub : https://github.com/google-ai-edge/LiteRT