TensorFlow

LiteRT : TensorFlow Lite est mort, vive LiteRT, Google veut un runtime IA unique partout
Soumis par francoistonic le
Image
Image

TensorFlow Lite s'appelle désormais LiteRT et surtout, le développement de LiteRT se fait désormais en dehors de la branche principale de TensorFlow. Ce dernier continue sa vie de son côté. LiteRT a l'ambition d'être un runtime d’inférence avec accélération matérielle pour réaliser de l'inférence locale.

LiteRT dispose de fonctions avancées d’accélération GPU/NPU. Il peut offrir des performances élevées pour les modèles d’IA et la GenAI, tout en simplifiant l’inférence sur le matériel dédié à l’IA.

Google annonce d'ailleurs :

  • des performances jusqu’à 1,4× supérieures par rapport à TensorFlow Lite, en s’appuyant sur les GPU et NPU

  • un modèle unifié pour mieux exploiter le matériel

  • la possibilité d’utiliser des modèles open source tels que Gemma

  • le support de PyTorch et JAX

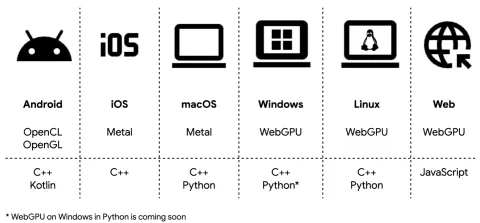
Comment obtenir des performances nettement supérieures ? Il n'y a pas de mystère : tout passe par l'accélération matérielle et l’utilisation des moteurs natifs. Par exemple : OpenCL et OpenGL sur Android, Metal sur iOS et macOS, WebGPU sur Windows, Linux et le Web.

C++ et Python sont les deux langages les plus répandus. L'équipe veut pousser plus loin l'intégration de LiteRT avec OpenCL, OpenGL, Metal et WebGPU. D'autre part, le framework intègre des optimisations importantes, par exemple sur la latence, l'exécution asynchrone et la gestion des ressources. Il faut éviter les surcharges inutiles (overheads)lors de la charge GPU.

Exemple d'une accélération GPU avec la nouvelle API CompiledModel API en C++ :

// 1. Create a compiled model targeting GPU in C++.auto compiled_model = CompiledModel::Create(env, "mymodel.tflite", kLiteRtHwAcceleratorGpu);// 2. Create an input TensorBuffer that wraps the OpenGL buffer (i.e. from image pre-processing) with zero-copy.auto input_buffer = TensorBuffer::CreateFromGlBuffer(env, tensor_type, opengl_buffer);std::vector<TensorBuffer> input_buffers{input_buffer};auto output_buffers = compiled_model.CreateOutputBuffers();// 3. Execute the model.compiled_model.Run(inputs, outputs);// 4. Access model output, i.e. AHardwareBuffer.auto ahwb = output_buffer[0]->GetAhwb();

L'autre intégration majeure concerne le NPU. Là encore, cette intégration doit fournir des gains de performances significatifs, tout en simplifiant le déploiement des flux sur le NPU. Cela passe par une compilation AOT (Ahead-of-Time) sur les SoC cibles, le déploiement PODAI sur Android et l’utilisation de LiteRT Runtime pour l’inférence, en déléguant la charge au NPU et en basculant vers le GPU si nécessaire.

Google fournit plusieurs composants :

  • LiteRT Torch Generative API : modèle Python permettant de créer et de convertir des modèles PyTorch vers les formats LiteRT-LM / LiteRT

  • LiteRT-LM : couche d’orchestration au-dessus de LiteRT pour gérer la complexité des LLM

  • LiteRT Converter & Runtime : moteur permettant d’exécuter, convertir et optimiser les modèles, avec une accélération matérielle transparente pour les développeurs et les applications

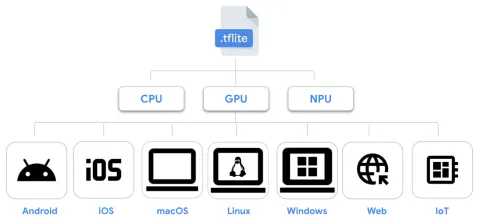
LiteRT n'est pas isolé. Il supporte PyTorch, TensorFlow et JAX. L'un des avantages majeurs de LiteRT est son support multiplateforme : IoT, Web, Windows, Linux, macOS, iOS et Android. Bref, Google peut proposer un modèle unifié presque partout.

Annonce : https://developers.googleblog.com/litert-the-universal-framework-for-on-device-ai/

GitHub : https://github.com/google-ai-edge/LiteRT

Sortie de TensorFlow 2.0

Soumis par fredericmazue le

TensorFlow est un outil de machine learning et de deep learning. Il expose une API en Python. Google l'utilise en interne, notamment pour Inception v3, son architecture de reconnaissance d'image.

Google a ouvert le code de TensorFlow en 2015. Moutain View a annoncé lundi la sortie de TensorFlow 2.0 en version finale.

Cette mouture met l'accent sur la simplicité et la facilité d'utilisation, selon les termes de Google. La construction de modèles avec Keras est présentée comme étant facile, et l'exécution rapide. C'est toujours selon Google, le plus gros point fort de cette version 2.0. Google souligne aussi avoir simplifié l'API en réduisant la duplication et en supprimant les terminaux obsolètes.

TensorFlow 2.0 fournit Keras en tant qu'API de haut niveau centrale utilisée pour créer et former des modèles. Keras fournit plusieurs API de création de modèle, telles que Séquentielle, Fonctionnelle et Sous-classification, ainsi qu'une exécution rapide, pour une itération immédiate, un débogage intuitif, et la construction de pipelines d'entrée évolutifs. Google renvoie à cette documentation pour plus de détails.

En revanche Google a effectué de nombreuses modifications d'API qui entraînent des incompatibilités avec les versions antérieures. En outre TensorFlow 2.0.0 est construit à l'aide de devtoolset7 (GCC7) sur Ubuntu 16. Cela peut entraîner des incompatibilités ABI avec des extensions construites à l'aide de versions antérieures de TensorFlow.

TensorFlow c'est aussi une notable amélioration de performances, grâce à une meilleure utilisation des GPU. TensorFlow 2.0 offre des performances d’entraînement jusqu’à trois fois plus rapides en utilisant une précision mixte sur les GPU Volta et Turing avec quelques lignes de code. TensorFlow 2.0 est étroitement intégré à TensorRT et utilise une API améliorée pour offrir une meilleure convivialité et de hautes performances lors de l’inférence sur les GPU NVIDIA T4 Cloud sur Google Cloud.

Kari Briski, directeur principal de la gestion des produits de logiciel d'informatique accélérée chez NVIDIA a commenté ainsi la sortie de TensorFlow 2.0  : "L'apprentissage automatique sur les GPU et les systèmes NVIDIA permet aux développeurs de résoudre des problèmes qui semblaient impossibles il y a quelques années. TensorFlow 2.0 est doté de nombreuses fonctionnalités d’accélération GPU exceptionnelles et nous avons hâte de voir les étonnantes applications d’IA que la communauté créera avec ces outils mis à jour."

[video:https://www.youtube.com/watch?&v=EqWsPO8DVXk autoplay:0]

Neural Structured Learning : un nouvel outil pour la plate-forme TensorFlow de Google

Soumis par fredericmazue le

Google vient d'ajouter un nouveau framework à sa plate-forme de machine learning TensorFlow : Neural Structured Learning.

Neural Structured Learning (NSL) est un framework open source pour la formation de réseaux neuronaux profonds avec des signaux structurés. Il implémente Neural Graph Learning , qui permet aux développeurs de former des réseaux de neurones à l’aide de graphes. Les graphiques peuvent provenir de multiples sources, telles que des graphiques de connaissances, des dossiers médicaux, des données génomiques ou des relations multimodales (par exemple, des paires image-texte). NSL se généralise également avec l’apprentissage contradictoire, où la structure entre les exemples d’entrée est construite de manière dynamique en utilisant une perturbation contradictoire.

L'apprentissage neuronal structuré (NSL) peut être appliqué à la construction de modèles précis et robustes pour la vision, la compréhension du langage et la prédiction en général.

La structure NSL de TensorFlow fournit les API et les outils suivants faciles à utiliser pour permettre aux développeurs de former des modèles avec des signaux structurés :

  • API Keras pour permettre une formation avec des graphes (structure explicite) et des perturbations contradictoires (structure implicite).
  • TF ops et fonctions pour permettre la formation avec la structure lors de l’utilisation des API TensorFlow de niveau inférieur
  • Des outils pour construire des graphiques et construire des entrées de graphique pour la formation

Site : www.tensorflow.org/neural_structured_learning

Google recrute Chris Lattner

Soumis par fredericmazue le

Chris Lattner est un ingénieur informatique éminent. Il est connu notamment pour être le principal auteur du compilateur Clang et de la plate-forme LLVM.

Ayant rejoint Apple en 2005 il a été responsable de l'environnement de programmation Xcode et il est à l'origine de Swift, le langage maison d'Apple qui doit à terme remplacer Objective C.

Chris Lattner a quitté Apple en 2017 pour rejoindre Tesla Motors et y devenir le vice-président de l'équipe travaillant sur le développement d'un système autopilote.

Mais cette collaboration avec Tesla Motors aura finalement été de courte durée. Chris Lattner vient d'être recruté par Google. Ni l'un ni l'autre n'ont donné des indications sur ses nouvelles fonctions à Mountain View, mais selon Bloomberg, Chris Lattner devrait travailler sur TensorFlow, l'outil de machine learning de 2ème génération de Google.

TensorFlow est disponible en version finale

Soumis par fredericmazue le

Google utilise l'intelligence artificielle dans de nombreux domaines : la reconnaissance vocale, la recherche d'images, le pilotage de sa voiture autonome,  son moteur de recherche bien évidemment, et pour cela développe ses propres outils.

Fin 2015, Google a ouvert le code de son outil de machine learning deuxième génération : TensorFlow. Tout calcul qui peut être exprimé par un graphe de flux peut être traité par TensorFlow, précisait alors Mountain View qui ajoutait que TensorFlow est doué de facultés de deep learning.

Un après cette ouverture TensorFlow, a aidé de nombreux chercheurs ingénieurs, artistes et étudiants à progresser dans des domaines tels que la traduction, la détection des cancers de la peau, ou la prévention de la cécité chez les diabétiques, souligne un billet de blog de Google qui annonce la disponibilité de TensorFlow en version finale 1.0.

TensorFlow 1.0, qui a été présenté lors du TensorFlow Developer Summit 2017, a fait d'impressionnants progrès en termes de performances, d'après le billet, notamment grâce à son nouveau compilateur XLA qui exploite au mieux les CPU et GPU des machines. D'après Google, Inception V3, son architecture de reconnaissance d'images, voit ses performances améliorées par un coefficient 7.3 sur une machine à 8 GPU et par un coefficient 58 sur une machine équipée de 64 GPU.

TensorFlow est également plus facile à manier avec l'arrivée de nouveaux modules Python dont un, tf.keras, qui apporte la compatibilité avec Keras, une autre libraire de réseaux neuronaux.

Les API Python ont été revues pour ressembler plus étroitement aux API NumPy, ce que de nombreux chercheurs apprécieront probablement. Enfin, travailler avec TensorFlow n'oblige plus à utiliser Python. Il est désormais possible de le faire en Java ou en Go, même si le support de ces langages est pour l'instant expérimental.

 TensorFlow peut être téléchargé depuis son site dédié : www.tensorflow.org

[video:https://www.youtube.com/watch?v=LqLyrl-agOw autoplay:0]

[video:https://www.youtube.com/watch? v=mWl45NkFBOc autoplay:0]

TensorFlow accessible depuis iOS

Soumis par fredericmazue le

TensorFlow est la deuxième génération d'outils de machine learning développés par Google. Tout calcul qui peut être exprimé par un graphe de flux peut être traité par TensorFlow, précise Mountain View. En outre TensorFlow est doué de facultés de deep learning. TensorFlow est derrière beaucoup de services Google. Par exemple, c'est TensorFlow qui analyse et classe les photos sur Google Photos. C'est encore TensorFlow qui est derrière AlphaGo et les récents succès de celui-ci.

L'outil est un outil de recherche, également utilisable pour des produits réels. Ce à quoi tout un chacun peut s'essayer puisque Google a placé TensorFlow en open source en novembre 2015. TensorFlow consiste en des librairies et leurs outils associés, des didacticiels et des exemples, le tout sous licence Apache 2.0. Une interface en Python permet de communiquer avec TensorFlow, pour lui soumettre vos graphes de flux.

Mountain View vient de publier la version 0.9 RC de TensorFlow, une mouture qui apporte son lots d'amélioration, et qui séduira particulièrement les utilisateurs des machines Apple.

En effet TensorFlow 0.9 supporte les traitements avec les GPUs sur Mac OS et désormais iOS est supporté. Concrètement, les développeurs peuvent donc enrichir leurs applications avec l'intelligence artificielle de Google.  

Google : une formation gratuite au Deep Learning

Soumis par fredericmazue le

Fin 2015, Google publiait en open source TensorFlow, son outil de machine learning 2ème génération. Un outil doté de capacités de Deep Learning également.

Selon Google, cette publication est un succès. Les sources de TensorFlow ont été téléchargés plus de 4000 fois en quelques semaines

C'est dans ce contexte que Google lance une formation gratuite au Deep Learning. Cette formation est développée en collaboration avec Udacity.

La formation, qui s'appuie sur TensorFlow, consiste en 4 cours en vidéo. allant des bases du machine learning, à la reconnaissance d'images et aux réseaux de neurones récurrents.

Cette formation, si elle est ouverte à tous, demande quand même un bagage minimum. Pour le moins savoir manipuler les dépôts GitHub et avoir une bonne maîtrise en Python. Des connaissances en mathématiques sont requises également : différentielles, intégrales, dérivées partielles, etc.

Les pré-requis sont détaillés sur la page d'inscription.