Android Bench teste des tâches sur plusieurs jours, la réussite des LLM s'effondre
ven, 18/09/2026 - 11:12
Android Bench est un benchmark des LLM du marché proposé par Google. Android Bench 2.0 pousse plus loin avec des tâches plus complexes sur plusieurs. Et là, les résultats peuvent d'effrondrer. Un des défis pour ces modèles n'est plus de générer du code mais mener à mener à son terme des tâches très complexes. Cette approche est appelée long-horizon tasks ou LHT.
La premier bench avait mis en place une méthodologie avec des tâches "simples" sur quelques heures pour comparer les LLM. Pour améliorer les mesures face aux évolutions rapides des modèles, le comparatif s'appuie sur le framework Harbor. Et surtout, cette v2 pousse les LLM en demander des tâches nécessitant plusieurs jours pour pouvoir être résolues.
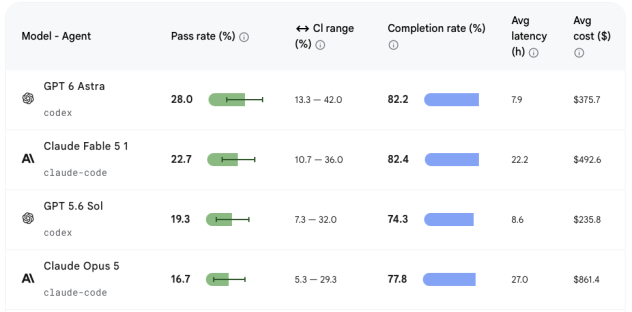
Les résultats illustrent toute la difficulté pour LLM à rédoudre des tâches très complexes sur une longue durée. GPT 6 Astra affiche un ratio de réussite de 28 % pour un taux de complétion de 82,2 % pour une dépense total de 375 $. Fable 5.1 tombe à 22 % pour 492 $. Claude Opus 5 est le plus cher, 861 $ pour une réussite de 16,7 %. Dans le bench 1.0, les meilleurs LLM dépassaient largement les 80 %.
Pour en savoir plus : https://developer.android.com/bench