référencement

Pages satellites : Google va durcir son algorithme

Soumis par fredericmazue le
Web

La nouvelle est d'importance pour les webmasters qui travaillent au référencement de leurs sites. Google va durcir son algorithme, afin de pénaliser les pages satellites. Mountain View en a fait l'annonce dans ce billet de blog en français.

Les pages satellites sont des pages conçues uniquement dans le but d'amener au final le visiteur d'un site sur une même page. Ces pages apparaissent toutes dans les résultats de recherche, elles sont conçues pour cela, mais elles ne sont en fait qu'un seul contenu. Google explique :

Nous insistons depuis longtemps sur le fait que les pages satellite créées uniquement à l'intention des moteurs de recherche peuvent nuire à l'expérience de recherche des internautes.

Par exemple, les internautes peuvent obtenir une liste de résultats qui les redirigent tous vers le même site. Imaginons qu'un internaute clique sur un résultat et ne soit pas satisfait. Il clique alors sur le résultat suivant de la page de résultats de recherche, mais s'il se retrouve sur le même site, il y a fort à parier qu'il sera frustré.

Au fil du temps, nous avons constaté que certains sites cherchaient à maximiser leur "empreinte sur la recherche" sans apporter de valeur ajoutée unique. Ces campagnes satellite peuvent prendre des formes différentes : différentes pages sur un même site, sur plusieurs domaines ou un mélange des deux. Pour offrir aux internautes des résultats de recherche plus pertinents, nous allons prochainement apporter un ajustement au système de classement pour mieux gérer ce type de pages. Ce changement devrait entraîner une différence notable pour les sites qui possèdent des campagnes satellite importantes et bien établies.

Ajustement et différence notable se traduisent par pénalité dans le référencement. Les webmasters ont donc tout intérêt à faire les ménages et supprimer rapidement les pages satellites de leurs sites.

Penguin 3.0 aura du retard

Soumis par fredericmazue le
Web

Est-ce un effet du réchauffement climatique, de la réduction de la banquise ? Toujours est-il que le nouvel algorithme concocté par Google, Penguin 3.0, dont nous vous annoncions l'arrivée  au début de ce mois, aura du retard.

Combien de retard ? Dans un Google Hangout, John Muller fait une réponse à la Fernand Reynaud.

Penguin 3.0 arrivera dans un certain temps, lorsque Google, qui y travaille dur, sera sûr que tout fonctionne bien. Ce certain temps est de l'ordre de quelques semaines. Pas moins, mais pas beaucoup plus :-)

Pour mémoire, Penguin 3.0 est ce qui remplace le vieux PageRank de Google. Cet algorithme tient grand compte des retroliens. Penguin 3.0 veut tout particulièrement pénaliser les rétroliens artificiels, comme des liens payants ou des rétroliens placés dans des ferme de contenus, voire des fermes de liens.

Les webmasters doivent être attentifs à cela et désavouer les rétroliens qu'ils jugent néfastes, en suivant les instruction de cette page fournie par Google.

[video:https://www.youtube.com/watch?v=XzzY2T2Ph8w&feature=youtu.be&t=48m25s]

Intégrez votre propre moteur de recherche au sein des résultats de Google

Soumis par fredericmazue le
Web
Image

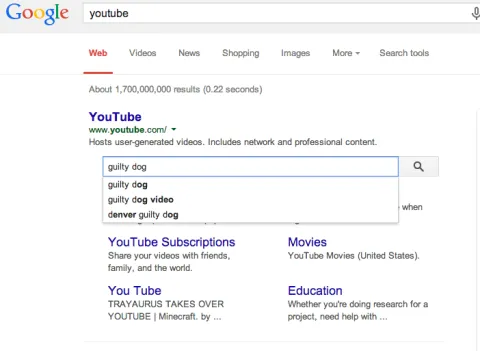
Dans un billet de blog, Google explique qu'il est désormais possible d'intégrer votre propre moteur de recherche dans les résultats.

Plus spécifiquement, ceci concerne les résultats dits sitelinks. Des résultats qui rassemblent des liens concernant un seul site, soit parce que l'algorithme de Google a jugé que c'est ce qui devait résulter d'une requête, soit parce que l'utilisateur a demandé explicitement des résultats pour un site particulier, par exemple en donnant site: programmez.com ou encore site:programmez.com langages comme requêtes.

Dans un tel cas, vous avez désormais la possibilité de personnaliser la petite boîte de recherche qui apparaît au dessus des sitelinks et qui permet d'affiner les résultats de la recherche. Il s'agit d'un champ de recherche avec autocompletion.

Pour cela, le webmaster doit bien entendu disposer avant tout de son propre moteur de recherche sur son site. Ensuite il doit insérer un peu de JavaScript dans sa home page afin de renseigner une balise schema.org. 

Concrètement il s'agit de la balise SearchAction, propriété target. La balise intègre l'URL du moteur de recherche du site, moteur que Google invoquera le cas échant.

<script type="application/ld+json">
{
   "@context": "http://schema.org",
   "@type": "WebSite",
   "url": "https://www.example-petstore.com/",
   "potentialAction": {
     "@type": "SearchAction",
     "target": "https://host.example-petstore.com/search?q={search_term}",
     "query-input": "required name=search_term"
   }
}
</script>

Pour les sites qui ne proposeront pas de moteur de recherche de cette manière, Google continuera de fonctionner comme il le faisait auparavant.

Plus d'informations et de bonnes pratiques à cette page.

La Google Webmaster Academy arrive en français

Soumis par fredericmazue le
Web

La Webmaster Academy est une initiative lancée par Google en 2012. Le but est de fournir des informations et des conseils pour créer une site web de qualité et bien référencé.

La Web Academy propose des module de formations, d'une durée d'une heure environ, pour, entres autres, bien comprendre comment fonctionne la recherche Google ainsi que les outils pour webmaster (Google Webmasters Tools). Elle propose aussi des questionnaires qui vous permettront de vérifier vos connaissances.

Google vient d'annoncer la disponibilité du contenu de la Webmaster Academy en 22 nouvelles langues, dont le français.

Site  : https://support.google.com/webmasters/answer/6001102

Google a modifié 890 fois son algorithme de recherche en 2013 !

Soumis par fredericmazue le
Web

Google a été introduit en bourse il y a 10 ans, le 19 août 2004. A cette occasion, Amit Singhal, a publié sur Google+ un billet rétrospective sur les 10 plus grandes innovations apportées par l'outil depuis 10 ans.

L'auto-completion (qui amuse souvent les internautes par ses incongruités), la pertinence, le Knowledge Graph, etc.

Le travail accompli est indéniable et que Google communique sur le sujet semble légitime et justifié.

Cependant, le billet d'Amit Singhal se termine par une phrase redoutable qui passe presque inarperçue: l'algorithme du moteur de recherche a été modifié 890 fois - pour des améliorations bien sûr :-) - au cours de la seule année 2013.

Et là, on ne peut pas dire que Google communique beaucoup... Bien sûr, Google publie de grandes lignes directrices à l'intention des webmasters afin qu'ils puissent soigner leur référencement. Mais en ce qui concerne ces modifications, plus de 2 par jours quand même, c'est l'opacité totale, et le référencement tend de plus en plus a devenir de la magie vaudou. 

L'algorithme Panda 4.0 pénaliserait fortement les sites bloquant l'accès aux ressources CSS et JavaScript

Soumis par fredericmazue le
Web

A lire, un très intéressant billet de blog sur yoast.com L'auteur explique avoir constaté une chute de 50% du trafic sur les sites qu'il gère, consécutivement à la mise en place de l'algorithme Panda 4.0 par Google.

Selon lui, la raison de cette chute du trafic était l'interdiction faite au robot de Google  d'accéder aux ressources CSS et JavaScript. Interdiction faite par le fichier robots.txt.

Toujours selon l'auteur de ce billet, cette interdiction perturbe le robot de Google qui ne peut plus savoir déterminer où sont les emplacements publicitaires dans les pages des sites dans un tel cas. Ce qui semble sujet à caution.

Cependant, l'auteur fait remarquer, sans doute très pertinemment, que justement un nouveau bouton est apparu dans les Webmasters Tools de Google : Explorer et afficher. (Explorer comme en étant le robot de Google s'entend) Utiliser ce bouton permet justement de savoir très précisément si votre fichiers robots.txt bloque l'accès à de tels ressources, et si oui lesquelles.

Selon l'auteur du billet, avoir donné l'accès à ces ressources en corrigeant le fichier robots.txt des sites pénalisés a provoqué une "remarquable résurrection".

Panda 4.0 est-il aussi sévère ? A chaque webmaster de le vérifier. Quoi qu'il en soit, Google, dans ses recommandations aux webmasters, a toujours indiqué qu'il ne fallait pas bloquer l'accès aux fichiers CSS et JavaScript, blocage qui est souvent fait avec l'intention d'économiser de la bande passante. Ce qui est une mauvaise idée.

Google améliore le référencement des contenus générés par JavaScript et va fournir un outil dans les Webmaster Tools

Soumis par fredericmazue le
Web

En 1998, lorsque nous faisions fonctionner nos serveurs dans le garage de Susan Wojcicki, nous n'avions pas vraiment à nous préoccuper des fichiers JavaScript ni des feuilles de style CSS. Ces ressources étaient peu utilisées. Telle est l'introduction d'un billet écrit par Michael Xu et Kazushi Nagayama, sur le blog Webmaster Central.

Billet qui nous explique qu'assez rapidement Google s'est affranchi du strict texte brut, pour interpréter JavaScript, afin que le système d'indexation affiche un rendu plus fidèle de bon nombre de pages Web, pour mieux refléter ce qu'un internaute ordinaire voit avec le langage JavaScript activé dans son navigateur.

De nombreux progrès ont été effectués en ce domaine selon ce billet, qui pour l'occasion récapitule quelques problèmes que l'interprétation de JavaScript peut induire.

Tout d'abord, si un fichier robots.txt bloque l'accès aux ressources (CSS ou JavaScript), le contenu correspondant ne pourra pas être indexé.  Un serveur qui ne serait pas capable d'assurer à ce niveau (dans le cas de gros volumes d'exploration de la part du robot) provoquera des problèmes du même ordre.

Un contenu qui est supprimé par le code JavaScript ne peut pas être indexé.

Si le code JavaScript est trop complexe ou trop obscur :-) le contenu correspondant ne sera pas indexé correctement.

Mais comment le webmaster d'un site peut-il savoir si son code JavaScript pose des problèmes au robot de Google ?  Bonne nouvelle, les Webmasters Tools vont bientôt proposer un outil qui permettra de mieux comprendre comment Google travaille à ce niveau. 

Google déploie son algorithme Panda 4.0

Soumis par fredericmazue le
Web

Matt Cutts, le responsable du référencement dans Google, a annoncé la nouvelle dans un tweet : Google déploie la mouture 4.0 de son algorithme Panda.

Panda a déjà provoqué pas mal de dégâts en ce qui concerne le trafic sur certains sites. Certes Panda a pour vocation de mettre en avant les sites et les contenus de qualité, ce qui est louable sur le plan de l'intention, mais comment procède-t-il ? Nul en dehors de Google n'en sait rien.

Alors quelles seront les conséquences de l'arrivée de Panda 4.0 ? Nul n'en sait rien non plus, car Google n'a absolument pas communiqué sur les changements apportés à l'algorithme. Un simple tweet et c'est tout... Un manque d'information, pour ne pas dire une opacité sans cesse plus opaque, qui courrouce webmasters et responsables de sites...

Mi mars dernier, Matt Cutts avait déclaré au Search Marketing Expo que Mountain View est conscient que plus un site est gros, plus il est bien positionné dans les résultats de recherche. Notoriété qui lui permet de grossir. Cercle vertueux pour les gros sites, mais évidemment beaucoup moins vertueux pour les petits sites. Donc à cette occasion, Matt Cutts avait évoqué un changement dans l'algorithme de référencement qui valoriserait mieux les petits sites et les sites des petites entreprises.

Panda 4.0 amène-t-il ces changements promis ? Pour l'instant mystère... Surveillez vos statistiques Analytics...

Google envisagerait de privilégier les sites en HTTPS

Soumis par fredericmazue le
Web

Selon le Wall Street Journal qui s'appuie sur une source proche du dossier relatant des conversations privées de Matt Cutts, le responsable du moteur de recherche de Google, Mountain View envisagerait de favoriser les sites qui emploient le protocole HTTPS pour crypter les données, lors de la communication entre le navigateur et le serveur.

Pour l'instant l'idée n'en est qu'au stade de la discussion. et un tel changement n'est pas pour demain, toujours selon le Wall Street Journal. 

Changer de nom de domaine ne retire pas une pénalité Google

Soumis par fredericmazue le
Web

John Mueller explique que si l'algorithme Pengouin pénalise un de vos sites, parce que des rétroliens artificiels pointent sur lui, changer le nom de domaine du site ne fera pas disparaître la pénalité.

Ceci même si aucune redirection 301 n'est faite. Selon John Muller, l'algorithme de Google sait reconnaître un site à son contenu et est donc capable de se rendre compte qu'un site a déménagé. C'est d'ailleurs nécessaire quand aucune redirection 301 n'est faite, parce que le responsable du site ne sait pas le faire, ou ne peut pas le faire.

Pour en revenir à la pénalité, le seul moyen de l'annuler est de retirer les mauvais rétroliens, ou de les désavouer.

[video:http://www.youtube.com/watch?v=ArBkHv4r4Yc]