big data

Pivotal lance Greenplum, un data warehouse open source à traitement massivement parallèle

Soumis par fredericmazue le

Pivotal vient de dévoiler le premier data warehouse open source à traitement massivement parallèle (MPP, Massively Parallel Processing). Fruit de 10 années de développement et de presque deux millions de lignes de code, Greenplum Database incarne la toute dernière solution core data de Pivotal, commercialisée sous licence Apache Software 2.0.

Greenplum Database se distingue des autres systèmes de traitement de données open source (Apache Hadoop(r), MySQL, PostgreSQL) par son utilisation de la technologie MPP. Résultat, selon Pivotal : Greenplum Database exécute des analyses SQL complexes sur d’énormes volumes de données, à des vitesses plusieurs fois supérieures à toute autre solution testée à ce jour.

« Nous sommes persuadés que l’ouverture du code source d’un data warehouse si largement adopté va produire un effet de levier sur l’ensemble du secteur. En abaissant les barrières à l’entrée d’une analyse temps réel à grande échelle, l’open source permet à davantage d’entreprises de relever les défis du Big Data. Par conséquent, nous pensons voir aboutir un plus grand nombre de projets Big Data d’envergure dans tous les secteurs d’activité.

Avec la sortie d’une base de données aussi fiable et substantielle, nous prévoyons l’émergence rapide d’une forte communauté Greenplum, appelée à stimuler l’innovation Big Data à un moment où le secteur et les clients en ont le plus besoin. 

Pour la communauté open source, cette étape marque une évolution majeure. À l’image de Pivotal, beaucoup d’éditeurs de progiciels voient dans l’open source un moyen plus efficace de développer des logiciels. L’open source offre en effet aux clients l’assurance que leurs besoins seront satisfaits sur le long terme, sachant qu’ils peuvent modifier et enrichir directement le code sous-jacent.

Les éditeurs eux-mêmes ont également tout à y gagner, car de nombreux clients ne voient que par l’open source. Pour répondre à leurs demandes, de grands éditeurs de logiciels se résolvent donc à ouvrir le code source de tous leurs produits cloud et de traitement de données dans les 10 prochains mois — soit presque 10 millions de lignes de code. Dans cette nouvelle ère de l’informatique, les éditeurs commerciaux du monde entier doivent se rendre à l’évidence : les beaux jours des modèles de codes propriétaires et verrouillés sont bel et bien révolus. » explique l'éditeur.

Des ressources et le code source sont disponibles à l’adresse greenplum.org.
MOOC & Big Data : Saison 2 des Talents de la programmation in-memory

Soumis par fredericmazue le

Devant le succès de la 1ère saison du MOOC des talents de la programmation " in memory ", le Groupe AVISIA, cabinet de conseil et réalisation de projets data centric et la direction Académique de SAS France lancent la saison 2.

Pour rappel, cette plateforme d'auto-apprentissage aux concepts in-memory, unique en France, est née de l'ambition de faire découvrir un environnement de développement adapté à la Data Science et de constituer la première communauté d'utilisateurs SAS In-Memory Statistics.

Face à l'engouement des inscriptions et à la participation active des membres de la communauté, une deuxième session verra le jour début novembre et sera lancée lors de SAS Forum.

La saison 2 conservera l'ensemble des caractéristiques qui ont fait le succès du concept avec la mise en place d'une plateforme, de ressources d'auto-apprentissage (tutoriel et exercices) et d'un challenge permettant la certification des compétences.

Mais il y aura également plusieurs nouveautés avec principalement la mise en place de différents niveaux de certification (base / confirmé / avancé).
Comme lors de la 1ère édition, ce programme est ouvert à tous et s'adresse aux étudiants ou professionnels en Business intelligence, Big Data & Data Science.

Informations et inscription sur le site

SUSE dévoile le programme de la SUSECon 2015

Soumis par fredericmazue le

SUSE a dévoilé le programme son évènement SUSECon 2015, ainsi que le programme des sessions. Organisées à l’occasion de la conférence mondiale des utilisateurs de SUSE qui aura lieu à Amsterdam du 2 au 6 novembre 2015, ces sessions aborderont les dernières innovations concernant les technologies open source et Linux. Le Big Data, le stockage logiciel, le cloud computing, le zero downtime (élimination des temps d'arrêt planifiés et non planifiés), la standardisation des datacenters, les conteneurs et la plateforme Docker, ainsi que l’environnement SAP sur Linux figurent parmi les sujets qui seront abordés tout au long de la conférence SUSECon.

« La conférence SUSECon d’Amsterdam est un lieu de rencontre où nos clients, nos partenaires et les membres de la communauté peuvent échanger des idées et partager leurs expériences », a déclaré Rich Wiltbank, responsable Customer Enablement pour SUSE. « Placée sous le thème « always open », la conférence SUSECon propose des formations sur les dernières solutions basées sur Linux, OpenStack et Ceph, des interventions techniques, ainsi que des démonstrations où seront présentées des solutions open source développées par SUSE et ses partenaires. Les clients des entreprises les plus modernes découvriront en direct comment optimiser leur datacenter et adopter de nouvelles technologies tout en conservant la maîtrise de leur croissance et de leurs coûts. »

« Nous avons l’habitude de participer à la SUSEcon, c’est un événement important pour nous en tant que client afin de pouvoir échanger avec les différents experts SUSE, être tenu au courant des prochaines innovations à prévoir et être sûrs d’utiliser les solutions SUSE à leur plein potentiel afin de répondre aux attentes de nos équipes et atteindre nos objectifs » explique M. Yves Dumazy, Responsable Technique Linux Unix chez oXya.

Le programme des sessions proposées lors SUSECon 2015 comprend plus de 120 sessions pratiques (tutoriels, études de cas, perspectives d’avenir, présentations générales, etc.), qui étudieront en profondeur sur la technologie et les futures innovations dans le domaine des datacenters.

Principales sessions :

  • OpenStack & Ceph, an Update of Enterprise Use-Cases at BMW — BMW fera le point sur l’évaluation technologique de l’année dernière et présentera les tout derniers résultats enregistrés en environnement de production.
  • Real-time Data Analysis with Hadoop and SAP HANA — Cette session expliquera les avantages métier et les aspects architecturaux et techniques associés à l’intégration des deux grandes solutions de données leaders sur le marché.
  • Hands on with SUSE Enterprise Storage — Les participants pourront découvrir les nouvelles fonctionnalités de SUSE Enterprise Storage et apprendre à déployer un cluster de stockage.
  • Software Defined Everything – Management, Cloud, Containers and Storage — L’évolution du datacenter se poursuit. Les participants découvriront les dernières avancées dans le domaine de la virtualisation des centres informatiques et des outils de gestion nécessaires pour déployer, surveiller et gérer un environnement de plus en plus complexe.

Lors de la conférence SUSECon, huit trophées Partenaires et Clients seront décernés aux entreprises qui ont mis en œuvre une solution de SUSE de façon optimale pour contrôler leur infrastructure informatique, optimiser leurs ressources informatiques et déployer un environnement innovant. Les lauréats seront invités à SUSECon. Pour de plus amples informations sur les modalités de participation, visitez le site susecon.com/awards.html. Informations complémentaires sur la conférence SUSECon et inscriptions sur le site www.susecon.com. 

Les développeurs peuvent y acquérir une expérience pratique ou obtenir une assistance technique pour créer des applications de calcul intensif basées sur OpenPOWER

Soumis par fredericmazue le
Image

IBM, en collaboration avec NVIDIA et Mellanox, annoncent aujourd'hui la création d'un centre de design et d'accélération POWER à Montpellier, pour faire avancer le développement de la recherche autour des problématiques axées sur les données, ainsi que celui d’applications industrielles et commerciales. Les développeurs peuvent y acquérir une expérience pratique ou obtenir une assistance technique pour créer des applications de calcul intensif basées sur OpenPOWER

Né de l'esprit de collaboration qui anime la fondation OpenPOWER, IBM, NVIDIA et Mellanox ont décidé de fournir des ressources supplémentaires pour du développement et du portage applicatif Open Source autour du calcul intensif.

Membres fondateurs de la fondation OpenPOWER, ces trois compagnies partagent la même vision sur la nécessité de développer de nouveaux systèmes et d'accélérer leur mise sur le marché pour s'attaquer aux challenges du Big Data.

Au-delà de l'extension de l'écosystème autour d'OpenPOWER, cette  collaboration entre les trois compagnies va créer des  opportunités de développement de nouvelles technologies à valeur ajoutée pour les clients.

45 postes en CDI sont à pourvoir chez Infotel

Soumis par fredericmazue le

Infotel recrute 45 postes dans ses agences de Lyon, Nice, Aix-en-Provence et Monaco.  Les agences d’Infotel dans le Sud-Est de la France (Lyon, Nice, Aix-en-Provence et Monaco) permettront aux nouvelles recrues de se spécialiser au contact de grands comptes internationaux sur des technologies telles que la mobilité et le Big Data. La présence de sociétés comme Airbus Helicopters, Air France, IT-CE, i-BP ou encore l’Office Européen des Brevets, dans le portefeuille clients d’Infotel est le reflet d’une expertise de pointe.

« Avec plus de 13 agences en France, Infotel offre la flexibilité d’une entreprise locale et la force d’un groupe d’envergure nationale. Notre plan de recrutement dans la région Sud-Est, nous permet d’asseoir notre position sur un marché toujours plus concurrentiel. En effet, cet objectif de recrutement est en corrélation avec nos ambitions qui allient développement et diversification. Nous avons mis un point d’honneur à recruter un grand nombre de juniors avec moins deux ans d’expérience, ce qui représente environ 60 % de nos embauches » souligne Jean-Marie MEYER, Directeur Général d’Infotel.

45 postes en CDI sont à pourvoir dans les agences Sud-Est d’Infotel :

  • 10 à Lyon
  • 10 à Nice
  • 20 à Aix-en-Provence
  • 5 à Monaco

Infotel propose des CDI, des stages de fin d’études ainsi que des formations pour les jeunes diplômés. Les annonces sont destinées à recruter des profils juniors ou plus expérimentés et correspondent aux métiers suivants : Ingénieur d’Études .NET (Asp.NET, C#, Sharepoint), Ingénieur d’Études Java JEE/HTML5 (AngularJS, Spring), Ingénieur d’Études Android (SDK Android, API Rest), Ingénieur d’Études iOS (Swift, Objective-C), Ingénieur d’Études Big Data (Hadoop, Mongo DB, Elastic), Analystes fonctionnels Banque/Assurance (z/OS, DB2, Pacbase, Cobol), Ingénieurs d’Études décisionnel (BO, SAS, ODI, Informatica…), Chefs de projets MOA et MOE, PMO, Techniciens réseaux et Chefs de projet déploiement. 

Infotel recherche 120 nouveaux collaborateurs dans la région Ile-de-France

Soumis par fredericmazue le

Infotel recrute près de 300 nouveaux collaborateurs pour l’année 2015 sur tout le territoire français dont 120 postes dans ses agences parisiennes.

Les agences parisiennes d’Infotel (Bagnolet, Nanterre, Neuilly) permettront aux nouvelles recrues de se spécialiser au contact de grands comptes internationaux sur des technologies telles que la mobilité et le Big Data. La présence de sociétés comme Airbus, Air France, PSA Peugeot Citroën, BNP Paribas ou encore, l’Office Européen des Brevets, dans le portefeuille clients d’Infotel est le reflet d’une expertise de pointe.

« Avec plus de 13 agences en France, Infotel offre la flexibilité d’une entreprise locale et la force d’un groupe d’envergure nationale. Nous avons à cœur de faciliter l’insertion des jeunes dans le monde professionnel, c’est pourquoi, 50 % des recrutements en Ile-de-France seront des jeunes diplômés. Nous proposons également 25 stages de fin d’études » souligne Michel Koutchouk, Directeur Général d’Infotel.

120 postes en CDI sont à pourvoir dans les agences parisiennes Infotel.

Infotel propose des CDI, des stages de fin d’études ainsi que des formations pour les jeunes diplômés. Les annonces sont destinées à recruter des profils juniors ou plus expérimentés et correspondent aux métiers suivants : Ingénieur d’Études .NET (Asp.NET, C#, Sharepoint), Ingénieur d’Études Java JEE / HTML5 (AngularJS, Spring), Ingénieur d’Études Android (SDK Android, API Rest), Ingénieur d’Études iOS (Swift, Objective-C) et Ingénieur d’Études Big Data (Hadoop, Mongo DB, ElasticSearch).


Microsoft TechDays 2015

Soumis par fredericmazue le

Après le succès de l’édition 2014, les TechDays reviennent : 3 jours, 18 000 visiteurs et invités de marque réunis. 
Le Palais des Congrès s'habille des couleurs de Microsoft et de ses partenaires. Développeurs, professionnels de L'IT, décideurs IT et métiers, vous découvrirez les dernières innovations développées autour des technologies Microsoft et les enjeux de la transformation numérique.

Ambient Intelligence est le thème que nous avons choisi pour les TechDays 2015. Mobilité, cloud, big data, machine learning, objets connectés : l’Ambient Intelligence sera au cœur des sessions et des zones d’exposition.

Du 10 au 12 février 2015, au Palais des Congrès de Paris

Site officiel et inscription gratuite : https://techdays.microsoft.fr/default.aspx

Le SDK Google Cloud Dataflow est disponible

Soumis par fredericmazue le

Google Cloud Dataflow est une plate-forme, pour l'instant en phase de développement alpha, dont le but est de démocratiser le traitement de gros volumes de données en fournissant des accès faciles et adaptables à celles-ci aux développeurs,  datascientists et analystes.

Google vient d'annoncer la disponibilité d'un SDK Java pour Cloud Dataflow. Ce SDK permet de mettre en place des pipelines de traitements parallèles de flux de données.  Ce SDK est open source. Une version basée sur Python 3 du SDK est en préparation.

Télécharger le SDK Cloud Dataflow.

Jeune, geek et stressé : le portrait du Data scientist

Soumis par fredericmazue le
Image

SAS, acteur sur le marché de la  business analytics, a dévoilé les résultats d'une étude réalisée en Grande-Bretagne et en Irlande sur le métier de Data scientist, le fameux mouton à cinq pattes recherché par les entreprises afin d'exploiter et tirer profit de leurs Big Data.

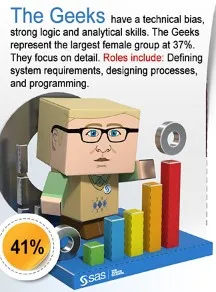
Si l'enquête met au jour dix profils types de data scientists, du Gourou, évangéliste au statisticien, un profil majoritaire se dégage : le data scientist Geek, à la fois analytique, logique et technique (41%). Mais les aptitudes à la créativité et à la communication apparaissent comme marquante s.

Pour réaliser cette enquête, SAS a interrogé 596 professionnels des "data sciences", dont l'influence se ressent déjà dans de nombreux domaines, de la recherche médicale au marketing, en passant par les services financiers ou la prévention des incendies. Cette révolution des données n'est pas sans avoir de grandes répercussions tant sur les réservoirs de talents des entreprises que dans le monde universitaire.

Des postes sous pression : de grandes responsabilités sans l'appui de l'expérience
Les entreprises attendent beaucoup des Data scientists : des compétences techniques, mathématiques, mais aussi sur les métiers et des aptitudes à la communication. Pourtant 55% des data scientists ont moins de trois ans d'ancienneté dans ce métier !

Plus d'un quart des data scientists interrogés sont contraints de s'adapter afin de remplir des fonctions qui ne correspondent pas tout à fait à leurs compétences ou leur personnalité. Cette pression génère un fort niveau de stress professionnel (pour 55% des data scientists interrogés).

"Les entreprises doivent mieux identifier et définir ce qu'elles attendent des data scientists pour éliminer cette sensation de stress souvent liée à une méconnaissance de l'organisation et à des objectifs mal définis", avance Ariane Liger-Belair, directeur du programme académique de SAS France. "C'est de cette manière qu'elles pourront bâtir et développer des équipes multi-facettes, rassemblant les compétences complémentaires de différents collaborateurs. Au final le data scientist n'est souvent pas une personne mais plutôt une équipe. C'est en comprenant ceci que les entreprises pourront obtenir toute la valeur des Big Data".

Les 10 profils de data scientists identifiés :

- Geek (41%) : naturellement porté sur la technique, avec de grandes capacités logiques et analytiques, il représente le plus grand groupe au sein des data scientists. Porté sur les détails et les faits, il ne fonde pas ses décisions sur les émotions.

- Gourou (11%) : enthousiaste et pré-disposé aux thèmes scientifiques et techniques, il présente de solides compétences sociales et communicatives, fortement persuasives.

- Pilote (11%) : cet individu pragmatique, confiant et sûr de lui, se concentre sur les résultats. Il représente le chef de projet ou meneur d'équipe idéal.

- Statisticien (11%) : très doué pour la technique, il se fait peu entendre en interne, préférant se concentrer sur la préparation des données, l'analyse statistique et le suivi qualité.

- Fournisseur (7%) : comme le pilote, il est proactif et adapté au management d'équipes. Il est aussi bien concentré sur le succès du projet que sur la compréhension en profondeur des détails techniques.

- Évangéliste (6%) : c'est un communicant, avec en apparence moins de compétences techniques que le gourou par exemple. Il est très valorisé pour sa posture enthousiaste, qui peut l'amener à présenter les résultats des projets big data.

- Les autres personnalités (13%) :
o Explorateur : orienté vers de nouvelles approches ou méthodes, notamment par le développement d'algorithmes,
o Chercheur : de grandes connaissances techniques associées à la volonté de trouver des solutions,
o Professeur : la capacité à transmettre le savoir et inspirer les collaborateurs,
o Pilier : un important membre de l'équipe qui fournit le soutien et la coordination.

Vous souhaitez connaître votre profil ? SAS vous propose un test à cette page.

L’École polytechnique, Keyrus, Orange et Thales formeront des Data Scientists

Soumis par fredericmazue le

La Secrétaire d’État à l’Enseignement supérieur et à la Recherche, Mme Geneviève Fioraso, a parrainé ce matin la signature de la chaire « Data Scientist » créée par l’École polytechnique, Keyrus, Orange et Thales, et portée par la Fondation de l’X. L’objectif de cette chaire est de soutenir des formations en sciences des données appliquées au Big Data pour répondre aux besoins croissants des entreprises.

Avec l’explosion du volume des données, le Big Data est devenu un enjeu technologique, économique et organisationnel pour les entreprises. Selon le cabinet Transparency Market Research, le chiffre d'affaires du marché du Big Data devrait  connaître une croissance annuelle proche des 40% et passer de 8,9 milliards de dollars en 2014 à 24,6 milliards de dollars en 2016. En France, le marché du Big Data représentera près de 9 milliards d’euros en 2020 et plus de 130 000 emplois*. Alors que les entreprises sont confrontées à une pénurie de spécialistes en Big Data, la chaire Data Scientist soutiendra activement le développement de cette filière d’enseignement et de recherche au sein de l’École polytechnique.

Former la prochaine génération de « Data Scientists »

L’objectif de la chaire est de soutenir des formations en sciences des données appliquées au « Big Data » à travers une formation d’ingénieur, co-habilitée entre l’École polytechnique et Télécom ParisTech, afin de créer un nouveau vivier de recrutement pour les entreprises. La chaire soutiendra également des actions de formation continue, à destination de professionnels en activité. Le corps enseignant de cette chaire comprendra un professeur chercheur et un ingénieur système s'occupant de l'infrastructure informatique nécessaire à ce type de formation. Les partenaires mécènes Keyrus, Thales et Orange proposeront des stages et interviendront dans le cadre des formations, ils pourront également attribuer des bourses et participer aux remises de prix.

Une approche pluridisciplinaire

L‘objectif de la chaire est aussi d’encourager des recherches innovantes et originales en sciences des données appliquées au Big Data. Les travaux associés à la chaire bénéficieront d’une collaboration forte entre informaticiens, mathématiciens appliqués et acteurs du monde économique.

Les activités de recherche encouragées par la chaire porteront sur le développement d'algorithmes efficaces dans une approche pluridisciplinaire. Les travaux de la Chaire «Data Scientist» s’appuieront à l’École polytechnique sur le Centre de  Mathématiques Appliquées (CMAP) et le Laboratoire d’informatique de l’X (LIX).

Eric Cohen, Président-Directeur Général de Keyrus : « Nous sommes très fiers d’avoir porté et soutenu cette grande initiative qui a éclos au sein du groupe Keyrus. Notre expertise du traitement et de la valorisation de la donnée, associée à notre connaissance de l’écosystème des technologies Big Data, nous a permis de détecter très tôt la nécessité de recruter de nouveaux profils à la fois scientifiques et techniques capables de répondre au défi des « Mégadonnées ». Pour ce faire, nous allons désormais soutenir la formation d’excellence à l’X, de futurs « Data Scientists » pour notre compte et celui de nos clients dans 15 pays. »

Selon Marko Erman, Directeur technique de Thales : « Thales est un acteur majeur de l’informatique décisionnelle, de la protection des données et du traitement en toute sécurité des données massives (Big Data) pour ses clients défense, sécurité, aéronautique, espace et transport. Pour Thales, cet accord permet de créer une nouvelle filière d’ingénieurs spécialisés et capables de faire le lien entre cette technologie nouvelle et les besoins du marché. C’est un profil qui n’existe pas aujourd’hui et qui répond parfaitement à la demande des entreprises. Cette chaire est une belle illustration de collaboration entre le monde académique et celui de l’industrie, profitant à la recherche, à l’innovation et à l’emploi. »

Commentant la création de cette chaire, Bruno Mettling, Directeur Général Adjoint en charge des Ressources Humaines d’Orange, a déclaré : « Nous sommes fiers d’être partenaire de cette chaire et de participer ainsi à la formation de la future génération de data scientists qui permettra aux entreprises technologiques et innovantes comme Orange de répondre à l’enjeu fort de développement des réseaux de données, au cœur de la nouvelle économie numérique. »

* Point d’étape sur les 34 plans de la nouvelle France industrielle – juillet 2014