HPC

Advantech présente le premier module COM-HPC au monde équipé de processeurs de serveur ultra-puissants AMD EPYC Embedded 7003, avec jusqu'à 64 cœurs pour les conceptions de serveurs Edge durcis

Soumis par admin le

Advantech, fournisseur de solutions informatiques embarquées, a présenté au salon embedded world 2022 le premier Server-On-Module (serveur-sur-module) COM-HPC au monde équipé de processeurs AMD EPYC 7003 Embedded. Avec 64 cœurs, ce nouveau Server-On-Module COM-HPC au format E (200 x 160 mm) offre plus de 3 fois plus de cœurs de serveur Edge (périphérie de réseau) que tout autre module serveur COM-HPC du marché, et propose aux concepteurs de serveurs Edge un immense bond en avant en termes de performances. Les applications typiques de ce nouveau module COM-HPC de référence, sont notamment dans les technologies réseau de niveau industriel, comme les passerelles VPN et les pare-feu avec des exigences élevées en matière de débit de données (jusqu'à 100 GbE) et de stockage tampon rapide, les télécommunications et les infrastructures Edge critiques telles que les stations de base 5G, les serveurs Edge complexes à criticité mixte, destinés à l'Industrie 4.0, ou encore les applications radar et sonar déployées dans le secteur de la sécurité et de la défense. L'avantage de l'approche "Server-On-Module" pour ces applications tient au fait qu'elle est plus rapide et plus rentable, que de développer un serveur dédié. Ainsi, les fournisseurs de serveurs de classe industrielle peuvent concevoir des plateformes de solution entièrement personnalisées, même pour des projets de faible volume, comme c'est souvent le cas avec les applications industrielles.

« Le lancement du nouveau Server-On-Module COM-HPC au format E, équipé de la puissante série de processeurs AMD EPYC 7003 Embedded, nous permet d’entrer rapidement sur le marché émergent des serveurs Edge modulaires, ce qui est très important. N'oubliez pas que les conceptions de serveurs standards sont conçues pour les ventes en gros volumes, et proposées avec des ensembles de fonctionnalités relativement uniformes. Apporter des performances de traitement de classe serveur dans le secteur de l’embarqué et des serveurs Edge engendre des besoins de personnalisation, et les Servers-On-Modules répondent à ces besoins grâce au principe de conception de modules processeurs et de cartes porteuses, qui a fait ses preuves et qui est largement déployé depuis plusieurs décennies, » explique Dirk Finstel, Vice-Président Associé pour l’IoT embarqué, et Directeur Technique Europe, chez Advantech.

« Depuis plusieurs années, nous constatons un besoin de personnalisation dans le domaine de l'informatique embarquée. La productivité de la combinaison de modules et de cartes porteuses personnalisées est la raison principale du succès des Computer-On-Module (ordinateur-sur-module ou COM). Les COM sont les produits de niveau carte les plus utilisés dans le domaine de l'informatique embarquée. Avec la spécification Server-On-Module COM-HPC, ce principe de conception est désormais également disponible pour une large gamme de processeurs serveurs d'entrée de gamme, jusqu'aux récents processeurs AMD EPYC Embedded 7003, » déclare Jess Isquith, Président de PICMG, pour souligner l'importance de la nouvelle spécification Server-on-Module qu'Advantech, en tant que membre du sous-comité COM-HPC du PICMG, a contribué à définir.

« Il est impressionnant de voir à quelle vitesse Advantech s’est mis à fournir nos processeurs serveur sur des Server-on-Modules conformes à la nouvelle norme de serveur COM-HPC. Cela nous montre que le marché des serveurs Edge et des serveurs réseau embarqués prend de l'ampleur, et que la numérisation des usines Industrie 4.0 et des infrastructures critiques crée un besoin énorme de conception de systèmes personnalisés. Grâce à leurs voies PCIe Gen 4 génériques, nos processeurs EPYC 7003 sont idéalement conçus pour adapter les serveurs à des tâches spécifiques, » déclare Amey Deosthali, Directeur de la Gestion Produits, Groupe Informatique adaptative et embarquée, chez AMD.

Outre la puissance de calcul embarquée jusqu'à 64 cœurs et les multiples voies génériques PCIe Gen 4, le nouveau Server-on-Module SOM-E780 d'Advantech présente aussi la haute efficacité énergétique typique des serveurs x86, offrant des performances exceptionnelles, réduisant les coûts énergétiques, et permettant même de mettre en œuvre des solutions à refroidissement passif. Un autre avantage est l'approche à socket unique, qui permet de minimiser les coûts de licence par rapport à une conception de serveur à double socket. Basés sur la microarchitecture Zen 3 d'AMD et l'architecture Infinity d'AMD, les processeurs série 7003 EPYC d'AMD offrent un ensemble de fonctionnalités complet, avec un nombre de voies E/S inégalé, une technologie de CPU x86 en 7 nm, et un processeur de sécurité intégré. Ils offrent également jusqu'à 32 Mo de cache L3, l'entrelacement 4-6-8 des canaux mémoire pour optimiser les performances de configurations DIMM multiples, et des horloges synchronisées entre le tissu et la mémoire, des technologies qui associées offrent des performances de premier plan.

Les processeurs EPYC sont dotés d'AMD Infinity Guard, une suite de fonctions de sécurité de pointe, intégrée au silicium et conçue pour protéger des menaces internes et externes. AMD Infinity Guard comprend Secure Encrypted Virtualization (SEV) pour aider à sauvegarder la confidentialité et l'intégrité des VM (machine virtuelle), Secure Nested Paging (SEV-SNP) qui assure la protection de l'intégrité de la mémoire, Secure Memory Encryption (SME) qui aide à se prémunir des attaques sur la mémoire principale, et AMD Shadow Stack pour une protection de la pile contre les attaques de malware, renforcée par matériel.

Ensemble des fonctionnalités en détails

Les nouveaux modules COM-HPC Server format E, SOM-E780 d'Advantech, intègrent les derniers processeurs de classe serveur AMD EPYC 7003 Embedded, et profitent d’une disponibilité à long terme prévue pour au moins 5 ans. Disponibles en 5 variantes différentes, les nouveaux modules offrent aux applications nécessitant des performances de calcul parallèle massives, jusqu'à 64 puissants cœurs AMD Zen 3 pour traiter un maximum de 128 threads. Avec 4 sockets DIMM, ils prennent en charge jusqu'à 512 Go de RAM DDR4 avec 3 200 MT/s, pour accélérer les conceptions de serveurs avec des besoins de bande passante mémoire élevés, des charges de travail intensives au niveau accès mémoire, et des installations de machines virtuelles. De plus, le nombre impressionnant de jusqu’à 79 voies PCIe Gen 4 permet une nouvelle classe de conceptions modulaires de serveurs Edge hautes performances, qui intègrent une large gamme de contrôleurs dédiés, de cartes accélératrices de calcul, et de supports de stockage NVMe, et prennent en charge la communication E/S à très haut débit, et le réseau jusqu'à l’Ethernet 100 Gbits.

Pour la mise en réseau en temps réel, les modules offrent en plus l’Ethernet 1 x 2,5 Gbits. Les autres interfaces sont notamment 4x USB 3.2 Gen 1, 4x USB 2.0, ainsi qu'un bus SPI, un GPIO 12 bits, et 2 ports COM. Des disques durs conventionnels et des SSD peuvent être connectés via 2 interfaces SATA 3.0. Un support logiciel est fourni pour Windows 10 et Ubuntu Linux. Pour plus de fiabilité, d'accessibilité et de facilité d'entretien, les nouveaux Servers-On-Module COM-HPC prennent en charge TPM (gestion de plateforme de confiance) ainsi que la solution éprouvée de gestion et de surveillance à distance d'Advantech, qui comprend iManager, y compris IPMI, des API de logiciels embarqués, et WISE-DeviceOn. Afin d'optimiser les délais de lancement et la sécurité de conception, Advantech propose des solutions de refroidissement adaptées, ainsi que des services de conception logicielle étendus pour les nouvelles applications d'IA et d'Edge computing.

Atos lance le premier supercalculateur équipé de GPU NVIDIA A100

Soumis par admin le

Atos a dévoilé BullSequana X2415, le premier supercalculateur en Europe à intégrer les unités de traitement graphique (Graphics Processing Unit – GPU) NVIDIA A100 Tensor Core du projet Ampère, l’architecture GPU de nouvelle génération de NVIDIA.  Cette nouvelle lame fournira une puissance de calcul jamais atteinte jusqu’à présent et accélérera les performances des applications de HPC et d’IA. La lame BullSequana X2415 multipliera par plus de 2 la puissance de calcul et optimisera la consommation d’énergie, grâce à la solution brevetée DLC (Direct Liquid Cooling) d’Atos qui refroidit totalement le système en utilisant de l'eau chaude.

Premier à intégrer cette nouvelle technologie dans son architecture, le Centre de recherche de Jülich accroit ainsi les capacités de son supercalculateur. Grâce au supercalculateur JUWELS, les chercheurs partout en Europe profiteront de capacités informatiques largement supérieures à l’existant. Destiné à soutenir de nombreuses initiatives, il contribuera notamment aux projets « Humain Brain » de la Commission Européenne, ainsi qu’à « Science du Climat » et « Systèmes Moléculaires » des Laboratoires Jülich. Ce système sera entièrement déployé cet été. Administré par le logiciel ParaStation Modulo de ParTec, il devrait atteindre un pic de performance de plus de 70 pétaflops, devenant ainsi le supercalculateur le plus puissant d’Europe et un modèle d’architecture européenne exascale.

« Nous sommes fiers d’être l’un des premiers constructeurs de supercalculateurs au monde à intégrer les GPU A100 de NVIDIA. C’est un atout considérable pour les chercheurs, qui bénéficient des meilleures performances applicatives pour leurs charges de travail HPC et IA », ajoute Agnès Boudot, Senior Vice-Président, Responsable des activités HPC & Quantum chez Atos. « Nous sommes totalement focalisés à aider Jülich à accroitre sa puissance de calcul et faire du supercalculateur JUWELS le plus puissant d’Europe ».

El Capitan : un supercalculateur HPE d'une puissance de 2 exaflops

Soumis par fredericmazue le

HPE présente le supercalculateur Exascale le plus rapide au monde avec une puissance de 2 exaflops (soit 2 000 pétaflops), ce qui le rend environ deux millions de fois plus puissants que les ordinateurs portables d'aujourd'hui et surtout 10 fois plus rapide que supercalculateur actuellement considéré comme le plus puissant, selon HPE. Baptisé El Capitan, ce supercalculateur devrait être livré fin 2022 au Ministère américain de l’énergie (DOE, pour Département of Energy).

Ce nouveau système initialement annoncé en août 2019, utilisera les processeurs AMD EPYC de nouvelle génération et la mémoire à haut débit AMD Radeon Instinct GPU pour optimiser les performances globales afin de cibler les charges de travail critiques de calcul haute performance (HPC) et d'intelligence artificielle (IA). La performance de 2 exaflops représente une augmentation de plus de 30 % par rapport aux estimations initiales présentées il y a sept mois.  Le El Capitan du DOE utilisera l'architecture Shasta de Cray, conçue pour prendre en charge un ensemble de technologies de processeurs et d'accélérateurs nécessaires pour alimenter les performances et l'évolutivité des nouvelles charges de travail à forte intensité de données, telles que la modélisation, la simulation, l'analyse et l'IA. 

Conférences & Ateliers Développeurs HPC & IA

Soumis par fredericmazue le

CPU, GPU, Accelérateurs, FPGA, ASICS, OneAPI, quelle est la stratégie d’Intel ?  Et si l’essentiel était dans votre code ?

2 jours de conférences et d’atelier pratique pour prendre la bonne direction et optimiser les performances de vos applications avec les technologies Intel actuelles et vous préparer aux nouvelles évolutions des compilateurs, bibliothèques et outils Intel Parallel Studio XE 2020.

Ces conférences sont destinées aux développeurs C++, Fortran, Python, Scientifiques ou Experts des données. Y seront exposés des cas réels pour illustrer comment les compilateurs, les bibliothèques et les outils d’Intel facilitent l’intégration  multi–plateforme et les performances CPU, GPU, TPU « on prem » ou dans le Cloud.

Les 15 & 16 Octobre 2019 à l'Espace La Rochefoucauld - 11 Rue de la Rochefoucauld, 75009 Paris.

Le nombre des places étant limité, ne tardez pas à vous inscrire.

Inauguration du supercalcultateur Joliot-Curie - jusqu'à 22 pétaflops en 2020

Soumis par fredericmazue le

Un an après sa mise en service en juin 2018, GENCI et le CEA inaugurent ce jour, avec l’industriel Atos, le supercalculateur Joliot-Curie. Les partenaires annoncent aux chercheurs non seulement le doublement de sa puissance de calcul à 22 pétaflops en 2020 mais également des services complémentaires grâce à l’intégration de technologies d’analyse et de visualisation des données. L’accès à ces nouveaux outils dont certains issus de l’intelligence artificielle pour la mise en oeuvre de réseaux de neurones profonds, ou à des ressources virtualisées a déjà commencé à être mis en oeuvre et va s’amplifier. Joliot-Curie représente ainsi un investissement stratégique global de plus de 100 millions d’euros. Conçu par Atos à Angers cette machine permet en outre à la France et plus largement à l’Europe de renforcer sa position de leader dans la course mondiale au supercalcul.

Le supercalculateur Joliot-Curie, basé sur l’architecture BullSequana d’Atos, a une puissance crête de 9,4 pétaflops, soit une capacité de calcul multipliée par 4,5 par rapport à son prédécesseur, Curie, avec une réduction de la consommation électrique proche d’un facteur deux.

Joliot-Curie est le troisième supercalculateur français dans le Top500 en terme de puissance, derrière Tera 1000-2 et Pangea. Équivalent à plus de 75 000 ordinateurs de bureau, sa puissance permettra aux chercheurs un accompagnement dans tous les usages nécessitant d’importants volumes de calcul et de traitement de données. La capacité de mémoire vive de ce superordinateur est tout aussi exceptionnelle avec 400 téraoctets. Un système de stockage de données de 5 pétaoctets disposant d’une bande passante de 300 Go/s, des services de visualisation distante des données, de virtualisation viennent compléter le supercalculateur.

La puissance de calcul de Joliot-Curie sera plus que doublée en 2020. En effet, elle atteindra 22 pétaflops, soit 22 millions de milliards d'opérations par seconde, devenant ainsi le troisième calculateur le plus puissant d’Europe dédié à la recherche et le premier en France. Cette montée en puissance du supercalculateur Joliot-Curie s’inscrit dans la compétition internationale vers l’exascale, à savoir une puissance de calcul d’un milliard de milliards d’opérations par seconde, qui représente un enjeu stratégique pour la compétitivité des acteurs de l’économie numérique.

Avec l’investissement réalisé par GENCI, société civile dont les parts sont détenues par l’État, via le Ministère de l’Enseignement supérieur, de la Recherche et de l’Innovation, le CEA, le CNRS, les universités et Inria, Joliot-Curie permet également à la France de répondre à ses engagements en matière de puissance de calcul mise à disposition des chercheurs Européens dans le cadre de l’infrastructure européenne de calcul PRACE.

HPE s'apprête à acquérir Cray

Soumis par fredericmazue le

Hewlett Packard Enterprise annonce l’acquisition prochaine de Cray, fournisseur de solutions de supercalculateurs haut de gamme. La transaction est évaluée à environ 1,3 milliards de dollars.

« Les réponses à certains des défis les plus urgents de la société sont ensevelies sous des quantités massives de données », a déclaré Antonio Neri, Président et CEO de HPE. « Ce n'est qu'en traitant et en analysant ces données que nous serons en mesure d'apporter des réponses aux défis cruciaux dans les domaines de la médecine, du changement climatique, de l'espace et plus encore. Cray est un leader mondial de la technologie des supercalculateurs et partage notre engagement profond envers l'innovation. En combinant nos savoir-faire et notre technologie, nous aurons l'opportunité de jouer un rôle dans l'amélioration de la façon dont les gens vivent et travaillent ».

AMD participe au futur supercalculateur exascale le plus rapide du monde

Soumis par fredericmazue le

AMD s'est joint au département américain de l'Énergie (DOE), au laboratoire national d'Oak Ridge (ORNL) et à l’entreprise Cray pour annoncer ce qui devrait être le supercalculateur exascale le plus rapide du monde. Ce dernier sera livré en 2021 au laboratoire national d'Oak Ridge. Avec des performances attendues à plus de 1,5 exaflops, le système Frontier est propulsé par la prochaine génération de processeurs AMD EPYC et de processeurs graphiques AMD Radeon Instinct dans des versions spécifiques optimisées pour les exigences du calcul intensif (HPC) et de l'intelligence artificielle (AI). Les chercheurs du Laboratoire national d'Oak Ridge utilisera ce supercalculateur pour faire progresser la compréhension des interactions sous-jacentes à la science météorologique, aux structures subatomiques, à la génomique, à la physique et aux autres domaines scientifiques importants.

« AMD est fier de s'associer à Cray et ORNL pour bâtir ce qui devrait être le supercalculateur le plus puissant du monde », indique Forrest Norrod, senior vice president et general manager, AMD Datacenter et Embedded Systems Group. « Frontier sera propulsé par des versions custom des technologies CPU et GPU d'AMD. Grâce à cette dernière réalisation, qui s’ajoute à une longue liste d'innovations technologiques, AMD poursuit sa contribution aux programmes exascale du département de l'énergie. »

Conférence Développeurs Intel Embarqué, IOT, HPC et IA - Toulouse 2019

Soumis par fredericmazue le

2 jours de conférences et d'ateliers pratiques de codage avec les outils Intel pour le Calcul HPC, l'embarqué, l'IOT, l'optimisation des performances, l'intelligence artificielle, l'apprentissage automatique, la reconnaissance d'image et la vision par ordinateur.

Ces 2 journées s'adressent aux développeurs, Ingénieurs HPC, Scientifiques et Experts en science des données.

  • 1er jour - 20 Mars : Embarqué, IOT, et Calcul HPC , Programmation Parallèle, vectorisation, debug et optimisation des performances avec Intel Sytem Studio et C++
  • 2ème jour - 21 Mars : Intelligence Artificielle / Deep learning / Computer Vision, implémentation framework IA Intel avecTensor Flow, DAAL et OpenVino

Vous pouvez participer aux deux jours, ou choisir de n'assister qu'à un seul jour. Dans ce dernier cas, vous devez le spécifier lors de votre l'inscription. La participation est libre sans frais mais l'enregistrement obligatoire.

S'inscrire

Dates: mercredi 20 & jeudi 21 Mars 2019 
Horaires des sessions:   de 9h00 à 18h 
Accueil - Petit-déjeuner à partir de 8h30
 
Pauses café et repas offerts sur place.
 
Cocktail / Echanges Networking  de 17h à 18h30 le mercredi 20.

Hôtel Pullman Toulouse Centre
84, allées Jean Jaurès
31000 Toulouse

AIRI : une monstrueuse baie pour l’IA

Soumis par francoistonic le
Image

Vous connaissez sans doute PNY pour les cartes SD, la mémoire et les cartes graphiques. Mais aujourd’hui, l’activité va bien au-delà. La société a été créé en 1985 et adresse le marché grand public et le marché pro et d’entreprise. Le siège européen se situe près de Bordeaux. Programmez ! s’y est rendu pour découvrir l’AIRI, une machine hors norme dédiée aux calculs intensifs et à l’IA.

Aujourd’hui, PNY a une grosse activité sur le graphisme et les solutions GPU dédiées, grâce à son partenariat très actif avec NVIDIA. Un gros investissement est fait sur l’Intelligence Artificielle pour mêler le matériel et le logiciel. Cela répond aux axes stratégiques définies par PNY : HPC, Deep Learning, IA et les technologies de visualisations (3D, VA – VR, etc.). Le marché pro des GPU hauts de gamme est très dynamique. Par exemple, plus de 10 000 cartes Quadro se vendent chaque mois. La gamme de cette GPU est large : allant de 150 à + 5 000 € avec 32 Go de mémoire… La virtualisation GPU est un axe majeur pour le constructeur qui proposent des solutions matérielles complètes pour pouvoir virtualiser les cartes et donner accès à leurs puissances dans le cloud ou via des solutions de virtualisation classique. Pour ce faire, PNY repose sur Grid de NVIDIA qui fonctionne avec Citrix et VMWare, et d’autres.

Le HPC est bien entendu un marché majeur pour PNY qui proposent depuis 10 ans des solutions clés en mains ou des GPU dédiés aux calculs : serveurs complets, architecture TESLA. 

AIRI : une infrastructure matérielle et logicielle

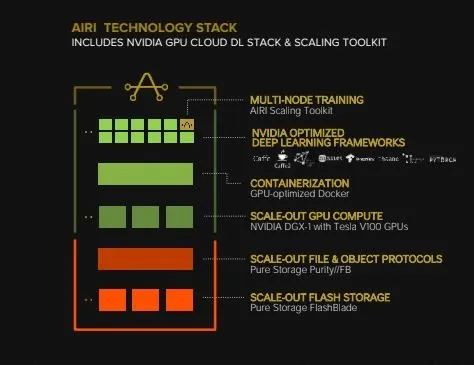
Le monde des serveurs et des stations de travail n’est pas inconnu pour NVIDIA. Il proposait déjà l’excellente station DGX-1, déclinée aussi en serveur. Cette gamme est maintenant complétée par l’AIRI, un cluster complet intégrant les switchs réseaux, le stockage, les serveurs GPU et les piles logicielles. 

Le constat est simple : pour faire de l’IA, du Deep Learning, de la Machine Learning ou même de l’HPC, le CPU n’est pas la puce la plus adaptée. La GPU offre une puissance de calcul souvent ignorée ou mal utilisée. Et avec les évolutions moins flagrantes sur les CPU, les GPU offrent encore une marge d’évolution très importante en parallélisant les calculs. Par exemple, une GGX-1 reçoit jusqu’à 4 cartes TESLA totalisant 256 Go de mémoire, 20 480 cœurs CUDA et 2 560 cœurs Tensor. En puissance brute, difficile de trouver mieux sur le marché. L’alimentation de la machine est à la hauteur de l’architecture : 1500 W… Cette machine cible l’IA, les data scientists, les modèles complexes, le Deep Learning. Pour assurer le bon fonctionnement du water cooling, la station est montée et configurée en usine… 

La couche logicielle qui vient avec la station est là pour proposer une optimisation différents composants ; Nous retrouvons bien entendu le système, puis les pilotes NVIDIA (adaptés aux contraintes de la DGX), la disponibilité des outils nécessaires aux usages intensifs (via des conteneurs Docker pour faciliter le provisionning). L’ensemble des frameworks sont optimisés pour la machine : Caffe, TensorFlow, etc. L’objectif est d’éviter de recoder vos applications et modèles. Par contre, à vous d’optimiser les codes CUDA pour tirer parti des cartes. 

Ainsi un code CUDA pour les 1070 ou 1080 TI tournera sur les TESLA et donc dans la DGX-1 mais attention, il faudrait tout de même tuner le code et l’optimiser avec les SDK dédiés. 

L’idée de l’AIRI est de proposer une infrastructure capable d’une montée en charge la plus linéaire possible pour les calculs intensifs, l’IA. Le constructeur parle de cluster, il s’agit d’une baie classique contenant tous les éléments nécessaires :

  • chassis : full size ou format mini
  • compute et GPU avec les serveurs NVIDIA DGX-1 (jusqu’à 4 unités)
  • stockage haute performance avec Pure Storage (jusqu’à 15x 17 To en stockage Flash !) 
  • réseau avec des switchs ARISTA 100 Gb/s en Ethernet et utilisant la technologie RDMA

Le but est d’intégrer dans une armoire unique tous les éléments nécessaires. Mais AIRI n’est pas vendue sur étagère. Il s’agit d’une infrastructure modulaire : chaque client va choisir sa configuration et elle est ensuite montée dans les ateliers PNY. 

Tous les éléments logiciels sont disponibles pour assurer une mise en route la plus rapide possible : AIRI Scaling Toolkit assure la montée en charge dans l’exploitation des ressources matérielles et pour optimiser au mieux les modèles, NIVIDIA GPU CLOUD Deep Leanings Stack inclut les principaux frameworks du marché. Ces derniers sont optimisés par les développeurs NVIDIA. Mais attention, comme pour la station ou les cartes NVIDIA, vous devez optimiser les codes CUDA. Les codes CPU fonctionneront mais n’utiliseront pas les cœurs CUDA du cluster. Ce travail est essentiel pour exploiter les ressources. 

Le constructeur ne promet pas une montée en charge linéaire mais nous n’en sommes pas très loin. Si vous rajoutez un DGX-1 à votre cluster qui en possède un, vous pouvez espérer un gain de 70 à 80 %. Dans la réalité, ce chiffre sera moindre mais vous gagnerez une importante marge. 

Pour assurer une bonne performance, il faut que les différents éléments du cluster s’interconnectent à haute performance. Le choix de l’ethernet 100 Gb/s n’est pas donc anodin. NVIDIA a aussi opté pour NVLink qui s’occupe de l’interconnexion entre les CPU et les GPU. En débit théorique, NVIDIA annonce, avec la TESLA V100, des débits multidirectionnels de 20 à 25 Gb/s. 

La redondance et la tolérance de panne est bien entendu un élément clé. Si le cluster perd jusqu’à 2 serveurs ou des unités de stockage et des swichts, AIRI est toujours capable de fonctionner et de répartir la charge à la volée (mais pas en temps réel). Les performances seront dégradées mais l’environnement continuera à fonctionner. 

La bête pèse une demie tonne à pleine capacité et la configuration complète dépasse les 17 – 18 000 watts. Un PNY Lab a été ouvert à Bordeaux que pour les partenaires, clients et futurs clients puissent toucher et éprouver leurs solutions sur du matériel réel. PNY annonce un retour sur investissement en 18 mois en moyenne. Bien entendu, vu le prix du AIRI, on dépasse largement les 100 000 € (selon la configuration), le marché est limité et il faut en avoir un usage réel. A noter que la souscription support et logicielle est obligatoire pour pouvoir disposer de toutes les mises à jour. Pour le moment, AIRI utilise les DGX-1 et non les DGX-2 annoncés il y a quelques semaines. 

François Tonic

Supercalculateurs : IBM prend la première place du TOP500, détenue par les chinois depuis 5 ans

Soumis par fredericmazue le

Le TOP500 est une classification des 500 superordinateurs, ou supercalculateurs, les plus puissants du monde. Depuis 5 ans, ce sont les chinois qui occupent la tête de ce classement. Toutefois IBM vient de leur ravir la première place avec son superordinateur Summit.

Le superordinateur Summit a été conçu par IBM pour l’ONRL (Oak Ridge National Laboratory) du Département américain de l’énergie (DOE). On peut dire que cette machine en a sous le capot.

La fiche technique de la bête nous apprend que celle-ci compte plus de deux millions de coeurs, 2 282 544 exactement. Pour s'épanouir, ces coeurs disposent d'un total de 2,801,664 Go de mémoire, soit 2,8 pétaoctets. La puissance de calculs est d'un peu plus de 122 Petaflops, soit 122 * 10 puissance 15 opérations en virgule flottante par seconde.

Pour mémoire, le FLOPS est une unité de mesure de la vitesse d'un système informatique dont le nom signifie  floating-point operation per second.

Le tout pour une consommation de 8 805 kW.

Toutefois si cette mise à jour du TOP500 place IBM à sa tête, la Chine reste le pays avec le plus grand nombre de supercalculateurs en service : 206, contre 202 dans le classement précédent. Les Etats-Unis ont reculé dans ce domaine, passant de 143 à 124 supercalculateurs en service.


Photographie des noeuds du Summit.