Hadoop

Une nouvelle Big Data Sandbox de Talend pour Mapr Converged Data Platform

Soumis par fredericmazue le

Talend lance une nouvelle version de sa Big Data Sandbox, qui prend désormais en charge MapR Converged Data Platform. L’environnement virtuel préconfiguré permet aux développeurs de découvrir et d’expérimenter des cas d’usages prêts à l’emploi, et d’exécuter une distribution Hadoop avec un nœud unique. La Sandbox est proposée avec une évaluation de 30 jours de la version Winter’17 de la plateforme d’intégration Big Data de Talend.

« Notre nouvelle Big Data Sandbox est une solution idéale pour permettre aux développeurs de se faire la main sur les toutes dernières technologies de management des données. Aucun codage manuel n’étant nécessaire, ils peuvent ainsi mieux comprendre le cycle de vie d’un projet big data dans son intégralité », déclare Ashley Stirrup, directeur marketing de Talend. « En fin de compte, il s’agit d’acquérir l’expérience nécessaire afin de réduire les risques, gérer la planification des ressources, et raccourcir les délais de mise en production des déploiements big data. »

Talend Big Data Sandbox est une solution gratuite permettant aux clients d’expérimenter des technologies de pointe telles qu’Apache Spark, le machine learning ou différents composants de la plateforme MapR Converged Data Platform, avant de les intégrer en production. Dans cet environnement, même des utilisateurs disposant de connaissances techniques limitées peuvent créer des workflows d’intégration de big data.

La nouvelle Big Data Sandbox inclut également un guide d’utilisation contenant plusieurs scénarios réels prêts à l’emploi, détaillés étape par étape :

  • L’analyse en temps réel de données issues de sources multiples
  • La génération de recommandations marketing, en temps réel et personnalisées, basées sur les comportements des clients
  • L’analyse des données issues de l’internet des objets (IoT) 
Hortonworks Data Platform 2.6, une plateforme Hadoop 100% open source

Soumis par fredericmazue le

Hortonworks annonce la disponibilité d’Hortonworks Data Platform (HDP) version 2.6, une version dont les fonctionnalités tirent profit de la capacité d’innovation inhérente au modèle open source. HDP est une distribution open source Apache Hadoop à la fois sécurisée et conçue pour une utilisation qui soit en mesure de répondre aux besoins relatifs aux données statiques, d’alimenter en données les applications métier, et de fournir des informations analytiques susceptibles d’accélérer la prise de décision et l’innovation. 

“HDP 2.6 démontre bien les avantages qu’offre la communauté open source. Cette innovation majeure provient directement de la communauté Apache. C’est grâce à notre engagement à fournir une plateforme open source que nous sommes capables d’apporter à nos clients ce savoir-faire source de valeur ajoutée,” explique Scott Gnau, Directeur des Opérations chez Hortonworks. “HDP 2.6 introduit de nouvelles fonctionnalités clés et des améliorations de performance qui seront immédiatement accessibles à nos clients - sans qu’ils aient  besoin de réécrire leurs applications.”

Hortonworks est le premier fournisseur Hadoop à supporter Apache Hive 2.0 avec la fonctionnalité LLAP pour la mise en cache intelligente.

Par ailleurs, HDP 2.6 intègre de nouvelles fonctionnalités :

  • Data Science adaptative : une expérience utilisateur améliorée à destination des data scientists avec Spark 2.1 et la dernière version de Zeppelin.
  • Sécurité centralisée : parmi les améliorations de Ranger et Atlas, un temps de synchronisation réduit pour les entreprises devant gérer des bases utilisateurs importantes et un ajout simplifié et généralisé de politiques de sécurité d’un environnement sur un autre par le biais d’un support des politiques de sécurité reposant sur des tags pour les environnements Spark, Zeppelin, HDFS, Kafka et Hbase.
  • Opérations proactives et optimisées : configuration simplifiée de services et de composants quand un noeud au sein d’un cluster redémarre avec la dernière version d’Ambari. Prise en compte immédiate des opérations le plus fréquemment effectuées. Par ailleurs, SmartSense a été amélioré pour automatiser la mise en application des configurations recommandées en vue d’améliorer le cluster.

Hortonworks a rendu HDP 2.6 disponible sur Microsoft Azure HDInsight et Hortonworks Data Cloud for AWS. HDP 2.6 est également disponible sur IBM Power Systems.

Talend : une solution de préparation de données pour le Big Data sur Apache Beam

Soumis par fredericmazue le

Talend présente une solution de préparation de données pour le big data en libre-service, sur Apache Beam. Devenu un projet de premier plan de la fondation Apache, Apache Beam est un modèle de programmation unifié qui permet d’exécuter des pipelines de flux de données par lots (batch) ou en flux continu (streaming), avec la possibilité de les exécuter sur une variété de plateformes. Talend Data Preparation est une solution en libre-service permettant à davantage d’employés d’accéder, de nettoyer et d’analyser d’important jeux de données. La combinaison Apache Beam et Talend Data Preparation est conçue pour aider les entreprises à accélérer la prise de décision, en permettant à un plus grand nombre d’utilisateurs de créer des projets de données qui peuvent être exécutés sur l’ensemble des dernières innovations technologiques liées au traitement de données.

« Aujourd’hui, les entreprises doivent pouvoir accéder plus facilement à des données propres et utilisables, afin de générer des informations qualifiées en temps réel au sein de leur organisation », déclare Laurent Bride, directeur technique de Talend. « Cependant, l’innovation technologique étant de plus en plus soutenue, les responsables informatiques doivent souvent faire face au risque que leurs investissements deviennent rapidement obsolètes, voire même qu’ils fassent obstacle à la croissance future de leur entreprise. Nous sommes convaincus qu’Apache Beam représente l’avenir : ce modèle évite d’avoir à réécrire des applications au gré des innovations, de migration de systèmes vers le cloud ou en cas d’alternance de styles d’intégration. L'utilisation de Beam pour Data Preparation permettra à nos clients de créer une seule fois leurs modèles de préparation de données et de les exécuter n’importe où, bénéficiant ainsi d’une agilité sans précédent. »

Les capacités de préparation des données de Talend permettent de :

  • Accéder à n'importe quelle source de données, qu'elle soit hébergée dans Hadoop, sur le cloud ou dans des bases de données traditionnelles, puis de les partager entre utilisateurs et groupes de travail pour encourager la collaboration.
  • Utiliser un dictionnaire de données préconfiguré pour reconnaitre automatiquement la signification de données brutes d’un data lake, ainsi que d’enrichir ce dictionnaire avec son propre vocabulaire, tel que les codes ou noms de produits de l’entreprise.
  • Décrire de nouvelles données de manière participative depuis des données ouvertes (open data) et/ou la communauté Talend.

Plus d'informations : www.talend.com/blog

Windev 21 est sorti !

Soumis par fredericmazue le
IDE
Image
Image

Windev 21, l'outil de développement intégré multi plates-formes de l'éditeur PC Soft est arrivé. Avec Windev, un même code peut être ciblé sur de nombreuses plates-formes : Windows, .Net, Linux, Mac, iOS, Android. L'outil s'appuie sur un langage maison, le WLangage. Le code source WLangage est compilé en bytecode pour être exécuté par une machine virtuelle ou converti en code natif lors de l'exécution par un compilateur JIT.

La mouture Windev 21 intègre 921 nouveautés, pour répondre au mieux au besoin du marché, souligne l'éditeur qui précise en outre qu'aucune phase de migration n'est nécessaire depuis Windev 7.5. Il suffit simplement de recompiler le code d'une application sous l'environnement 21 qui sait ouvrir tout ancien projet depuis Windev 7.5.

Responsive Web Design et Dynamic Serving

Un des besoins majeurs du marché en ce moment est la création de sites qui se comportent correctement, avec une bonne expérience utilisateur, quel que soit le terminal du visiteur : PC, tablette, smartphone. Windev 21 introduit le Responsive Web Design. Son éditeur WYSIWYG permet de créer des pages automatiquement dotées de grilles de positionnement fluide, avec adaptation automatique de la taille des polices.

Par ailleurs Windev 21 vient avec le Dynamique Serving, grâce auquel une même URL peut mener à deux pages différentes selon la résolution de terminal du visiteur. Ce qui offre la possibilité de garder des pages de structure classique pour les PC et de présenter du Responsive pour les autres terminaux.

Windows 10

Un autre besoin dans l'air du temps est la possibilité de créer des applications universelles Windows 10. (Les applications classiques Windev fonctionnent sous Windows 10) Windev 21 décharge le programmeur de la gestion des API asynchrones introduite par Windows 10 au niveau des applications universelles. L'éditeur transforme les définitions des interfaces utilisateurs existantes en XAML, format requis par ces applications universelles. Lors de l'édition d'une interface, des agencements définissent plusieurs dispositions pour les champs d'une fenêtre. Les agencements sont créés en fonction des résolutions attendues, à partir d'un même code source. A l'exécution, le runtime utilise automatiquement l'agencement correspondant aux caractéristiques physiques du terminal.

La télémétrie

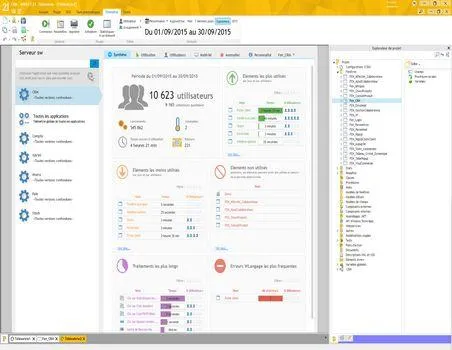
A remarquer encore parmi ces 921 nouveautés, la télémétrie qui consiste en un tableau de bord d'exploitation des applications (choix les plus utilisés, performance, temps passé sur des champs et fenêtres, métrique de survenance d'erreurs, OS utilisés...).

Le Big Data

Windev 21 permet d'intégrer le Big Data à vos applications avec les technologies Hadoop. Il offre des connecteurs HBase pour l'accès aux données en colonnes, Hive pour l'accès aux données par requêtes, et HDFS pour l'accès aux données en fichiers ou blocs de fichiers.

Windev 21 c'est encore de nombreuses améliorations sur les mobiles, parmi lesquelles nous citerons l'arrivée du multi fenêtrage sur iOS 9.

MapR présente la première base de données documentaire basée sur Hadoop

Soumis par fredericmazue le

A l’occasion de Strata + Hadoop World MapR Technologies a annoncé l’ajout du support natif de JSON à la base de données NoSQL MapR-DB. La première base de données documentaire basée sur Hadoop va permettre aux développeurs de fournir rapidement des applications à haute élasticité qui tirent elles aussi profit de l’analytique en continu sur des données temps réel.

Avec ces améliorations majeures, les développeurs bénéficient des avantages d’une base de données documentaire combinée avec l’échelle, la fiabilité et les capacités analytiques intégrées d’offres professionnelles Hadoop et Spark. Ces caractéristiques vont renforcer la capacité des entreprises à améliorer tout un éventail de cas d’usage – qu’il s’agisse de personnaliser et de fournir la meilleure expérience du shopping en ligne, comme de réduire le risque et prévenir la fraude en temps réel, ou encore d’améliorer l’efficacité de ses processus manufacturiers pour réduire ses coûts. Afin d’aider les développeurs à expérimenter et pratiquer MapR-DB, une préversion leur étant destinée et accompagnée de code d’illustration est disponible au téléchargement.

La distribution MapR intégrant Hadoop dispose d’une architecture conçue pour offrir une plateforme permettant d’exécuter des applications analytiques et opérationnelles. MapR-DB permet d’analyser en continu des données temps réel, tout en réduisant l’expansion des clusters, en éliminant les silos de données, et en réduisant le coût total de gestion des données. Le support natif de JSON dans MapR-DB permet également d’accélérer la création de valeur en donnant aux développeurs les moyens de produire plus vite un plus grand nombre d’applications métiers à partir de plus de sources et de types de données. MapR-DB supporte l’interface applicative Open JSON Application Interface (OJAI), qui est conçue comme une couche d’accès générique JSON pour bases de données, systèmes de fichiers, et flux de messages afin d’offrir une interface flexible et unifiée pour traiter d’importants volumes de données.

« MapR continue d’avancer sur la base de la plateforme de données innovante qui est au cœur de sa distribution Hadoop », explique Nik Rouda, analyste senior au sein de l’Enterprise Strategy Group. « L’ajout d’une capacité de base de données documentaire (JSON) étend élégamment la puissante offre NoSQL MapR-DB pour couvrir de manière transparente plus de types de données métiers non structurées. Cela simplifie et accélère la construction d’applications Big Data, sans la contrainte d’un déplacement initial des données ».

« MapR permet aux développeurs d’entreprise de créer de nouvelles applications à valeur ajoutée dont ils ne pouvaient que rêver jusqu’ici », indique Anil Gadre, Vice-Président senior produits, MapR Technologies. « En intégrant étroitement une base documentaire NoSQL au sein de notre plateforme, nous donnons aux développeurs les moyens de construire rapidement de nouvelles applications qui exigent une latence extrêmement limitée, et une flexibilité considérable pour le support de multiples types de données au sein d’un unique cluster ».

Disponibilité

Une préversion pour développeurs de MapR-DB avec support natif de JSON est dès à présent disponible et peut être téléchargée ici. Ces nouvelles capacités seront disponibles pour tous au sein de MapR-DB au cours du prochain trimestre.

Une démonstration interactive des nouvelles fonctionnalités de MapR-DB JSON combinées au logiciel Visual Action est disponible ici.

45 postes en CDI sont à pourvoir chez Infotel

Soumis par fredericmazue le

Infotel recrute 45 postes dans ses agences de Lyon, Nice, Aix-en-Provence et Monaco.  Les agences d’Infotel dans le Sud-Est de la France (Lyon, Nice, Aix-en-Provence et Monaco) permettront aux nouvelles recrues de se spécialiser au contact de grands comptes internationaux sur des technologies telles que la mobilité et le Big Data. La présence de sociétés comme Airbus Helicopters, Air France, IT-CE, i-BP ou encore l’Office Européen des Brevets, dans le portefeuille clients d’Infotel est le reflet d’une expertise de pointe.

« Avec plus de 13 agences en France, Infotel offre la flexibilité d’une entreprise locale et la force d’un groupe d’envergure nationale. Notre plan de recrutement dans la région Sud-Est, nous permet d’asseoir notre position sur un marché toujours plus concurrentiel. En effet, cet objectif de recrutement est en corrélation avec nos ambitions qui allient développement et diversification. Nous avons mis un point d’honneur à recruter un grand nombre de juniors avec moins deux ans d’expérience, ce qui représente environ 60 % de nos embauches » souligne Jean-Marie MEYER, Directeur Général d’Infotel.

45 postes en CDI sont à pourvoir dans les agences Sud-Est d’Infotel :

  • 10 à Lyon
  • 10 à Nice
  • 20 à Aix-en-Provence
  • 5 à Monaco

Infotel propose des CDI, des stages de fin d’études ainsi que des formations pour les jeunes diplômés. Les annonces sont destinées à recruter des profils juniors ou plus expérimentés et correspondent aux métiers suivants : Ingénieur d’Études .NET (Asp.NET, C#, Sharepoint), Ingénieur d’Études Java JEE/HTML5 (AngularJS, Spring), Ingénieur d’Études Android (SDK Android, API Rest), Ingénieur d’Études iOS (Swift, Objective-C), Ingénieur d’Études Big Data (Hadoop, Mongo DB, Elastic), Analystes fonctionnels Banque/Assurance (z/OS, DB2, Pacbase, Cobol), Ingénieurs d’Études décisionnel (BO, SAS, ODI, Informatica…), Chefs de projets MOA et MOE, PMO, Techniciens réseaux et Chefs de projet déploiement. 

Infotel recherche 120 nouveaux collaborateurs dans la région Ile-de-France

Soumis par fredericmazue le

Infotel recrute près de 300 nouveaux collaborateurs pour l’année 2015 sur tout le territoire français dont 120 postes dans ses agences parisiennes.

Les agences parisiennes d’Infotel (Bagnolet, Nanterre, Neuilly) permettront aux nouvelles recrues de se spécialiser au contact de grands comptes internationaux sur des technologies telles que la mobilité et le Big Data. La présence de sociétés comme Airbus, Air France, PSA Peugeot Citroën, BNP Paribas ou encore, l’Office Européen des Brevets, dans le portefeuille clients d’Infotel est le reflet d’une expertise de pointe.

« Avec plus de 13 agences en France, Infotel offre la flexibilité d’une entreprise locale et la force d’un groupe d’envergure nationale. Nous avons à cœur de faciliter l’insertion des jeunes dans le monde professionnel, c’est pourquoi, 50 % des recrutements en Ile-de-France seront des jeunes diplômés. Nous proposons également 25 stages de fin d’études » souligne Michel Koutchouk, Directeur Général d’Infotel.

120 postes en CDI sont à pourvoir dans les agences parisiennes Infotel.

Infotel propose des CDI, des stages de fin d’études ainsi que des formations pour les jeunes diplômés. Les annonces sont destinées à recruter des profils juniors ou plus expérimentés et correspondent aux métiers suivants : Ingénieur d’Études .NET (Asp.NET, C#, Sharepoint), Ingénieur d’Études Java JEE / HTML5 (AngularJS, Spring), Ingénieur d’Études Android (SDK Android, API Rest), Ingénieur d’Études iOS (Swift, Objective-C) et Ingénieur d’Études Big Data (Hadoop, Mongo DB, ElasticSearch).


BUILD 2014 : Azure, Visual Studio et mobile

Soumis par francoistonic le
Image
Image
Image

La 2e plénière de la conférence BUILD a été comme prévu le moment de nombreuses nouveautés et évolutions pour les développeurs. Azure (et non plus Windows Azure) a été la vedette. 

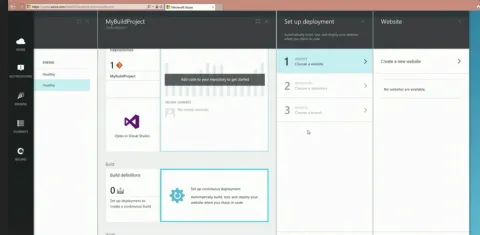
Tous les services Azure, ou presque, sont renouvelés. Tout d’abord, le portail d’administration subit un grand nettoyage, le premier en 2 ans. La nouvelle interface se veut plus dynamique et plus simple à utiliser. Sur la partie « site web », Microsoft joue sur 3 niveaux : le support de l’autoscaling, du traffic manager, Java, les WebJobs, le backup. A cela se rajoute le support des dernières versions de ASP.Net. La partie outil a elle aussi été grandement revue : nouveau projet, automatisation PowerShell, support des projets Node.JS.

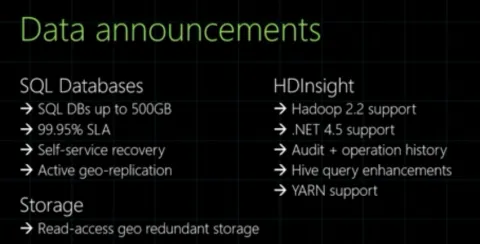
Sur la partie mobile, Azure propose là aussi plusieurs belles améliorations : .net backup, support SSO avec Active Directory, amélioration du support des outils Visual Studio, remote debug. Azure Active Directory est désormais compatible avec iOS et Android. Sur la partie donnée, HDInsight (distribution Hadoop), Microsoft supporte Hadoop 2.2, .Net 4.5, les requêtes Hive et supporte YARN. Sur SQL Database, la base de données peuvent dépasser 500 Go et le SLA est désormais de 99,95 %.

Pour les outils, Microsoft a montré les premières possibilités de Roslyn, une nouvelle génération de compilateur notamment pour les applications .Net (voir notre article dans Programmez ! 173). 

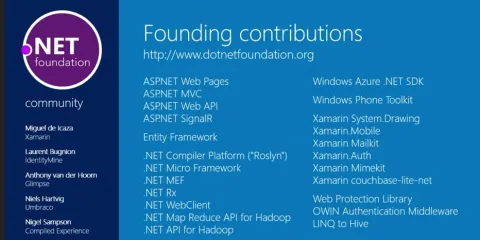
Mais les plus importantes annonces furent sur l’Open Source. Microsoft a décidé d’investir plus massivement dans l’Open Source. Ainsi plusieurs projets importants sont désormais ouverts : WinJS, Roslyn. Le plus gros pari de Microsoft est la création de la .Net Foundation comme on peut avoir Apache Fondation, Eclipse Fondation, etc. La fondation va récupérer et gérer les projets ouverts de Microsoft : Roslyn, ASP.Net MVC, des projets Xamarin, des SDK, etc. La fondation aura une gouvernance assez ouverte. Nous y trouvons Microsoft et surtout Miguel de Icaza de Xamarin. La fondation doit renforcer la diffusion des technologies .Net tout en dynamisant la communauté. 

Site : http://www.dotnetfoundation.org

A lire sur .Net Native et les nouveautés .Net : 

http://blogs.infinitesquare.com/b/build2014/archives/next-generation-net#.Uz7X3l5PC1E

Oculus Rift + Babylon.JS : http://blogs.infinitesquare.com/b/simon/archives/oculus-rift-et-babylon-js#.Uz7YC15PC1E

Sur Windows et l’internet des objets : http://channel9.msdn.com/Events/Build/2014/2-511

François Tonic

Windows Azure s'appellera Microsoft Azure dès le 3 avril 2014

Soumis par fredericmazue le

Dès le 3 avril prochain, Windows Azure, le cloud public de Microsoft, changera de nom pour s'appeler Microsoft Azure.

Un changement de nom annoncé très officiellement sur le blog de Windows Azure (pour l'instant ;-) afin de bien marquer l'évolution du service.

En effet, au fil du temps, ce cloud lancé en 2010 a perdu ses allures de concurrent à l'EC2 d'Amazon réservé aux applications et outils de développement spécifiquement Windows.

Azure est aujourd'hui capable d'accueillir des machines virtuelles Linux et des applications Oracle. En outre .NET il permet de travailler avec  Python, Ruby, Node.js, Java, Hadoop,

D'où ce changement de nom qui veut refléter ce qu'est Windows Azure aujourd'hui.

Des disques durs spécialement conçus pour les datacenters

Soumis par fredericmazue le

Western Digital commercialise une nouvelle gamme de disques durs, conçus pour permettre aux datacenters de répondre à la demande en plein boom en matière de stockage. Reposant sur une plate-forme professionnelle qui garantit aux datacenters d'être fiables 24 h /24 et 7 j/7, les disques durs WD Se ont été conçus pour offrir à la fois les performances, la fiabilité et la robustesse attendues de la part des environnements répliqués de grande capacité, des environnements de stockage NAS (Network Attached Storage) de moyenne envergure et des applications de sauvegarde / archivage.

      « Les installations de cloud actuelles nécessitent des solutions abordables pour mettre en place des systèmes de stockage à grande échelle, tout en assurant la fiabilité 24 h /24 et 7 j/7 requise pour réduire au minimum le coût total d'exploitation », explique Richard E. Rutledge, senior vice-président en charge de la division des solutions de stockage WD pour datacenters. « En tant qu'utilisateurs d'énormes volumes de données issues de nos travaux de conception et d'ingénierie, nous avons, chez WD, été forcés - comme de nombreuses autres entreprises - d'adopter des méthodologies « map-reduce » afin d'analyser de façon efficace nos données. Nous utilisons les disques WD Se dans notre immense datacenter, où nous avons testé en situation la technologie Apache Hadoop. »

    Le constructeur que les disques durs WD Se ont subi plus de 5 millions d'heures de tests de fonctionnement et de variations thermiques et plus de 20 millions d'heures de tests dans des situations de charges réelles imposées à des serveurs et systèmes de stockage. Ils intègrent également les technologies suivantes :

un double-processeur qui multiplie par deux la puissance de traitement, permettant de maximiser les performances des systèmes ;

la technologie RAFF (Enhanced Rotary Acceleration Feed Forward), reposant sur des composants électroniques évolués, et qui surveille le disque et corrige en temps réel les vibrations linéaires et celles liées aux rotations ;

la technologie d'actionneur à deux phases qui améliore la précision positionnelle de la tête sur la ou les pistes ;

la technologie StableTrac qui sécurise l'axe du moteur à chacune de ses extrémités afin de réduire les vibrations du système et qui stabilise les disques, pour un pistage précis lors des opérations de lecture / écriture, permettant d'obtenir des performances supérieures pour les transferts de données ;

un capteur de chocs à axes multiples qui détecte automatiquement le moindre choc et compense afin de protéger les données ;

la technologie RAID TLER (time-limited error recovery) exclusive qui protège les disques des pannes pouvant être causées par des processus de correction d'erreurs trop longs (fréquent pour les disques utilisés dans les stations de travail) ;

la technologie de hauteur de passage dynamique, qui corrige la hauteur des têtes en temps réel pendant les opérations de lecture / écriture, pour une fiabilité optimale.

Plus d'informations : www.wd.com/fr/products/products.aspx?id=1050