GPU

Et si les malwares se nichaient dans les cartes graphiques ?

Soumis par fredericmazue le

Les antivirus classiques recherchent les malwares en partant du principe qu'ils s'exécutent dans la CPU d'une machine et résident dans la mémoire accessible à cette CPU. Bien sûr ! Un virus ou un malware ne peut pas se loger dans une carte graphique et s'exécuter avec la GPU de la carte dites-vous.

Mais vous avez tort, car cela est sans compter avec les possibilités toujours plus ébouriffantes des cartes graphiques et de leur GPU.

C'est ainsi que des développeurs anonymes ont publié sur GitHub deux malwares s'exécutant dans une GPU. Le premier est JellyFish, un rootkit Linux, un malware preuve de concept, indétectable par les antivirus existant et susceptible de résister à un reboot à chaud de la machine. Ce rootkit utilise OpenCL qui doit être installé sur la machine. Les développeurs de JellyFisk font remarquer que OpenCL est installé par défaut sur les Mac OS X :-) Leur rootkit doit d'ailleurs fonctionner prochainement sur ce système.

Un keylogger basé sur le rootkit JellyFish.

L'un comme l'autre doivent fonctionner aussi bien sur GPU AMD que GPU NVIDIA. Une version fonctionnelle sous Windows du keylogger doit arriver rapidement.

Les travaux de ces développeurs sont basés sur un document qui détaille la preuve de concept, et dont les auteurs sont cette fois parfaitement identifiés. Il s'agit de chercheurs de l'Université de Columbia. Le document est accessible ici. 

NVIDIA développe une version améliorée des compilateurs d'optimisation PGI

Soumis par fredericmazue le

NVIDIA annonce le développement d’une version améliorée des compilateurs d'optimisation PGI. Selon le fondeur cette version permettra aux développeurs de déployer rapidement de nouvelles applications et d'exécuter sans effort des applications basées sur Linux x86 accélérées par GPU, sur des systèmes de processeurs IBM POWER.

Les compilateurs PGI d'optimisation Fortran, C et C++ pour POWER comporteront une interface utilisateur, des fonctionnalités de langage et de programmation parallèle ainsi que des capacités d'optimisation identiques à celles qui sont disponibles sur les compilateurs PGI pour Linux x86.

Les nouveaux compilateurs prendront également en charge les systèmes de calcul haute performance (HPC) basés sur l'architecture IBM POWER, dont les systèmes IBM POWER8 accélérés par GPU récemment annoncés par NVIDIA, ainsi que d'autres systèmes en cours de développement par les membres de la fondation OpenPower.

« Notre objectif est de permettre aux développeurs utilisant le calcul haute performance de recompiler et d'exécuter leurs applications sur les principaux processeurs et plateformes accélérées par GPU avec un niveau de performance uniformément élevé et une base de code source commune », a déclaré Douglas Miles, directeur du service PGI Compilers & Tools chez NVIDIA. « Nous prévoyons que la plupart des applications x86 accélérées par GPU et actuellement construites avec des compilateurs PGI pourront être reliées aux systèmes POWER accélérés par GPU grâce à une simple recompilation. »

Le processeur central POWER8 est un processeur massivement multi-thread comportant 12 cœurs qui peuvent gérer respectivement huit threads de hardware simultanément. Initialement positionnée pour les applications de serveur cloud et le big data, l'architecture POWER8 génère une forte demande auprès des clients utilisant le calcul haute performance en raison de ses nombreuses fonctionnalités axées sur les performances, comme la présence d’un port CAPI (Coherent Accelerator Processor Interface) à large bande passante et la prise en charge future de l'interconnexion haut débit pour processeur graphique NVLink.

100 000 dollars pour une startup exploitant les GPU NVIDIA

Soumis par fredericmazue le
Image

NVIDIA recherche une douzaine de concurrents potentiels pour notre Early Stage Challenge - où de jeunes startups utilisant des GPU sont en lice pour un prix de 100,000 dollars.

Voilà comment cela fonctionne: les PDG ont quatre minutes pour présenter leur entreprise à un groupe d'investisseurs en capital-risque, et encore quatre minutes pour répondre aux questions.

Les capital-risqueurs, avec le public, choisissent immédiatement le gagnant. Sous les applaudissements, le PDG revient alors sur scène pour recevoir le chèque de 100 000 dollars !

Tout se déroulera  pendant deux petites heures lors de la sixième GPU Technology Conference annuelle, du 17 au 20 mars 2015 dans la Silicon Valley, qui l'an dernier a attiré quelque 3400 participants de plus de 40 pays.

Vous êtes intéressé ? NVIDIA est à la recherche d’entreprises naissantes, qui n’ont pas soulevé plus de 1 million de dollars et qui utilisent les technologies GPU dans des domaines tels que l'informatique, la visualisation, l'analyse de données, le divertissement, l'automobile, le cloud et la mobilité.

Pour en savoir plus :

http://blogs.nvidia.com/blog/2014/10/14/ecs-nvidia/
http://www.gputechconf.com/present/early-stage-challenge

L'accélération matérielle disponible pour PhysX sous Linux

Soumis par fredericmazue le

Bonne nouvelle pour les utilisateurs, joueurs et scientifiques sous Linux. NVIDIA vient de publier une nouvelle mouture de son SDX pour PhysX qui prend désormais en charge l'accélération matérielle sous Linux, en plus de Windows, d'OS X et certains smartphones.

Pour mémoire, PHysX est une solution multi plates-formes pour intégrer des effets 3D réalistes dans des applications de jeu, mais aussi dans des applications scientifiques.

PhysX permet d'exploiter l'accélération matérielle des GPU si le code des applications est écrit avec la librairie CUDA du même NVIDIA.  

Source : nextimpact.com

[video:https://www.youtube.com/watch?v=EWFkDrKvBRU]

Paint.net 4.0

Soumis par fredericmazue le
Image

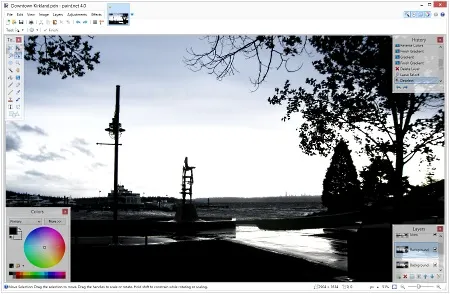
Paint.net, le logiciel gratuit qui se présente comme une alternative à Photoshop, vient d'arriver en version 4.0.

Pour l'occasion Paint.net a été entièrement réécrit à partir du framework .NET 4.5. Jusqu'ici, il reposait sur le framework .NET 2.0. Ceci implique que cette version ne peut pas fonctionner sur le encore très populaire Windows XP, mais qu'elle requiert un Windows 7 SP 1 au minimum.

En revanche, Paint.net 4.0 exploite les processeurs multi-coeurs. Un double coeur est d'ailleurs recommandé pour l'utiliser. De plus Paint.net 4.0 exploite l'accélération matérielle GPU via Direct2D.

Les graphistes apprécieront le nouvel historique qui a une granularité plus fine, et l'outil de sélection qui supporte désormais l'anti-aliasing.

NVIDIA propose un roadshow dédié au rendu GPU sur la création numérique

Soumis par fredericmazue le

Du 24 avril au 30 avril 2014, ce roadshow va présenter les applications de deux leaders en matière de rendu GPU, les éditeurs Chaos Group et Bunkspeed. Des applications rendues possibles grâce aux GPU de NVIDIA et aux stations de travail HP.

De la prévisualisation jusqu’au rendu final, l’équipe de Construct a mis en œuvre un processus de travail révolutionnaire, impliquant tous les GPU et s’appuyant sur V-Ray RT de l’éditeur Chaos Group pour 3ds Max, ainsi que sur le logiciel Autodesk MotionBuilder fonctionnant avec les cartes graphiques NVIDIA Quadro K6000 et Tesla K40s.

Présenté pour la première fois lors du GTC 2014, vous pouvez découvrir le premier teaser du court métrage Construct.

Les designers ont utilisé le logiciel de Bunkspeed pour le « prototypage numérique », accélérant ainsi le processus de la conception à l’élaboration. Les produits rapides, amusants et faciles à utiliser de l’éditeur Bunkspeed permettent d’obtenir une qualité de visualisation exceptionnelle en association avec les GPU NVIDIA Quadro.

Découvrez le trailer de Bunkspeed.

Sponsorisé par Autodesk, Chaos Group, HP, PNY, Bunkspeed et NVIDIA, cette série de séminaires entre dans les coulisses pour y découvrir l’approche révolutionnaire de cette équipe.

Enregistrez-vous à l’un des séminaires suivants et remportez une des 6 cartes graphiques NVIDIA Quadro K5000, en assistant à l’une des sessions ci-dessous en direct !

24 avril : Varsovie à l’Hôtel Radisson Blu Sobieski

25 avril : Paris à l’Hôtel Radisson Blu Paris Boulogne

28 avril : Munich à l’Hôtel Hilton Munich Park

29 avril : Berlin à l’hôtel Radisson Blu

30 avril : Londres à l’Hôtel Courthouse

Pour plus d’informations : http://www.nvidia.fr/object/nvidia-gpu-rendering-roadshow.html

Le Khronos Group a publié les spécifications de WebCL 1.0

Soumis par fredericmazue le

C'est à l'occasion de la Game Developer Conference que le Khronos Group a annoncé avoir finalisé les spécifications de WebCL 1.0, et publié celles-ci.

WebCL est un standard qui définit comment doit s'opérer l'interaction avec le standard OpenCL. OpenCL est un standard pour le calcul parallèle, permettant de déporter les travaux de calculs lourds de la CPU vers la GPU des ordinateurs et/ou d'exploiter le multi-coeurs des CPU.

Lorsque WebCL sera implémenté par les navigateurs, il sera possible d'envisager d'écrire en JavaScript des applications très gourmandes en ressources, comme des applications scientifiques ou des animations 3D. Les applications s'exécuteront dans le navigateur, pour peu que l'OS sous-jacent dispose d'une implémentation OpenCL.

CUDA 6 est disponible

Soumis par fredericmazue le
Image

NVIDIA vient de mettre à disposition la sixième mouture (en Release Candidate) de sa librairie CUDA, dédiée à la programmation parallèle qui permet de déporter les calculs lourd du CPU vers la GPU de l'ordinateur. NVIDIA évoque dans ces conditions une accélération des applications par un coefficient 10.

Les principales fonctionnalités de la plateforme CUDA 6 sont notamment :

  • une Mémoire Unifiée :simplifie le processus de programmation en permettant aux applications d'accéder à la mémoire des CPU et GPU sans qu'il soit nécessaire de copier manuellement les données de l'une vers l'autre. La prise en charge d'une accélération du GPU avec un plus large éventail de langages de programmation est également facilitée.
  • la fonctionnalité Bibliothèques « Drop-in » : permet d'accélérer automatiquement jusqu'à 8 fois le temps de calcul des applications BLAS et FFTW en remplaçant simplement les bibliothèques de CPU existantes par les bibliothèques accélérées par le GPU.
  • Optimisation multi-GPU : les bibliothèques BLAS et FFT GPU entièrement revues permettent d'améliorer automatiquement les performances et peuvent concerner jusqu'à huit GPU pour un seul nœud, ce qui délivre une puissance atteignant jusqu'à neuf téraflops, des performances deux fois plus précises par nœud, permettant ainsi de gérer des charges de travail encore plus importantes (jusqu'à 512 Go). L'optimisation multi-GPU peut également être utilisée avec la nouvelle bibliothèque BLAS.

En plus de ces nouvelles fonctionnalités, la plateforme CUDA 6 offre toute une gamme d'outils de programmation, de bibliothèques mathématiques accélérées par GPU, des guides de documentation et de programmation.

La version 6 de la boîte à outils CUDA est attendue pour le début de l'année 2014. Les membres du programme des développeurs enregistrés de calcul CUDA/GPU seront avertis dès que la plateforme sera disponible au téléchargement. Pour rejoindre ce programme, inscrivez-vous ici.

Les GPU Tesla de NVIDIA vont accélérer le supercalculateur Blue Waters du NCSA

Soumis par fredericmazue le

Le National Center for Supercomputing Applications(NCSA), situé dans l'Université de l'Illinois à Urbana-Champaign, va déployer un supercalculateur Cray boosté par les GPU NVIDIA Tesla, dans le cadre de la conception d'un des systèmes informatiques les plus puissants du monde : le projet Blue Waters. 

Le recours aux GPU Tesla permettra au NCSA de répondre à la mission du projet Blue Waters, qui est de déployer un supercalculateur capable de supporter une performance d'un pétaflops sur une gamme diversifiée d'applications de sciences vivantes et d'ingénierie. Avec le soutien de la National Science Foundation et de l'Université de l'Illinois, Blue Waters permettra aux scientifiques et ingénieurs à travers les États-Unis d'effectuer des recherches scientifiques révolutionnaires.

"Le NCSA est ravi de l'inclusion des GPU Tesla de NVIDIA dans Blue Waters", a déclaré Thom Dunning, directeur de l'Institute for Advanced Computing Applications and Technologies et du National Center for Supercomputing Applications à l'Université de l'Illinois à Urbana-Champaign. "Les GPU offrent des capacités extraordinaires pour les calculs numériques intensifs. De plus, leur bonne rentabilité et leur efficacité énergétique sont de sérieux atouts pour concevoir les futurs supercalculateurs."

"Le NCSA a saisi cette occasion pour faire de Blue Waters un instrument de calcul scientifique encore plus étonnant que ce qui était prévu initialement", a déclaré Steve Scott, Directeur technique de Telsa chez NVIDIA . "Les performances de Blue Waters et sa facilité d'accès permettront à la communauté scientifique d'accélérer la course pour une meilleure science ".

Les supercalculateurs Extreme-scale, comme Blue Waters, permettent des simulations informatiques pour mieux reproduire les phénomènes de la Nature. Plus de 25 équipes scientifiques ont déjà été sélectionnées pour mener des recherches sur Blue Waters, dans des domaines allant de la dynamique moléculaire et de l'astrophysique, au génie parasismique et à la science des matériaux.

Les GPU NVIDIA Tesla vont accélérer certaines de ces applications de calcul intensif avec l'aide du grand nombre de processeurs classiques du système Cray. Le système Blue Waters sera un puissant supercalculateur hybride avec plus de 235 baies Cray XE6, et plus de 30 baies d'une future version du supercalculateur Cray XK6 annoncée récemment, et qui renferme la prochaine génération des GPU NVIDIA Tesla basée sur l'architecture "Kepler" .

Le projet Blue Waters se concentre sur la performance pétascale soutenue pour des défis scientifiques et d'ingénierie. Le NCSA va travailler en étroite collaboration avec NVIDIA et Cray dans le but d'étendre l'utilisation efficace de cette partie de l'architecture Blue Waters pour des applications réelles.

Les GPU Tesla sont des accélérateurs massivement parallèles basés sur l'architecture de calcul parallèle

CUDA. Les développeurs d'applications pour le supercalculateur Blue Waters peuvent accélérer les applications en C, C + + ou Fortran en utilisant les directives de compilation simple, ou avec des outils CUDA de NVIDIA. Les directives de compilation sont une approche qui évolue rapidement, ce qui permet aux développeurs d'augmenter simplement leur code avec quelques conseils qui guident le compilateur sur la manière de paralléliser automatiquement l'application.