IA

Guerre des talents IA : OpenAI offre des bonus pour s'opposer à Meta

Soumis par francoistonic le

Meta recrute partout où il peut pour construire son Superintelligence Labs. Ces dernières semaines, Apple avait été une des cibles principales. OpenAI, selon les informations publiées par The Information, veut sécuriser les talents et les ingénieurs clés pour garder les équipes et continuer à évoluer. Pour se faire, des bonus seront offerts à un millier d'employés, soit le tiers des efficaces d'OpenAI. 

Ces primes pourront dépasser plusieurs millions de dollars pour les profils les plus stratégiques. Le montant sera calculé par l'apport de la personne et l'ancienneté. Trois options possibles : en argnet, en action ou un mixe des deux. Récemment, Sam Altman, le patron d'OpenAI, n'avait pas hésité à critiquer les méthodes "folles" de Meta en proposant des bonus de 100 millions. Pour Meta, l'enjeu sera de donner une cohérence à ces équipes. La concurrence ne laissera pas dépouiller sans réagir.

REX : un projet de 24 millions € et beaucoup de piscines

Soumis par francoistonic le
Image
Image
Image
Image

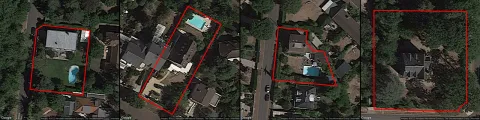
L'Etat Français a dépensé 24 millions d'euros dans un outil de détection de piscine pour permettre au FISC de détecter les constructions non déclarées. C'est un montant assez délirant que je n'arrive pas à m'expliquer tant sur le fond que sur la forme. J'ai donc tenté de refaire ce projet en quelques jours… Est-ce trop cher et peu rentable ?

Ce prototype a été monté par Jean-Philippe Encausse en septembre 2022 (voir en bas du rex)

Soyons pragmatique

Essayons de raisonner sur de grandes échelles pour mieux comprendre :

  • 5-10 ingénieurs confirmés, pendant 1an coute 1M€ (reste 23 à trouver)
  • Les projets d'IA de ce type sur lesquels j'ai travaillé était plutôt autour des 500K€ max
  • Ce ne sont pas les requêtes cloud, machine learning ou cartographie qui chargeraient autant le prototype :
    • Geocoding : 2000$ = 500K requêtes
    • StaticMap: 838$ = 500K requêtes
  • Peut-être que le SI du FISC est catastrophique, nécessitant une surcouche d'API ?

Alors oui si le cahier des charges stipule une précision de 99%, le rédacteur n'a rien compris au fonctionnement de l'IA. Surtout qu'avec cette approche par satellite on perd déjà toutes les piscines sous les arbres (sauf à utiliser un lidar), en intérrieur, l'ambiguité avec les bassins, etc … (30% de taux d'erreur d'après les syndicats)

Il y aurait d'autres manières de faire :

  • Imposer aux Piscinistes de déclarer leurs clients
  • Proposer une aide de l'Etat sur la sécurité des piscines (et donc de les déclarer)

En étant un peu créatif il y aurait plein d'autres manière de faire, mais jouons le jeu de l'IA.

Récupérer les données géographiques

J'ai pris 2 heures pour voir comment récupérer l'image d'un terrain sur Google Maps. Merci à Laurent CAVALLINI dont l'article était un bon point de départ.

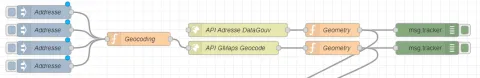
Geocoding

Etant donné une adresse je souhaite obtenir les coordonnées GPS. Les API de Google et du Gouvernement fonctionnent très bien et pratiquement gratuitement. Il suffit de faire une simple requête HTTP. J'ai eu quelques petit soucis avec celle du gouvernement qui me retournait par moment des coordonnées GPS arrondies.

Cadastre et Parcelle

Je souhaite obtenir le/les polygone(s) correspondant à une parcelle déclarée au cadastre. L'API du gouvernement fonctionne très bien ! Son temps de réponse est de quelques secondes par moment, mais on ne va pas se plaindre, c'est gratuit et anonyme ! En faisant quelques tests je me suis rendu compte que certaines parcelles n'était probablement pas à jour.

Image satellite

Je souhaite obtenir l'image correspondant à l'adresse / aux coordonnées sur GoogleMaps. Pour se faire nous allons calculer le centroide du polygon puis intérroger Google Static Map avec le tracé. Les cartes font 640×640 en Zoom x20 mais il est possible de contacter Google pour obtenir une meilleur définition et donc une amélioration de la reconnaissance par la suite.

Nettoyage

L'objectif est de mettre en avant la zone qui nous intéresse sans être perturbé par une piscine qui serait dans l'image mais chez le voisin. 

Encore une optimisation possible à cette étape en faisant de la datascience à l'ancienne:

  • saturer la couleur bleu intelligement
  • détecter les amas de couleur

Je n'ai pas eu le temps de creuser mais ce serait une étape indispensable pour améliorer le dataset même si les outils d'AutoML font déjà un peu ce travail à l'aveugle.

Machine Learning

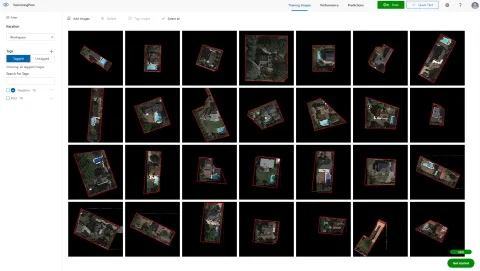
Maintenant, il faut produire un certain nombre d'image positive (avec piscine) et négative pour les injecter dans un outil d'intelligence artificielle. Le truc chouette avec CustomVision est qu'en plus de l'API il y a une interface visuelle pour déclencher des entrainements ou recatégoriser des contenus.

Aller plus loin

Voilà ce qu'il est possible de faire en quelques heures. Pour le moment, le projet fonctionne mais pour aller plus loin il faudrait :

  • Avoir une petite interface web pour donner une adresse et répondre Piscine / Pas Piscine
  • Recartégoriser les résutlats en branchant un outil de Mechanical Turk
  • Améliorer le DataSet en essayant de pré-identifier les piscine. Ou à l'inverse virer tout ce qui n'est pas piscine
  • Utiliser des données satélitaire custom de Google (ou d'un autre)
  • Se brancher au SI du FISC et itérer sur toutes les habitations françaises.

Pour moi ça ne peut pas couter 24 millions d'euros, ou sinon il faut m'expliquer. Car, au pire du pire du pire, il faudrait juste brancher ce petit projet à un Mechanical Turk pour obtenir l'avis d'Humain (vous savez les captchas de Google). Les Mechanical Turk coûtent quelques centimes d'euros et, pour être certain du résultat, vous pouvez interroger 10x chaque image on restera extrêmement loin des 24 millions d'euros. Et il n'y a pas de contrainte de temps de réponse. Enfin la beauté de l'exercice, c'est que ça alimentera l'IA qui sera de plus en plus performante.

Source : https://blog.encausse.net/2022/09/05/realiser-un-projet-de-24-millions-deuros-en-quelques-jours/
IA : entraînement vs inférence

Soumis par francoistonic le

En IA, nous utilisons souvent 2 termes : entraînement et inférence. Trop souvent, ils sont confondus alors qu'ils répondent à des contextes très précis. Cloudflare les définit ainsi :

  • L'entraînement constitue la première phase d'un modèle d'IA. Il peut s'effectuer selon une série d'essais et d'erreurs, ou selon un processus consistant à montrer au modèle des exemples d'entrées et de sorties souhaitées, ou associer les deux méthodes.
  • L'inférence correspond au processus suivant l'entraînement de l'IA. Plus un modèle est entraîné et affiné, meilleures seront ses inférences, sans aucune garantie toutefois qu'elles soient parfaites.

Quand on parle de LLM / SLM / TLM, on dit qu'ils sont pré-entraîné. Cela signifie que les modèles sont entraînés durant plusieurs mois en injectant des données pour les "former" à leur usage final. Cette phase est cruciale pour la qualité du modèle et les réponses qui seront générées. Cette phase est longue et exige beaucoup de puissance de calcul surtout pour les très grands modèles. 

L'inférence n'est pas un entraînement du modèle. Il s'agit des réponses générées par le modèle. Quand nous faisons une requête (via un agent, un chat, un prompt), la question est traitée par le service IA s'appuyant sur un modèle. Ce traitement au niveau du modèle est l'inférence. Il doit être rapide et le plus précis possible (la précision et la qualité dépendent du modèle). 

"L’inférence en intelligence artificielle désigne le processus par lequel un modèle préalablement entraîné génère une réponse à une requête utilisateur. Contrairement à l’entraînement, qui mobilise d’importantes ressources de calcul sur une longue période, l’inférence doit être rapide, efficace et répétée des millions de fois en production". (définition de FrenchWeb.fr)

Résumons :

- entraînement : apprendre aux modèles à partir des données, selon prend des mois ou des semaines, beaucoup de compute, il est ponctuel (par exemple : à chaque version du modèle)

- inférence : générer les réponses, rapidité de la réponse, nécessite moins de puissance. Elle est constante pour réagir à chaque demande

Arago : une startup française veut en finir avec les GPU dans l'IA

Soumis par francoistonic le
Image

Un des défis de l'IA est la capacité de calculs à utiliser pour l'entraînement, l'inférence et l'exécution des couches techniques. Il faut des dizaines de milliers de GPU. NVIDIA est le plus important fournisseur. Peut-on produire des puces IA capables de faire pareil mais en consommer moins d'énergie que les énormes GPU ? C'est l'ambition d'une startup française créée en 2004. Elle a levé 26 millions $ pour créer les prototypes et fixer les technologies.

Arago a choisi la technologie dite photonique, c'est-à-dire utilisant la lumière, pour accélérer les échanges au coeur des composants. Cette approche permet d'augmenter consiréblement les bandes passantes. Arago espère ainsi un meilleur rendement de la puce, moins d'énergie consommée. Bref : un meilleur ratio watt / dollars. Arago espère des réductions d'énergie de 10 à 30. Les équipes développent l'ensemble des couches et du design des composants. 

L'autre défi est que le futur composant soit totalement compatible avec les langages, les logiciels et les frameworks IA actuels. Il faut aussi que ce composant puisse se déployer dans les serveurs actuels. Pour optimiser le fonctionnement, Arago a développé sa propre couche logicielle : CARLOTA. Elle s'appuie sur PyTorch et permet d'abstraire la couche hardware bas niveau. 

Arago ouvre plusieurs postes à San Francisco, Paris et Tel Aviv. 

Podcast : Secure by design au niveau du code et l'infrastructure

Soumis par francoistonic le

Qu'est-ce que le Secure by Design, l'AppSec ? Est-ce que la sécurité change quand on parle de code et quand on parle d'infrastructure ? Nous échangeons avec Franck Farre et Sébastien Roche chez Sopra Steria.

[video:https://youtu.be/Kc42HnE5B3U autoplay:0]

Et aussi, écoutez notre podcast 75 : l'expérience développeur (DevEx) devient un levier clé pour attirer les talents, réduire le turnover et maximiser la performance.. Selon IDC, plus d’un milliard de nouvelles applications seront créées d’ici 2028 (IDC FutureScape), ce qui met une pression inédite sur les équipes de développement.

[video:https://youtu.be/FHlZMdZOHxQ autoplay:0]

40 % des projets d'agents IA seront annulés d'ici fin 2027 selon une vision du Gartner

Soumis par francoistonic le

Gartner aime publier des prédictions. Aujourd'hui, le cabinet prédit que plus de 40 % des projets d'agents IA seront annulés / arrêtés d'ici fin 2027. Les argument sont, finalement, les mêmes que celles déjà avancé ailleurs :

- la croissance des coûts : le budget peut rapidement explosé

- une valeur ajoutée peu claire pour l'entreprise et les équipes

- une gestion du risque incontrôlée

"La plupart des projets d’IA agentique sont actuellement des expériences préliminaires ou des preuves de concept qui sont principalement motivées par le battage médiatique et sont souvent mal appliquées. Cela peut empêcher les entreprise de percevoir le coût réel et la complexité du déploiement d'agents d'IA à grande échelle, retardant ainsi le passage des projets en production. Elles doivent aller au-delà du battage médiatique pour prendre des décisions stratégiques judicieuses quant à l'endroit et à la manière d'appliquer cette technologie émergente." commente Anushree Verma (Gartner). 

La tendance vers l'IA agentique représente un bond en avant en termes de capacités et d'opportunités de marché. L'IA agentique offrira de nouveaux moyens d'optimiser l'efficacité des ressources, d'automatiser les tâches complexes et d'introduire de nouvelles innovations métier, au-delà des capacités des robots d'automatisation scriptés et des assistants virtuels. Gartner prévoit qu'au moins 15 % des décisions quotidiennes soient prises de manière autonome grâce à l'IA agentique d'ici 2028, contre 0 % en 2024. De plus, 33 % des applications logicielles d'entreprise incluront l'IA agentique d'ici 2028, contre moins de 1 % en 2024.

Sommet pour l'IA : pas d'accélération de l'usage de l'IA dans les entreprises françaises

Soumis par francoistonic le

Le Sommet pour l'IA promettait beaucoup. Elastic, avec OpinionWay, a voulu connaître l'impact des annonces du sommet auprès des dirigeants français. Une adaptation est-elle visible ? Une accélération de l'IA ? Quelles conséquences ces mesures ont-elles (déjà) eu sur leur activité ? En bref, y a-t-il eu un avant et un après “Sommet pour l’IA” pour les patrons français ? 

Selon l'enquête, l'IA est une réalité pour 73 % d'entre elles mais, point important, 56 % notent un accès parfois difficile aux services et ressources pour le déploiement de l'IA. "Si 73 % des entreprises sondées ont construit et mis en place une stratégie IA, elles sont malgré tout 56 % à avoir un accès limité aux ressources nécessaires pour développer des projets d’intelligence artificielle. Celles-ci englobent entre autres l’accès aux talents spécialisés dans l’IA, aux infrastructures, financements et puissance de calcul. Seules 20 % des entreprises déclarent être en possession de toutes les ressources nécessaires, ce chiffre monte à 33 % chez les entreprises de plus de 250 salariés." commente l'étude. 

Trois complexités émergent :

- la maîtrise des données (57 %),

- la mesure des retours sur investissements (45 %)

- la sélection des cas d’usages (33 %).

Ce qui n'est pas une surprise comme nous l'avions évoqué dans les bonnes pratiques pour échouer son projet IA :

 https://www.programmez.com/actualites/pourquoi-les-projets-ia-echouent-7-bonnes-pratiques-37925

"Dans le détail, les entreprises de plus de 250 salariés (qui sont celles ayant le plus accès aux outils nécessaires au déploiement de l’IA) ont le plus de difficulté à maîtriser leurs données (65 %). Les organisations de 100 à 249 salariés sont celles qui ont  le plus de difficultés à mesurer leur ROI (51 %). Enfin, les plus petites structures du panel, comptant moins de 100 collaborateurs, butent considérablement sur la sélection de cas d’usage (38 %.). Seules 11 % des entreprises sondées déclarent ne rencontrer aucune difficulté pour déployer l’IA." précise l'étude. 

Est-ce que la sommet sur l'IA a fait bouger les lignes ? Ce fut un moment médiatique mais dans la réalité, les retombées réelles sont modestes. 40 % des dirigeants disent que les annonces du sommet vont accélérer le développement de modèles, poursuivre l'usage de l'IA ou encore permettre à la France de gagner en compétivité.

Le constat final est sévère mais réaliste : seuls 7% des répondants ont accéléré leurs initiatives. Celles-ci se répartissent entre les efforts de formation (3%), l'augmentation des investissements (2%), la nouvelle gouvernance (2%) et l'augmentation du nombre de cas d'utilisation (2%).

La France à la pointe des conteneurs et de la génialissimes selon Nutanix

Soumis par francoistonic le

Nutanix a publié son enquête Enterprise Cloud Index 7e édition. Petite surprise, la France est plutôt bon élève en IA et en conteneurs : 90 % des entreprises ont déjà adopté une stratégie d’IA générative, avec deux objectifs principaux : gagner en productivité et réduire les coûts opérationnels et pour 96 % des répondants, la confidentialité des données devient une priorité. Petite surprise : l’adoption de la conteneurisation est massive pour l’ensemble des répondants français, lesquels sont 100 % à avoir entamé son adoption. 

Les workloads conteneurs les plus courants sont le développement et le test, ainsi que l’IA générative et les bases de données. Cela démontre que la conteneurisation est ancrée dans les usages classiques tout en étant progressivement adoptée dans des domaines plus innovants. Cependant, l'usage des conteneurs ne supprime les défis de la modernisation des infrastructures et des applications. Reste aussi à réduire les silos techniques. 

"L’essor de l’IA générative impose une réévaluation des politiques de sécurité. 67% des répondants en France considèrent que la confidentialité des données est un défi majeur pour leur entreprise dans le cadre de l’intégration de l’IA générative. Tandis que pour 96 % des répondants, la confidentialité des données est une priorité absolue, 98 % estiment par ailleurs que leur organisation peut encore renforcer la sécurisation des modèles et des applications IA. Le principal frein à l’adoption de l’IA reste l’utilisation de données sensibles dans les grands modèles de langage, dans un contexte de contraintes réglementaires renforcées. Ces exigences renforcent selon les répondants la nécessité d’infrastructures modernisées, 87 % des décideurs français considèrant leur IT actuelle comme insuffisante pour faire face aux nouvelles charges de travail." explique l'étude.

Pourquoi les projets IA échouent ? 7 bonnes pratiques

Soumis par francoistonic le

L'IA est partout que l'on parle de chat (= système de prompts), de GenIA et d'agents IA. Mais réussir son projet IA n'est ni simple, ni magique. Comme tout projet IA, l'IA doit se penser en amont.Voici 7 bonnes pratiques pour faire échouer son projet IA :1 / je fonce ! Je ne pense pas usage mais fonctionnalité ! Eh oui, trop souvent, et encore aujourd'hui, nous pensons intégrer sans penser à l'usage que nous voulons en faire. Pourquoi l'IA ? Pour qui ? Pour quoi faire ? Il faut d'abord définir les usages, le cadre fonctionnel, les données et l'infrastructure qui seront derrière2 / l'accès aux données : ah la fameuse couche d'accès aux données. En IA, l'accès aux données est vital, surtout si nous entraînons nos modèles. Bref : les bonnes données, au bon moment. Il ne faut pas sous-estimer les données dans un projet IA.3 / Modèle de développement / modèle de déploiement : nous prenons ce que nous trouvons et nous intègrons GPT, ChatGPT ou tout autre service. Bien entendu, nous pouvons intégrer bêtement un service de GenIA qui risque d'être contre-productif car non adapté à nos usages. Il faut définir quels services utiliser, ce qui déterminera le modèle de développement pour l'intégrer. Il faut aussi penser à l'infrastructure à déployer ou à provisionner.4 / complexité du service : Là encore, nous pensons trop rarement, ou pas assez, à la complexité d'un projet IA. Ce n'est pas plug and play. Si l'intégration est mal pensée, le projet vire au cauchemar pour les développeurs et les utilisateurs. L'intégration à votre app sera bancale ou fonctionnera mal.5 / la gouvernance des données ! Si vous avez votre propre modèle ou que vous injectez vos données dans l'IA utilisée, outre l'accès à ces données, il y a la gouvernance des données qui doit gérer l'accès, l'évolution des données et la qualité des données. Quelles données sont autorisées et celles qui ne le sont pas ?6 / l'augmentation des coûts ! Pas de souci, une IA c'est pas cher. Faux et re-faux. Il y a les coûts directs et les coûts cachés (disons moins directs). Un service IA peut coûter très cher. Il faut choisir le plan du service, dimensionner les services IA selon la charge attendue, dimensionner l'infrastructure qui va avec, le coût supplémentaire des services cloud. Si vous faites de l'IA sur vos serveurs ou localement, il faut voir l'impact sur l'entraînement et si votre infrastructure peut supporter la nouvelle charge. Il y a donc le TCO (coût de possession) et éventuellement le ROI (retour sur investissement) à définir ou du moins, à estimer.7 / les hallucinations de l'IA : Oups, nous avons oublié de vérifier si notre IA ne dévie pas ou si nous avons correctement défini des limites syntaxiques ou fonctionnelles. Le biais de l'IA est connu et réel. Il faut donc borner l'usage, vérifier la qualité des prompts et éviter toute corruption du modèle.Bonus : LLM, SML ou TML ? Si nous prenons une IA du marché sans adaptation, ce sera souvent du classique LLM. L'usage que nous voulons faire de l'IA va dicter le type de modèles à utiliser. Par exemple : l'IA est très généraliste, donc il me faut un modèle très large non spécialisé. Si au contraire, je veux un usage lié à mon activité ou à mes équipes, il faudra bien choisir le modèle et lui injecter mes données spécifiques. Nous pouvons partir d'un modèle très large pour le tuner et aboutir à un SML ou un TML pour réellement l'optimiser à nos usages réels.Librement inspiré de la conférence NetApp - Nvidia "AI industry impact"

France : les offres d'emploi liés à l'IA explosent en 2024

Soumis par francoistonic le

Selon une étude publiée sur l'emploi IA par PwC, les offres d'emploi liées à l'IA (compétences IA) ont explosées en France passant de 21 000 en 2018 à plus de 166 000 en 2024. Le pays est même le plus actif en Europe. Tous les secteurs ne sont impactés de la même manière. Les secteurs finances et l'IT sont les plus actifs. Selon l'étude, l'agriculture, l'immobilier, la culture, l'administration, la construction sont aussi impactés par l'IA. Il s'agit d'être formé à l'IA ou de savoir l'utiliser. Pour PwC, il s'agit d'une transformation des métiers et des profils recherchés. 

La demande de diplômes IA connaît une croissance parallèle mais encore faut-il que les entreprises aient une vision IA claire et définie. Des compétences IA ne suffisent pas. 

L'étude met en avant :

  • 166 000 offres d’emploi liées à l’IA publiées en France en 2024
  • La productivité a été multiplié par 3 entre 2018 et 2024 dans les secteurs les plus exposés à l’IA
  • Les entreprises les plus exposées à l’IA ont enregistré en 2024 une croissance du CA par employé trois fois supérieure à celles qui le sont moins
  • Les collaborateurs disposant de compétences en IA perçoivent en moyenne un salaire supérieur de 56 % à celui de leurs pairs ne maîtrisant pas ces compétences

L’IA s’impose aujourd’hui comme un levier stratégique de croissance. Dans les secteurs les plus exposés à l’IA – comme les services financiers ou l’édition de logiciels – la productivité a presque quadruplé entre 2018 et 2024, passant de 7 % à 27 %. À l’inverse, les secteurs moins exposés, comme l’hôtellerie ou l’extraction minière, ont stagné autour de 9 %. 

Comme dit plus haut, pour PwC, l'emploi se transforme : L’IA ne fait pas disparaître les emplois : elle les transforme et les fait évoluer. Même dans les professions les plus exposées à l’automatisation, le nombre d’emplois continue de croître. En France, les métiers « augmentés » par l’IA ont progressé de 252 % entre 2019 et 2024, et de 223 % pour les métiers « automatisés ». Cette tendance est plus marquée qu’au Royaume-Uni (39 % et 32 %) ou aux États-Unis (9 % et -3 %).

La France affiche également une forte maturité dans l’adoption de l’IA générative : les offres d’emploi dans les métiers exposés à la GenAI ont augmenté de 274 % entre 2019 et 2024, contre 248 % pour les métiers moins exposés. L’Allemagne suit une trajectoire similaire avec une croissance de 64 % pour les métiers exposés, contre 27 % pour les moins exposés. Ce contraste est d’autant plus notable qu’à l’échelle mondiale, ce sont principalement les métiers moins exposés à l’IA qui ont progressé en volume (+66 % contre +38 % pour les métiers les plus exposés).