intelligence artificielle

Amadeus for Developers met à disposition des API basées sur l'intelligence artificielle

Soumis par fredericmazue le

Amadeus lance un nouvel ensemble d’API basé sur de l’IA dans le cadre du programme Amadeus for Developers. Ces API permettront aux développeurs de bâtir des solutions en mesure d’anticiper différentes variables comme par exemple les intentions de voyage, le comportement des voyageurs et les retards des vols. Aucune formation préalable en IA ou en données n’est requise

Amadeus fournit des modèles de prédiction prêts à être mis en œuvre, fondés sur des informations et des fonctionnalités transmises par les importantes sources de données d'Amadeus.

Les API d'IA d'Amadeus sont basés sur un modèle collaboratif. Amadeus a lancé son programme Amadeus for Developers en novembre 2018 pour stimuler la collaboration au sein de la communauté des développeurs.

Les API d'IA sont accessibles à n'importe quel développeur sur Amadeus for Developers, avec de la documentation, des échantillons de codes et des guide. Amadeus continuera à déployer de nouvelles API d'IA à l'avenir et la phase initiale comprend les API suivantes :

API Flight Choice Prediction : Cette API utilise des modèles d'apprentissage automatique prédictifs pour analyser les résultats de recherche des vols et attribuer à chaque vol une probabilité d'être choisi par l'utilisateur
API Trip Purpose : Comprendre l'intention du voyageur, et s'il voyage pour affaires ou loisirs, est la première étape pour créer une expérience véritablement personnalisée
API Flight Delay Prediction : Être en mesure de prédire la probabilité des retards en avance aide les voyageurs à gérer leur expérience, en réduisant le stress de voler d'un point A à un point B
API Airport On-Time Performance : La ponctualité est l'une des mesures les plus importantes pour les aéroports et elle aide les voyageurs. Cette API utilise un modèle d'apprentissage automatique basé sur les données historiques d'Amadeus pour estimer un pourcentage de départs ponctuels des vols pour un aéroport et une date impartis
API AI-Generated Photos : Cette API résout la question de l'approvisionnement des photos en permettant aux entreprises de voyages d'accéder à des images inspirantes générées par l'IA libres de droits

Pour plus d'informations, consultez developers.amadeus.com

L'intelligence artificielle doit elle bénéficier de protection éthique au même titre que les animaux ?

Soumis par fredericmazue le

Voilà une question surprenante... Mais très sérieusement posée par John Basl professeur adjoint de philosophie à la Northeastern University de Boston, et Eric Schwitzgebel,  professeur de philosophie à l’Université de Californie dans un billet publié sur Aeon. En voici quelques extraits.

Les universités du monde entier mènent des recherches majeures sur l'intelligence artificielle (IA), tout comme des organisations telles que l'Institut Allen et des sociétés de haute technologie telles que Google et Facebook. Un résultat probable est que nous aurons bientôt une intelligence artificielle à peu près aussi sophistiquée sur le plan cognitif que des souris ou des chiens. Le moment est venu de se demander si, et dans quelles conditions, ces IA mériteraient les protections éthiques que nous accordons généralement aux animaux argumente le billet qui continue ainsi Jusqu'ici, les discussions sur les «droits de l'IA» ou «droits des robots» ont été dominées par des questions sur les obligations éthiques que nous aurions envers une IA d'intelligence humaine ou supérieure - telle que l'androïde Data de Star Trek ou Dolores de Westworld. Mais penser ainsi, c'est commencer au mauvais endroit et cela pourrait avoir de graves conséquences morales. Avant de créer une intelligence artificielle avec une sophistication humaine méritant une considération éthique humaine, nous allons très probablement créer une intelligence artificielle avec une sophistication moins qu'humaine, méritant une considération éthique moins qu'humaine.

[...] Vous pensez peut-être que les personnes atteintes d'IA ne méritent pas ce type de protection éthique à moins d'être conscientes, c'est-à-dire si elles n'ont pas un véritable flux d'expérience, avec une joie et une souffrance réelles. Nous sommes d'accord. Mais nous sommes maintenant confrontés à une question philosophique délicate: comment saurons-nous que nous avons créé quelque chose capable de joie et de souffrance? Si l'IA est comme Data ou Dolores, elle peut se plaindre et se défendre, en initiant une discussion sur ses droits. Mais si l'IA est inarticulée, comme une souris ou un chien, ou si, pour une raison quelconque, ele est incapable de nous communiquer sa vie intérieure, elle n'aura peut-être aucun moyen de signaler qu'elle souffre.

[...] Nous proposons la création de comités de surveillance qui évaluent la recherche de pointe sur l'IA en tenant compte de ces questions. 

En attendant la création de ces comités et le résultats de leurs recherches, n'insultez pas, ne maltraitez pas votre assistant vocal ou votre robot domestique. On pourrait vous le reprocher un jour :-)

« L'intelligence artificielle vulgarisée » par Aurélien Vannieuwenhuyze

Soumis par fredericmazue le
Image

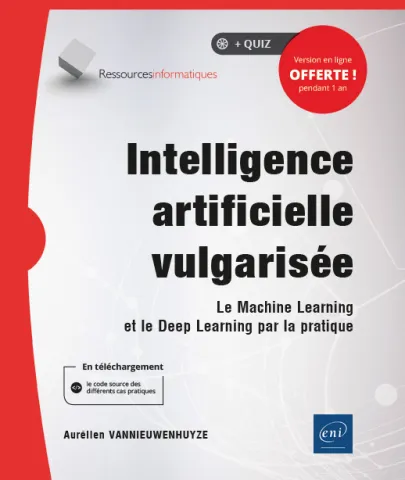
Les Editions ENI annoncent la publication de son dernier opus sur l’intelligence artificielle. Elle fait rêver certains, inquiète les autres, qu’importe, elle ne laisse personne indifférent. Nombreux pensent que l’intelligence artificielle fait partie de l’avenir de l’humanité. Avec cet ouvrage, les Editions ENI souhaitent donner les clés aux lecteurs pour comprendre et mettre en pratique des projets basés sur l’intelligence artificielle.

La technologie incontournable dans tous les domaines

Aussi bien dans des applications ludiques telles que des robots, des drones, que dans l’environnement ou le médical, l’Intelligence Artificielle pose des questions essentielles d’éthique et de sécurité. L’auteur présente de façon vulgarisée, les concepts du Machine Learning et Deep Learning pour les mettre en application sur des projets basés sur l’intelligence artificielle.

Au travers de nombreux cas pratiques, Aurélien Vannieuwenhuyze rappelle les fondamentaux pour créer de l’intelligence artificielle : les notions statistiques pour mieux appréhender les algorithmes du Machine Learning, les bases du langage Python ainsi que l’étude de l’apprentissage non supervisé et l’usage des réseaux de neurones. Il aborde de façon simple et précise comment les neurosciences ont eu un impact sur l’intelligence artificielle.

«  J'ai voulu écrire un ouvrage qui s'adresse aux développeurs souhaitant s'initier à l'intelligence artificielle et à sa mise en place dans leurs applications. L'objectif étant de vulgariser la compréhension du machine learning et du Deep Learning là où la littérature reste encore très spécialisée pour les initiés au domaine des mathématiques et peut-être moins aux informaticiens. » commente Aurélien Vannieuwenhuyze

L’intelligence Artificielle Vulgarisée
Aurélien Vannieuwenhuyze
Disponible sur www.editions-eni.fr, en format imprimé, numérique, et sur abonnement ainsi qu’en librairie

Microsoft France crée un tutoriel IA à destination du jeune public avec le collectif Class’Code

Soumis par fredericmazue le

A l’occasion de Microsoft Envision The Tour, Microsoft, qui affiche son ambition de rendre le numérique accessible à tous, annonce une nouvelle initiative.

Ainsi, en association avec le collectif Class’Code, Microsoft annonce la création d’un tutoriel de sensibilisation à l’intelligence artificielle destiné aux enfants de primaire et collège. Conçu notamment avec le concours de Magic Makers, start-up française spécialisée dans l’apprentissage de la programmation assurant la direction pédagogique de Class’Code, ce module d’apprentissage gratuit a vocation à promouvoir l’IA auprès des plus jeunes. Destiné en particulier à la communauté éducative et aux professionnels de l’animation, il sera disponible à partir de mars 2020 sur classcode.fr.

Data Science et IA : 7 500 créations nettes d’emploi dans la Branche d’ici 5 ans

Soumis par fredericmazue le
Image
Image
Image
Image
Image
Image
Image
Image
Image
Image
Image

Si le potentiel de développement économique de l’Intelligence Artificielle (IA) est avéré et considérable, ses conséquences sur l’emploi suscitent toujours de nombreuses interrogations : quels seront les impacts à terme du développement de l’IA sur l’emploi, notamment dans la branche du numérique ? Quelles sont les nouvelles compétences recherchées ? Quelles sont les évolutions des métiers et les besoins en formation ? … Autant de questions auxquelles la nouvelle étude « Formations et compétences sur l’Intelligence Artificielle en France », commanditée par Syntec Numérique et réalisée par l’OPIIEC, apporte des éléments de réponse. En effet, cette analyse dresse un état des lieux des besoins en recrutements, des compétences recherchées mais aussi de l’offre de formation disponible en France. L’objectif : anticiper l’ensemble des ressources nécessaires (emplois, compétences, formations) au développement de l’IA dans la proposition de valeur des professionnels du secteur.

Vers une incertaine mais inévitable évolution des métiers…

La plupart des travaux actuels autour de l’IA correspondent à une phase d’investissement en recherche & développement et peu d’applications sont entrées dans une phase d’industrialisation. En effet, l’IA apparaît aujourd’hui dans une multitude de cas d’usages dont les avancements sont divers (voicebots et chatbots, deep et machine learning, robotique…etc). Ce contexte influe sur la demande de ompétences actuelles et futures à l’échelle française et mondiale. La transformation par l’IA ne se mesure donc pas seulement par une « règle économique impactant l’emploi », mais plus par une modification des contenus métiers.

Les grandes tendances de l’emploi en IA dans la Branche du numérique au travers de 10 métiers

  • Pour les profils de spécialistes de l’IA, des évolutions rapides sont à prévoir dans les technologies de modélisation informatique des algorithmes (bibliothèques existantes, Cloud Computing, applicatifs intégrant l’IA etc.). Cela pourrait diffuser et rendre plus rapide l’accès à certaines technologies IA pour des profils plus variés, y compris des personnes qui ne sont pas actuellement spécialistes de l’IA.
  • Des compétences aujourd’hui en forte tension (ex : Deep Learning, notamment pour la Vision artificielle et le Traitement du Langage Naturel) pourraient devenir plus accessibles pour des spécialistes intégrateurs généralistes de l’IA, élargissant l’accès à ces spécialités pour d’autres profils.

En conséquence, la branche pourrait rechercher environ 7 500 spécialistes supplémentaires de l’IA & Data Science sur la période 2019-2023, pour une population totale portée de 11 200 à 21 000 personnes (+59%).

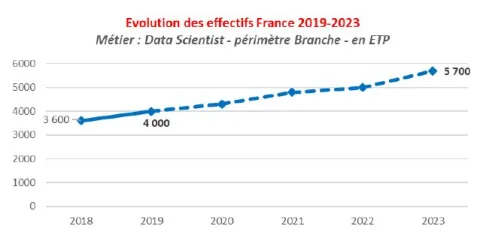
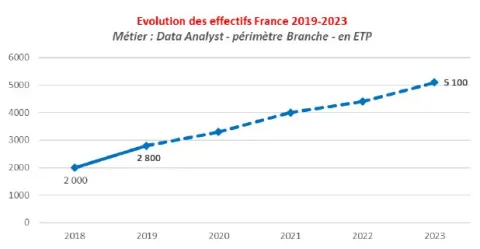
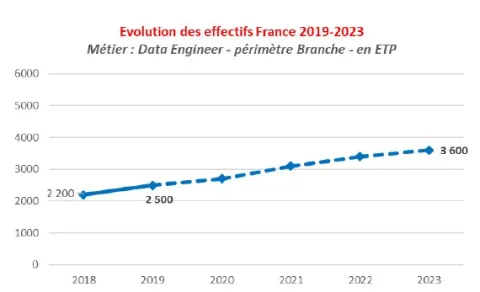
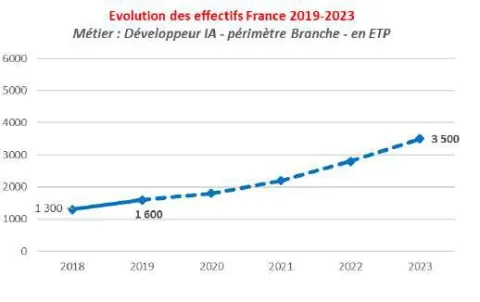
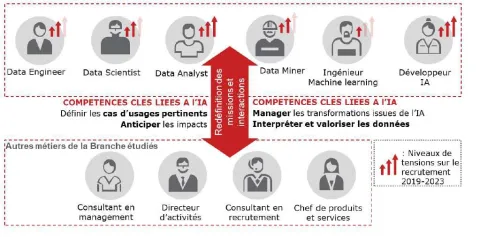
  • Le phénomène ne sera pas homogène pour tous les métiers : hausse constante des Data Scientists, Ingénieurs Machines Learning et Data Analysts, encore davantage pour les Data Engineers et Développeurs IA, stabilisation des Data Miners, intégration progressive des spécialités « Vision artificielle » et « Traitement du Langage Naturel » dans le métier d’Ingénieur Machine Learning.
  • Cette période de croissance des effectifs spécialistes de l’IA pourrait avoir, dans un deuxième temps, un impact sur la demande de compétences d’autres métiers… Sur un échantillon de 4 métiers non-spécialistes retenus pour cette étude (Consultant en management, Consultant en Recrutement, Chef de produit et Directeur de business unit), la modification des contenus métiers, des organisations et des besoins en emplois irait jusqu’à contracter les besoins en recrutement de la Branche d’environ 12 000 personnes sur la période 2023-2025 (uniquement une baisse des recrutements, sans contraction des effectifs présents a priori).

Un marché de l’emploi en très forte tension…

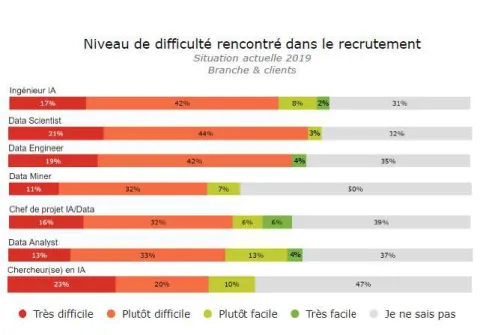
Les principaux profils de spécialistes en IA connaissent des tensions élevées, voire très élevées sur le recrutement. Cette tension sur l’offre et la demande d’emploi pour les spécialistes de l’IA est accentuée par une forte variabilité dans les contenus métiers attendus : notamment, très peu d’offres d’emploi actuelles de Data Scientists, Data Engineers, Ingénieur Machine Learning etc. présentent des contenus homogènes.

Des offres d’emploi qui traduisent un manque de connaissance fine des besoins et des compétences recherchées

Les offres demeurent concentrées sur les technologies maîtrisées, notamment les plus transférables d’un secteur à l’autre (Machine Learning, Deep Learning, Vision Artificielle, Traitement du Langage Naturel).

Plus généralement, les niveaux de demandes sur l’expérience et le niveau de diplôme (dans une moindre mesure) semblent parfois éloignés d’une compréhension fine du contenu des compétences demandées et des besoins de formations ou d’expérience souhaitables.

Une demande complémentaire et relativement équilibrée entre les acteurs de la Branche et les clients

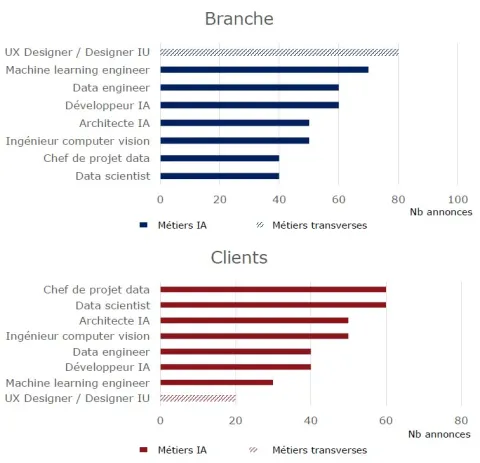
Les offres d’emplois IA proviennent à 54% d’acteurs de la Branche et à 46% de clients. Les offres d’emplois transverses proviennent, elles, majoritairement d’acteurs de la Branche (85%)

Les recruteurs sont souvent demandeurs d’une double compétence pour les profils de Data scientists et Chefs de projet data. Les profils de Data analyst / data miner sont quant à eux particulièrement recherchés dans les fonctions marketing / CRM.

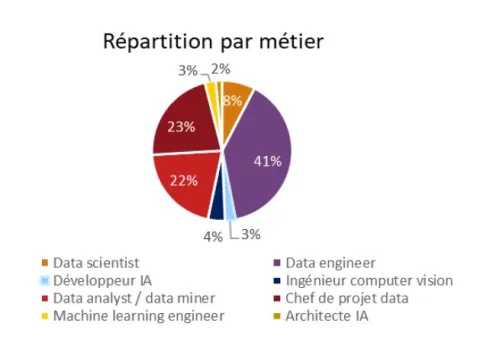
Les profils de Data engineer sont les plus recherchés (41% des offres), suivis par les Chefs de projet data (23%) et les Data analysts/data miners (22%).

Formation : une offre dynamique mais qui reste encore trop insuffisante …

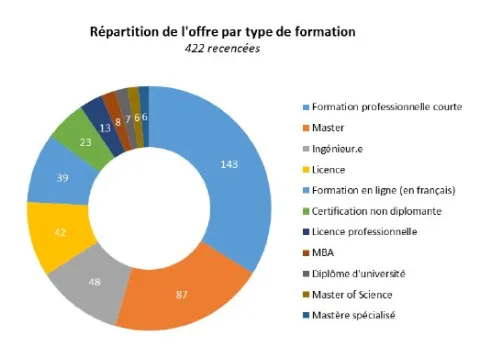
Le tissu de formation initiale, relativement bien réparti sur le territoire national, présente une capacité annuelle à diplômer 4 000 personnes au niveau « master/ingénieur », contre 2 000 personnes au niveau licence.

Même si toutes ces formations ne sont pas remplies, cette capacité est insuffisante pour répondre à tous les besoins : la Branche ayant a elle seule besoin d’une moyenne de 2500 jeunes diplômés / an sur 5 ans. Sur ce point, l’objectif du gouvernement français est de rapidement doubler cette capacité et renforcer l’attractivité des parcours.

Evolution des métiers de l’IA à horizon 2023

Au sein de la Branche, les Data Scientists devraient rester les plus nombreux sur la période 2019-2023 (cela pourrait s’inverser par la suite au profit du développement et de l’analyse). Un mouvement important de mobilités vers ce métier pourrait nuancer les tensions actuelles sur le recrutement.

La population de Data Analysts devrait fortement s’accroître sous l’effet mécanique des besoins volumétriques d’exploitation de données, de la transformation de certains métiers (ex chargés d’études statistiques) et de l’accentuation de la dimension prédictive, voire prescriptive dans certains domaines matures (ex marketing, recommandations).

Le besoin de Data Engineers devrait s’accroître sur la période et audelà, avec un rôle de plus en plus stratégique au sein d’entreprises orientées par les Data. Il s’agit d’un profil plus accessible via des mobilités professionnelles à ce jour (ex Data Scientists). Leur recrutement externe est sous forte tension (attractivité faible du métier pour les jeunes diplômés).

Malgré une population plus faible, le Data Mining devrait demeurer un besoin constant de la Branche en tenant compte de l’impact croisé du développement de compétences IA au sein de profils Data Science (ex Data Analysts)

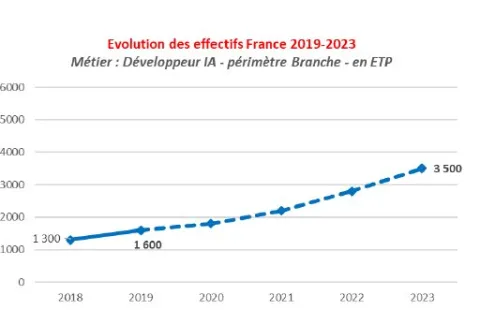
Le besoin de développeurs devrait encore s’accélérer à partir de 2021, notamment du fait de la simplification d’accès à l’IA, de la démocratisation d’applicatifs. A ce jour, l’attractivité du métier reste faible et les tensions sur le recrutement fortes.

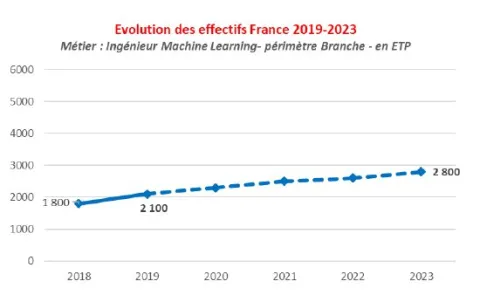
Les populations d’Ingénieurs Machine Learning devraient croître à un rythme constant, avec un élargissement plus systématique à des technologies matures (notamment Vision Artificielle et Traitement du Langage Naturel, aujourd’hui souvent spécialisées)

Du point de vue des Ressources Humaines, la transformation de la branche numérique par l’IA s’envisage donc de manière systémique :

  • Besoin d’attractivité en matière de recrutement, pour des métiers qui accusent encore un déficit sur ce point (davantage pour l’IA que la Data Science et notamment auprès des femmes).
  •  
  • Besoin de fidélisation de profils expérimentés capables de maîtriser un domaine d’applications et d’accompagner des transformations organisationnelles, voire culturelles d’entreprises.
  • Besoin d’accompagnement de mobilités pour les professionnels en poste qui feront évoluer leur parcours professionnel dans ce nouveau paysage.
  • Besoin d’adaptation du tissu de formation là où cela s’avère pertinent. Sur ce dernier point, l’enjeu se situe plus sur la multiplication rapide de compétences disponibles que sur l’augmentation du niveau d’expertise des personnes formées, déjà élevé.
  • Ces questions de besoins en RH sous-tendent par ailleurs une nécessaire réflexion sur les zones de valeurs identifiées au cours de cette étude (stratégie IA, Data Science et valorisation des données, capacité d’accompagnement des transformations technologique et organisationnelles) et sur le positionnement stratégique de tous les acteurs de la Branche.
Une main robotique manipule et résout un Rubik's Cube

Soumis par fredericmazue le

C'est le résultat de travaux de chercheurs d'OpenAI, une entreprise à "but lucratif plafonné" depuis mars 2019, basée à San Francisco. Avant mars 2019, OpenAI état une association à but non lucratif. L'objectif d'OpenAI est de promouvoir et développer une intelligence artificielle à visage humain qui bénéficiera à toute l'humanité.

Non seulement la main robotique résout le Rubik's Cube (d'une seule main s'il vous plaît ! :-) mais elle peut gérer des éléments perturbateurs comme le montre la seconde vidéo ci-dessous. Les perturbations pouvant être un gant gênant la main, deux doigts de la main liés l'un avec l'autre, un élément perturbateur extérieur qui vient ponctuellement gêner le travail, etc.  

Les chercheurs expliquent : Nous avons formé deux réseaux de neurones pour résoudre le Rubik's Cube avec une main robotique. Les réseaux de neurones sont entièrement formés à la simulation, en utilisant le même code d’apprentissage par renforcement que OpenAI Five, associé à une nouvelle technique appelée Automatic Domain Randomization (ADR). Le système peut gérer des situations qu’il n’a jamais vues pendant l’entraînement, par exemple être gêné par une girafe en peluche. Cela montre que l'apprentissage par renforcement n'est pas simplement un outil pour les tâches virtuelles, mais peut résoudre des problèmes du monde physique nécessitant une dextérité sans précédent.

Site : openai.com

[video:https://www.youtube.com/watch?v=kVmp0uGtShk autoplay:0]

[video:https://www.youtube.com/watch?v=QyJGXc9WeNo autoplay:0]

« IA Encyclopedie », une encyclopédie entièrement consacrée a l'intelligence artificielle

Soumis par fredericmazue le

Centre de formation en Intelligence Artificielle à destination des managers, l'IA Académie annonce aujourd'hui le lancement de « l'IA encyclopédie », encyclopédie de 40 rubriques regroupant l'ensemble des domaines de l'Intelligence Artificielle, de la théorie aux applications concrètes. Accessible aux entreprises et aux particuliers, l'IA Encyclopédie s'adresse principalement à des non techniciens, managers, décideurs (ou tout non spécialiste de l'IA impliqué dans un projet IA) souhaitant monter en compétence sur les sujets IA.
 
Rendre l'intelligence artificielle accessible au plus grand nombre

« Aucun bagage technique n'est nécessaire pour appréhender chaque rubrique de l'IA Encyclopédie. Les non spécialistes de l'IA qui seront amenés à l'utiliser, pourront ainsi mieux communiquer entre eux, mieux fédérer des équipes techniques et mettre en œuvre les meilleures solutions. Les particuliers, quant à eux, pourront se familiariser avec les grands principes de l'Intelligence Artificielle, sa puissance, sa progression et ses répercussions sociétales. », souligne Dominique Monera, fondateur de l'IA ACADEMIE.
 
L'IA Encyclopédie comprend des rubriques théoriques afin de les apprenants puissent se familiariser avec les composantes de l'IA, les fondamentaux du Machine Learning, des algorithmes, du Big data et du deep learning. L'encyclopédie comprend également des rubriques pratiques regroupant les principales applications de l'IA dans les secteurs d'activités et les métiers de l'entreprise. Les questions de prospectives relatives aux évolutions sectorielles, sociétales et managériales y sont également traitées. Chacune des 40 rubriques comprendra un cours illustré ainsi qu'un QCM et des exercices corrigés pour les rubriques les plus techniques.
 
L'accès à l'IA Encyclopédie coûte annuellement 70€ HT par utilisateur pour les entreprises et 84€ pour les particuliers pour un engagement d'un an. Les entreprises peuvent y souscrire en signant un contrat avec l'IA Académie, précisant le nombre de salariés adhérents qui pourront ainsi consulter l'IA Encyclopédie en ligne. Le tarif sera dégressif en fonction du nombre d'adhérents.
 
Site web : www.iaacademie.fr

HERE dévoile Live Sense SDK, basé sur l'IA, pour prévenir les conducteurs des dangers sur leur parcours

Soumis par fredericmazue le

HERE Technologies a dévoilé HERE Live Sense SDK, un nouveau kit de développement logiciel (SDK) permettant de partager des informations en temps réel à propos de l’environnement de conduite. Actuellement en beta, HERE Live Sense SDK est conçu pour aider les conducteurs à prendre des décisions éclairées concernant d’éventuels obstacles sur leur parcours, l'infrastructure routière ou les conditions de conduite, et ce sans traitement de données dans le cloud et donc sans connectivité.

S’appuyant sur la puissance de l'intelligence artificielle (IA) et de l'apprentissage automatique (machine learning), HERE Live Sense SDK transforme les appareils équipés de caméras frontales comme les smartphones, les dashcams ou les caméras embarquées, en capteurs intelligents. En scannant continuellement l’environnement du conducteur, les appareils peuvent ensuite détecter des objets sur la route, tels que d'autres véhicules, des piétons ou des cyclistes, analyser l’infrastructure routière comme des feux de circulation et des panneaux de signalisation, et repérer des dangers potentiels comme des nids-de-poule, des voies neutralisées ou des zones de construction.

En fonction des éléments détectés, HERE Live Sense SDK envoie des notifications audio et visuelles pour aider le conducteur à prendre une décision éclairée. Ces actions s’effectuent en temps réel sur l'appareil lui-même, sans qu'il soit nécessaire de traiter les données dans le cloud ou d'assurer une connectivité. HERE Live Sense SDK est également capable de détecter en temps réel des différences entre l’environnement réel et la carte embarquée, pour informer par exemple d’un changement de limitation de vitesse.

« La sécurité des conducteurs est au cœur de tous nos projets. Aujourd'hui, il y a encore en circulation des millions de véhicules qui ne disposent pas de technologie permettant de prévenir leurs conducteurs de dangers potentiels. HERE Live Sense SDK propose d’apporter une réponse à ce problème », déclare Angel Mendez, Chief Operating Officer chez HERE Technologies. « Cette technologie détecte les objets, les changements de comportement et les conditions de circulation qui peuvent représenter un danger et avertit les conducteurs à temps pour agir. »

HERE Live Sense SDK s’appuie sur plusieurs modèles de détection basés sur l’IA et le machine learning, incluant :

Road Basics : Détection et classification des objets sur la route.

Road Alerts : Reconnaissance et notification des véhicules en freinage, des piétons et des vélos.

Road Hazards : Détection et classification des risques inopinés sur le parcours, y compris les fermetures de routes non encore affichées sur la carte, les zones de construction et les travaux.

Road Signs : Détection et classification des panneaux de limitations de vitesse, entre autres.

Faisant partie d’un SDK, ces modèles de détection peuvent être intégrés à des applications et à du matériel hardware. Créé pour le bénéfice de tous les conducteurs, HERE Live Sense SDK est disponible pour les constructeurs automobiles, les gestionnaires de flottes et de VTC, et les développeurs d'applications. Il est actuellement disponible en version beta pour Android et sera bientôt disponible pour iOS. HERE travaille d’ores et déjà avec des clients sur les premières implémentations commerciales du SDK.

Pour plus d'informations, rendez-vous sur le HERE Developer Portal : developer.here.com/products/live-sense-sdk

14 API d'intelligence artificielle

Soumis par fredericmazue le

Si vous cherchez à intégrer de l'intelligence artificielle dans votre application, vous vous posez peut-être la question de savoir avec quelle API travailler. Un intéressant article sur ProgrammableWeb présente 14 API pour vous aider à faire un choix.

En lisant l'article vous apprendrez par exemple que l'API Alexa permet d'effectuer des tâches de gestion des compétences, ou Skill. (Pour en apprendre plus sur Alexa, vous êtes chaleureusement invités à participer à notre prochaine DevCon Programmez! :-)

Vous apprendrez que l'API SummarizeBot fournit des solutions d'intelligence artificielle et de chaîne de blocs pour l'analyse de texte et multimédia, ou encore que l'API L' API Qloo AI Track Cette API détecte les tendances dans les préférences de l'utilisateur et personnalise les éléments associés dans une base de données sur la culture et le divertissement.

Chaque API a ses spécificités et spécialisation, d'où l'intérêt de l'article de ProgrammableWeb.

Sortie de TensorFlow 2.0

Soumis par fredericmazue le

TensorFlow est un outil de machine learning et de deep learning. Il expose une API en Python. Google l'utilise en interne, notamment pour Inception v3, son architecture de reconnaissance d'image.

Google a ouvert le code de TensorFlow en 2015. Moutain View a annoncé lundi la sortie de TensorFlow 2.0 en version finale.

Cette mouture met l'accent sur la simplicité et la facilité d'utilisation, selon les termes de Google. La construction de modèles avec Keras est présentée comme étant facile, et l'exécution rapide. C'est toujours selon Google, le plus gros point fort de cette version 2.0. Google souligne aussi avoir simplifié l'API en réduisant la duplication et en supprimant les terminaux obsolètes.

TensorFlow 2.0 fournit Keras en tant qu'API de haut niveau centrale utilisée pour créer et former des modèles. Keras fournit plusieurs API de création de modèle, telles que Séquentielle, Fonctionnelle et Sous-classification, ainsi qu'une exécution rapide, pour une itération immédiate, un débogage intuitif, et la construction de pipelines d'entrée évolutifs. Google renvoie à cette documentation pour plus de détails.

En revanche Google a effectué de nombreuses modifications d'API qui entraînent des incompatibilités avec les versions antérieures. En outre TensorFlow 2.0.0 est construit à l'aide de devtoolset7 (GCC7) sur Ubuntu 16. Cela peut entraîner des incompatibilités ABI avec des extensions construites à l'aide de versions antérieures de TensorFlow.

TensorFlow c'est aussi une notable amélioration de performances, grâce à une meilleure utilisation des GPU. TensorFlow 2.0 offre des performances d’entraînement jusqu’à trois fois plus rapides en utilisant une précision mixte sur les GPU Volta et Turing avec quelques lignes de code. TensorFlow 2.0 est étroitement intégré à TensorRT et utilise une API améliorée pour offrir une meilleure convivialité et de hautes performances lors de l’inférence sur les GPU NVIDIA T4 Cloud sur Google Cloud.

Kari Briski, directeur principal de la gestion des produits de logiciel d'informatique accélérée chez NVIDIA a commenté ainsi la sortie de TensorFlow 2.0  : "L'apprentissage automatique sur les GPU et les systèmes NVIDIA permet aux développeurs de résoudre des problèmes qui semblaient impossibles il y a quelques années. TensorFlow 2.0 est doté de nombreuses fonctionnalités d’accélération GPU exceptionnelles et nous avons hâte de voir les étonnantes applications d’IA que la communauté créera avec ces outils mis à jour."

[video:https://www.youtube.com/watch?&v=EqWsPO8DVXk autoplay:0]