machine learning

AWS DeepRacer : se familiariser au machine learning grâce à un simulateur de course 3D

Soumis par fredericmazue le

AWS propose un nouveau service, AWS DeepRacer, qui permet aux développeurs de tout niveau de compétences de se familiariser avec le machine learning grâce à un simulateur de course 3D dans le cloud. La voiture de course est entièrement autonome et gérée par l’apprentissage par renforcement.

L'apprentissage par renforcement est une technique avancée de machine learning (ML) qui adopte une approche très différente des autres méthodes de machine learning pour les modèles de formation. Sa caractéristique est qu'il apprend des comportements très complexes sans avoir besoin de données de formation étiquetées, et qu'il peut prendre des décisions à court terme tout en optimisant pour un objectif à long terme.

AWS propose des courses mensuelles sur un circuit virtuel : AWS DeepRacer League. AWS DeepRacer League vous donne l'occasion de concourir pour des prix et de rencontrer d'autres passionnés de machine learning, en ligne et en personne. 

Site : aws.amazon.com/fr/deepracer

Alibaba Cloud rend disponible sa plateforme de machine learning algorithmique sur Github

Soumis par fredericmazue le

Alibaba Cloud annonce  que les principaux codes de sa plateforme algorithmique, Alink, ont été rendus disponibles en open source sur Github. La plateforme dispose d’une large gamme de bibliothèques d’algorithmes qui prennent en charge le traitement par lots et le traitement par flux, qui sont essentiel pour les tâches de machine learning comme la recommandation de produits en ligne et les services clients intelligents. 

Les data analystes et les développeurs de logiciels peuvent accéder aux codes sur Github pour construire leur propre logiciel, facilitant ainsi des tâches telles que l’analyse statistique, le machine learning, la prédiction en temps réel, la recommandation personnalisée et la détection d’anomalies.

« En tant que plateforme composée de divers algorithmes combinant l’apprentissage dans différents modèles de traitement de données, Alink peut être une option intéressante pour les développeurs à la recherche d’outils robustes pour le big data et le machine learning », a déclaré Yangqing Jia, President and Senior Fellow of Data Platform chez Alibaba Cloud Intelligence. « En tant que l’un des dix premiers contributeurs de Github, nous nous engageons à nous connecter avec la communauté open source le plus tôt possible dans nos cycles de développement logiciel. Partager Alink sur Github souligne notre engagement de longue date dans le domaine. »

Alink a été développé sur la base de Flink, un moteur de calcul unifié distribué. Basé sur Flink, Alink permet une unification transparente du traitement par lots et par flux, apportant aux développeurs une plateforme plus efficace pour effectuer des analyses de données et des tâches machine learning. Alink intègre non seulement les données stockées sur les systèmes d’Alibaba, mais aussi d’autres systèmes d’acquisition de données open-source, tels que Kafka, HDFS et HBase. 

Alink sur GitHub

Google Bert : Google déploie une mise à jour majeure de son algorithme de recherche

Soumis par fredericmazue le

Google commence à déployer, aux Etats-Unis et dans les pays anglophones pour commencer, une mise à jour de son algorithme de recherche. Cette mise à jour est, selon Google, le plus grand bond en avant des cinq dernières années et l'un des le plus grand saut dans l'histoire de Search. 

Ce nouvel algorithme s'appuie sur une nouvelle technologie baptisée BERT, pour Bidirectional Encoder Representations from Transformers. BERT, grâce au machine learning, est capable de comprendre les différents mots d'une recherche au sein d'une phrase plutôt que de manière isolée, ceci dans le but d'améliorer significativement la compréhension des requêtes naturelles. Les modèles BERT peuvent donc considérer le contexte complet d'un mot en regardant les mots qui le précèdent et le suivent, ce qui est particulièrement utile pour comprendre l'intention des requêtes de recherche, précise Google.

La technologie BERT semble plutôt gourmande en ressources. Google explique : Mais ce n’est pas uniquement grâce aux avancées logicielles que cela est possible: nous avions également besoin d’un nouveau matériel. Certains des modèles que nous pouvons créer avec BERT sont si complexes qu'ils repoussent les limites de ce que nous pouvons faire avec du matériel traditionnel. C'est pourquoi nous utilisons pour la première fois les derniers TPU Cloud afin de fournir des résultats de recherche et de vous fournir rapidement des informations plus pertinentes.

Les TPU, TPU pour Tensor Processing Unit, sont des puces développées par Google spécifiquement pour le machine learning. Google a construit, autour de ces puces, des supercalculateurs, les Cloud TPU Pods, et les utilise donc entre autres pour son moteur de recherche. D'après Google, ces supercalculateurs sont capables d'effecteur en quelques minutes ou quelques heures des tâches qui demandent des jours ou des semaines sur d'autres systèmes.

Google donne quelques exemples pour mettre en valeur les qualités de son nouvel algorithme. Ainsi : 2019 brazil traveler to usa need a visa. Le mot «to» et sa relation avec les autres mots de la requête sont particulièrement importants pour comprendre le sens. Il s'agit d'un Brésilien voyageant aux États-Unis, et non l'inverse. Auparavant, nos algorithmes ne comprenaient pas l'importance de cette connexion et nous avons renvoyé des résultats concernant les citoyens américains voyageant au Brésil. Avec BERT, Search est en mesure de saisir cette nuance et de savoir que le mot très courant «to» a beaucoup d'importance ici, et nous pouvons donc fournir un résultat beaucoup plus pertinent pour cette requête, souligne Google.

Sortie de TensorFlow 2.0

Soumis par fredericmazue le

TensorFlow est un outil de machine learning et de deep learning. Il expose une API en Python. Google l'utilise en interne, notamment pour Inception v3, son architecture de reconnaissance d'image.

Google a ouvert le code de TensorFlow en 2015. Moutain View a annoncé lundi la sortie de TensorFlow 2.0 en version finale.

Cette mouture met l'accent sur la simplicité et la facilité d'utilisation, selon les termes de Google. La construction de modèles avec Keras est présentée comme étant facile, et l'exécution rapide. C'est toujours selon Google, le plus gros point fort de cette version 2.0. Google souligne aussi avoir simplifié l'API en réduisant la duplication et en supprimant les terminaux obsolètes.

TensorFlow 2.0 fournit Keras en tant qu'API de haut niveau centrale utilisée pour créer et former des modèles. Keras fournit plusieurs API de création de modèle, telles que Séquentielle, Fonctionnelle et Sous-classification, ainsi qu'une exécution rapide, pour une itération immédiate, un débogage intuitif, et la construction de pipelines d'entrée évolutifs. Google renvoie à cette documentation pour plus de détails.

En revanche Google a effectué de nombreuses modifications d'API qui entraînent des incompatibilités avec les versions antérieures. En outre TensorFlow 2.0.0 est construit à l'aide de devtoolset7 (GCC7) sur Ubuntu 16. Cela peut entraîner des incompatibilités ABI avec des extensions construites à l'aide de versions antérieures de TensorFlow.

TensorFlow c'est aussi une notable amélioration de performances, grâce à une meilleure utilisation des GPU. TensorFlow 2.0 offre des performances d’entraînement jusqu’à trois fois plus rapides en utilisant une précision mixte sur les GPU Volta et Turing avec quelques lignes de code. TensorFlow 2.0 est étroitement intégré à TensorRT et utilise une API améliorée pour offrir une meilleure convivialité et de hautes performances lors de l’inférence sur les GPU NVIDIA T4 Cloud sur Google Cloud.

Kari Briski, directeur principal de la gestion des produits de logiciel d'informatique accélérée chez NVIDIA a commenté ainsi la sortie de TensorFlow 2.0  : "L'apprentissage automatique sur les GPU et les systèmes NVIDIA permet aux développeurs de résoudre des problèmes qui semblaient impossibles il y a quelques années. TensorFlow 2.0 est doté de nombreuses fonctionnalités d’accélération GPU exceptionnelles et nous avons hâte de voir les étonnantes applications d’IA que la communauté créera avec ces outils mis à jour."

[video:https://www.youtube.com/watch?&v=EqWsPO8DVXk autoplay:0]

Neural Structured Learning : un nouvel outil pour la plate-forme TensorFlow de Google

Soumis par fredericmazue le

Google vient d'ajouter un nouveau framework à sa plate-forme de machine learning TensorFlow : Neural Structured Learning.

Neural Structured Learning (NSL) est un framework open source pour la formation de réseaux neuronaux profonds avec des signaux structurés. Il implémente Neural Graph Learning , qui permet aux développeurs de former des réseaux de neurones à l’aide de graphes. Les graphiques peuvent provenir de multiples sources, telles que des graphiques de connaissances, des dossiers médicaux, des données génomiques ou des relations multimodales (par exemple, des paires image-texte). NSL se généralise également avec l’apprentissage contradictoire, où la structure entre les exemples d’entrée est construite de manière dynamique en utilisant une perturbation contradictoire.

L'apprentissage neuronal structuré (NSL) peut être appliqué à la construction de modèles précis et robustes pour la vision, la compréhension du langage et la prédiction en général.

La structure NSL de TensorFlow fournit les API et les outils suivants faciles à utiliser pour permettre aux développeurs de former des modèles avec des signaux structurés :

  • API Keras pour permettre une formation avec des graphes (structure explicite) et des perturbations contradictoires (structure implicite).
  • TF ops et fonctions pour permettre la formation avec la structure lors de l’utilisation des API TensorFlow de niveau inférieur
  • Des outils pour construire des graphiques et construire des entrées de graphique pour la formation

Site : www.tensorflow.org/neural_structured_learning

MLflow : une plateforme open source pour simplifier le cycle de vie de Machine Learning

Soumis par fredericmazue le

MLflow est une plate-forme open source pour le cycle de vie de l’apprentissage automatique. MLflow repose sur une philosophie d'interface ouverte, définissant plusieurs abstractions clés permettant d'intégrer facilement les algorithmes existants d'infrastructure et d'apprentissage automatique au système. Cela signifie que si vous êtes un développeur qui souhaite tirer parti de MLflow et que vous utilisez un framework particulier actuellement non pris en charge, ce concept interface ouverte facilite l'intégration de ce framework et l'utilisation de la plate-forme. En pratique, cela signifie que MLflow est conçu en principe pour fonctionner avec toutes les bibliothèques d’apprentissage automatique ou tous les langages de programmation.

En outre, MLflow veut faciliter la reproductibilité, ce qui signifie que le même code d'apprentissage de machine de formation ou de production est conçu pour s'exécuter avec les mêmes résultats, quels que soient les environnements, que ce soit dans le cloud, sur une machine locale ou dans un ordinateur portable. Enfin, MLflow est conçue avec une évolutivité en tête, ce qui signifie qu’elle est tout aussi utile à une petite équipe de spécialistes de l’informatique qu'à une grande organisation composée potentiellement de milliers de praticiens de l’apprentissage automatique.

MLflow propose un ensemble d’API légères pouvant être utilisées avec n’importe quelle application ou bibliothèque d’apprentissage automatique existante (TensorFlow, PyTorch, XGBoost, etc.).

MLflow est un logiciel libre sous licence Apache 2.0, disponible sur GitHub.

StyleGAN : un générateur de visages hyper-réalistes open source proposé par NVIDIA

Soumis par fredericmazue le
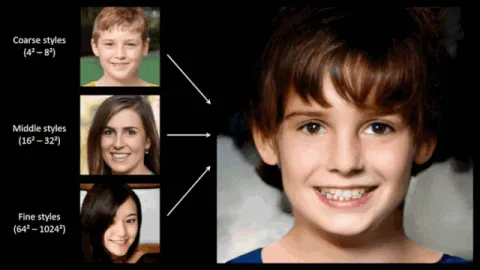
Image
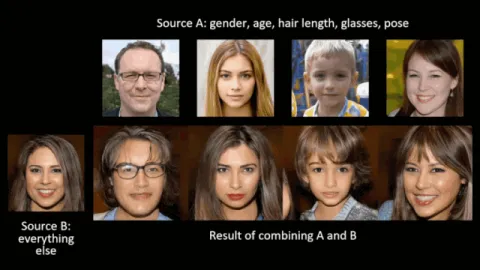
Image
Image

StyleGAN est basé sur l'outil de machine learning de Google TensorFlow. Il génère des visages à partir de vraies photos. Des visages si réalistes que l'on ne peut pas dire s'ils sont réels ou artificiels d'après NVIDIA. StyleGAN tourne sous Windows ou Linux.

Pour générer des visages, les développeurs peuvent utiliser leur propre modèle ou le modèle pré-entraîné. Les modèles pré-formés sont stockés en tant que fichiers pickle (.pkl) dans Google Drive. 

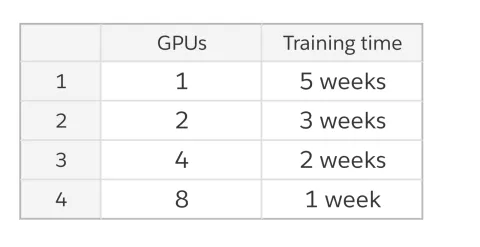
StyleGAN demande une puissance de calcul très importante et selon NVIDIA le temps de formation pour des images de résolution 1024x1024 à l'aide du GPU Tesla V100 est le suivant :

GPUs Temps
1 1 5 semaines
2 2 3 semaines
3 4 2 semaines
4 8 1 semaine

Hormis le temps requis, NIDIA souligne que le nombre de GPU est très important pour obtenir des résultats réalistes et recommande l'utilisation de 8 GPUs.

StyleGAN est un logiciel libre sous licence NVIDIA  Creative Commons BY-NC 4.0, disponible sur GitHub.

Ubisoft s'associe à Mozilla pour développer Clever-Commit, un assistant de programmation basé sur l'intelligence artificielle

Soumis par fredericmazue le

Ubisoft collaborera avec Mozilla au développement et à la mise en œuvre de l'assistant de programmation Clever-Commit. Clever-Commit est une technologie d'intelligence artificielle développée par le Groupe Technologique d'Ubisoft qui, en apprenant des bogues et correctifs passés, a pour but d'aider les programmeurs à évaluer si un changement de code entraînera un nouveau bogue.

Clever-Commit a été présenté l'an dernier en tant que prototype du nom de Commit-Assistant par le laboratoire de recherche d'Ubisoft Montréal, Ubisoft La Forge, en collaboration avec l'Université Concordia. Tout d'abord testé avec des données amassées lors du développement de jeux vidéo, le prototype a ensuite été transféré au Groupe Technologique d'Ubisoft, qui avait pour mission de le développer, de l'adapter et de le déployer partout dans le monde.

Mozilla va notamment utiliser Clever-Commit dans le développement de Firefox. « La correction de bogues est un processus nécessitant beaucoup de temps et de ressources. Encore plus quand on parle de grandes quantités de code, par exemple pour les navigateurs et les jeux AAA. En intégrant Clever-Commit au flux de développement, nous améliorerons le processus de programmation de Firefox en repérant les tendances en matière de bogues et en identifiant plus tôt les correctifs antérieurs, à une étape où corriger un bogue coûte beaucoup moins cher qu'après la parution. Cela nous permettra ainsi de mettre à disposition un plus grand nombre de versions stables de Firefox et d'offrir des expériences de navigation améliorées aux utilisateurs », explique Sylvestre Ledru, responsable de la gestion des lancements et de la qualité chez Firefox.

Microsoft annonce la disponibilité de son service Azure Machine Learning

Soumis par fredericmazue le
Image
Image

Le service Azure Machine Learning contient de nombreuses fonctionnalités avancées conçues pour simplifier et accélérer le processus de création, de formation et de déploiement de modèles d'apprentissage automatique. L'apprentissage automatique des machines permet aux scientifiques de tous les niveaux de compétences d'identifier plus rapidement les algorithmes et les hyperparamètres appropriés, souligne Microsoft qui annonce la disponibilité générale du service.

Azure Machine Learning prend en charge des frameworks open source populaires tels que PyTorch, TensorFlow et scikit-learn et permet ainsi aux scientifiques de données d'utiliser les outils de leur choix.

Microsoft indique que pour simplifier et accélérer l'apprentissage automatique, Azure Machine Learning a été construit sur les principes de conception suivants

  • Permettre aux scientifiques de données d'utiliser un ensemble riche et familier d'outils de science des données
  • Simplifier l'utilisation des structures populaires d'apprentissage par machine et d'apprentissage en profondeur
  • Accélérer le retour sur investissement en offrant des fonctionnalités de cycle de vie d'apprentissage machine de bout en bout

Les scientifiques de données s'attendent à utiliser tout l'écosystème Python,bibliothèques et frameworks, ainsi qu'avoir la possibilité de former leurs modèles localement sur leur ordinateur portable ou leur station de travail. Le service Azure Machine Learning a été conçu pour prendre en charge tous ces problèmes. Son SDK Python est accessible à partir de n’importe quel environnement Python, d’EDI comme Code Visual Studio (Code VS) ou PyCharm, ou de blocs-notes tels que Jupyter et Azure Databricks.

Les ordinateurs portables Jupyter

Ils constituent un environnement de développement populaire pour les scientifiques travaillant en Python. Le service Azure Machine Learning fournit une prise en charge des ordinateurs portables locaux et hébergés (tels qu'Azure Notebooks), ainsi que des widgets intégrés permettant aux experts en données de surveiller visuellement l'avancement des travaux de formation en temps réel, comme illustré dans l'image ci-dessous. 

Visual Studio Code 

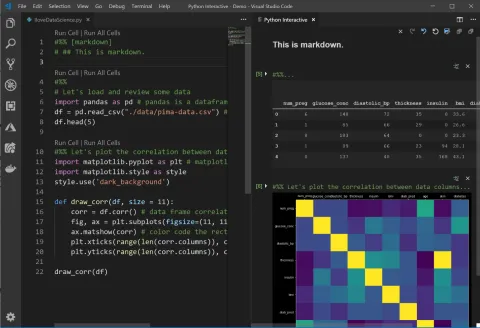
Visual Studio Code s'exécute sur votre bureau et est disponible pour Windows, macOS et Linux. L'extension Python pour Visual Studio Code combine la puissance des ordinateurs portables Jupyter avec la puissance du code Visual Studio. Cela permet d’expérimenter de manière incrémentielle dans un «style bloc-notes» tout en bénéficiant de toute la productivité que Visual Code Code offre, tels que IntelliSense, le débogueur intégré et Live Share, comme le montre l’illustration ci-dessous.

Entrainement et formation des modèles

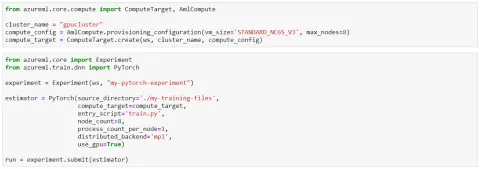
Le service Azure Machine Learning fournit des fonctionnalités de calcul distribuées transparentes qui permettent aux scientifiques de données d’étendre la formation des modèles de leur ordinateur portable ou station de travail local au cloud. Le calcul est à la demande. Les utilisateurs paient uniquement pour le temps de calcul et n'ont pas à gérer et à entretenir des grappes de GPU et de CPU.

[video:https://www.youtube.com/watch?v=SXrFNpRYNo0 autoplay:0]
Microsoft ouvre le code de son framework de machine learning Infer.NET

Soumis par fredericmazue le

Dans un billet, Microsoft l'ouverture de son framework de machine learning Infer.NET.

L'ouverture du code Infer.NET représente l'aboutissement d'un long et ambitieux voyage. Notre équipe de Microsoft Research à Cambridge, au Royaume-Uni, a entrepris de développer le framework en 2004. Nous avons beaucoup appris en cours de route pour créer des solutions d’apprentissage automatique évolutives et interprétables. Infer.NET a été initialement conçu comme un outil de recherche et nous l'avons publié à des fins académiques en 2008, explique Microsoft.

Au fil du temps, cet outil de recherche est devenu le moteur d’apprentissage automatique de nombreux produits Microsoft dans Office, Xbox et Azure. Un exemple récent est TrueSkill 2 - un système qui met en relations des joueurs de niveau équivalents pour des jeux vidéo en ligne tels que  Halo 5 et Gears of War 4. Pour ce faire, TrueSkill 2 traite des millions de données de joueurs.

Les frameworks de machine learning sont dans l'air du temps et commencent à pulluler. Microsoft tient à souligner en quoi Infer.NET se distingue de la concurrence.

Infer.NET permet une approche basée sur un modèle pour l'apprentissage automatique. Cela vous permet d'intégrer la connaissance du domaine dans votre modèle. Le framework peut alors construire un algorithme d’apprentissage machine sur mesure directement à partir de ce modèle. Cela signifie qu'au lieu de devoir mapper votre problème sur un algorithme d'apprentissage préexistant qui vous a été fourni, Infer.NET construit en réalité un algorithme d'apprentissage basé sur le modèle que vous avez fourni.

Un autre avantage de l’apprentissage automatique basé sur un modèle est l’interprétabilité. Si vous avez conçu le modèle vous-même et que l'algorithme d'apprentissage suit ce modèle, vous pouvez alors comprendre pourquoi le système se comporte de manière particulière ou fait certaines prédictions, souligne encore Microsoft.

Infer.NETest sur GitHub sous licence MIT.