MongoDB

Emergent s'appuie sur MongoDB Atlas pour accompagner le passage à la production des applications développées par l'IA

Soumis par francoistonic le

Tribune écrite par Emergent

En quatre mois, près de 2 millions d'applications ont été créées sur la plateforme Emergent, utilisée dans 180 pays, dont 50 000 ont été déployées. Pour accompagner le développement de ces applications, Emergent a choisi MongoDB Atlas, la plateforme de base de données dans le cloud de MongoDB, entreprise spécialisée dans les bases de données pour les applications modernes. Cette technologie permet aux agents d'intelligence artificielle de faire évoluer les structures de données au fil du développement et contribue à faciliter le passage des applications du prototype à la production. 

Fondée en 2025 par les frères Mukund et Madhav Jha, Emergent permet de créer des applications logicielles à partir d'instructions en langage naturel. Cette approche, appelée vibe coding, ouvre le développement logiciel à des utilisateurs qui ne disposent pas nécessairement de compétences en programmation. Elle pose néanmoins un défi technique : les applications évoluent au gré des demandes des utilisateurs, et les agents d'IA doivent pouvoir adapter leurs données sans être bloqués par des opérations complexes. 

Faire évoluer les applications sans freiner les agents d'IA

Lors des premiers tests de sa plateforme, Emergent a constaté que les agents pouvaient se retrouver bloqués dans des boucles de migration de schéma avec PostgreSQL lorsqu'ils devaient ajouter ou supprimer des colonnes pour répondre aux nouvelles demandes des utilisateurs. Ces difficultés ralentissaient le développement et compliquaient l'évolution des applications.

Après avoir testé différentes configurations sur une centaine d'applications prototypes, Emergent a retenu MongoDB Atlas. Son modèle de données documentaire, adapté notamment aux données JSON utilisées par les agents d'IA, permet de faire évoluer les structures de données sans nécessiter systématiquement des migrations de schéma complexes. 

MongoDB Atlas est désormais la base de données par défaut des applications développées sur Emergent. Chaque application déployée dispose de sa propre base de données isolée. L'infrastructure accompagne ainsi les utilisateurs depuis les premières itérations jusqu'au déploiement, tout en limitant la complexité liée à la gestion des données.

« MongoDB Atlas est la base de données la plus simple à utiliser pour un agent d'IA. Ses capacités de montée en charge sont particulièrement appréciables aujourd'hui. Près de 2 millions d'applications ont été créées sur notre plateforme et plusieurs dizaines de milliers ont été déployées. Nous n'avons pas à nous préoccuper de la montée en charge ni de la gestion de l'infrastructure, ce qui nous est très utile », déclare Mukund Jha, cofondateur et CEO d'Emergent. 

Accompagner le passage du prototype à la production

Depuis son lancement public, Emergent a permis de créer près de 2 millions d'applications en quatre mois, dont 50 000 ont été déployées dans 180 pays. Les usages couvrent des besoins variés, de la numérisation des opérations des petites entreprises à la création d'outils internes par des équipes non techniques.

Pour les entreprises, l'enjeu ne consiste pas seulement à générer rapidement une première version d'une application, mais à pouvoir la faire évoluer et la déployer dans des conditions adaptées à ses usages. Emergent propose notamment aux clients professionnels de connecter leur propre organisation MongoDB Atlas pour déployer leurs applications dans leur environnement existant.

En s'appuyant sur une infrastructure de données flexible, Emergent entend ainsi accompagner des applications qui se complexifient au fil des itérations et permettre à ses utilisateurs de dépasser le stade du prototype. Cette expérience illustre l'un des enjeux du développement logiciel piloté par l'IA : rendre la création d'applications plus accessible tout en permettant leur évolution et leur utilisation en production.

Découvrez Emergent : https://emergent.ai
Nutanix intègre MongoDB Ops Manager dans son offre database

Soumis par francoistonic le

Nutanix annonce une intégration (certifiée) de MongoDB Ops Manager dans l'offre Database Service de l'éditeur. Cette intégration doit permettre une meilleure administration et coordonation entre infrastructure et la base de données. Ops Manager de MongoDB est là pour automatiser l'administration des bases et de l'infrastructure utilisée. « L’intégration entre Nutanix Database Service et MongoDB Ops Manager offre exactement ce que les équipes de bases de données d’entreprise demandaient : une coordination transparente entre l’infrastructure et les opérations de bases de données », a déclaré Ashish Mohindroo, Senior Vice President et General Manager, Nutanix Database Service chez Nutanix. « En réunissant le provisionnement automatisé, la visibilité opérationnelle, ainsi que la sauvegarde et la reprise coordonnées, les clients peuvent réduire les frictions opérationnelles et atteindre des temps de reprise mesurés en minutes. »

Nutanix met en avant 4 capacités :

  • Le provisionnement automatisé de clusters fragmentés – Déployer des clusters MongoDB shardés prêts pour la production en quelques minutes grâce au provisionnement automatisé de l’infrastructure, à la configuration et à l’installation de l’agent Ops Manager. NDB rationalise le flux de travail depuis l’allocation de l’infrastructure jusqu’à la mise en place du monitoring.
  • La récupération à un point dans le temps (PITR) à la seconde près – Restaurer à un moment précis en récupérant à partir du dernier instantané et en appliquant les opérations jusqu’à un horodatage oplog spécifié (défini en secondes depuis l’époque UNIX).
  • La reprise rapide mesurée en minutes – Les flux de travail basés sur des instantanés de NDB Time Machine sont conçus pour accélérer les opérations de restauration et aider les équipes à atteindre des objectifs de temps de reprise (RTO) stricts pour des environnements MongoDB critiques pour l’entreprise.
  • La visibilité opérationnelle complète – MongoDB Ops Manager fournit du monitoring, des alertes et des informations opérationnelles à travers le déploiement. Combiné à l’automatisation de l’infrastructure et à la visibilité de NDB, les équipes peuvent corréler le comportement du calcul et du stockage avec les performances de la base de données.

Cette intégration est disponible dès maintenant pour clients MongoDB Enterprise Advanced dans l'offre Nutanix Database Service. 

MongoDB : importante faille de sécurité à patcher d'urgence

Soumis par francoistonic le

MongoDB prévient qu'une importante faille de sécurité impacte de nombreuses versions de sa base de données. La faille est numérotée CVE-2025-14847. 

Les versions concernées sont :

  • MongoDB 8.2.0 through 8.2.2
  • MongoDB 8.0.0 through 8.0.16
  • MongoDB 7.0.0 through 7.0.26
  • MongoDB 6.0.0 through 6.0.26
  • MongoDB 5.0.0 through 5.0.31
  • MongoDB 4.4.0 through 4.4.29
  • All MongoDB Server v4.2 versions
  • All MongoDB Server v4.0 versions
  • All MongoDB Server v3.6 versions

L'éditeur conseille de mettre à jour sans délais en version 8.2.3, 8.0.17, 7.0.28, 6.0.27, 5.0.32, ou 4.4.30.

La vulnérabilité vient de l'implémentation de zlib dans le serveur qui permet à un utilisateur non authentifié d'utiliser une mémoire heap non initialisée. Cela peut permettre d'injecter du code et de l'exécuter. 

Bulletin de sécurité : https://jira.mongodb.org/browse/SERVER-115508

MongoDB.local Paris 2025 : les temps forts de la conférence du 4 novembre

Soumis par francoistonic le

MongoDB.local Paris se tient le 4 novembre au CNIT Forest à Paris La Défense. L'éditeur met en avant plusieurs sessions :

10h00 – 11h00 – Keynote d’ouverture : « À quoi ressemble la base de données idéale à l’ère de l’IA ? »

Présentation des dernières nouveautés MongoDB : Vector Search, modèles d’embedding Voyage AI et performances cloud dans plus de 120 régions. Avec Boris Bialek (Field CTO Industry Solutions) et Fred Roma (SVP Atlas Data Services). 

●        12h10 – 12h55 – « System of Actions » : l’IA agentique au service de l’assurance et autres secteurs

Découvrez comment bâtir une architecture de données flexible pour déployer rapidement des systèmes d’IA agentique. 

Avec Bruno Guedes (Senior Solutions Architect).

●        12h10 – 12h55 – Protégez vos données les plus sensibles grâce à Queryable Encryption

Cas pratiques sur le chiffrement « in-use » permettant de requêter des données chiffrées sans compromettre la sécurité. 

Avec Brice Saccucci et Théo Demessance (Solutions Architecture Managers).

●        14h50 – 15h35 – Comment les bases de données modernes embarquent le Search

Atlas Search et Vector Search : vers une intégration native du moteur de recherche et de l’IA générative. 

Avec Hélène Brulin (MongoDB) et Frédéric Gisbert (Microsoft).

Programme complet : https://www.mongodb.com/fr-fr/events/mongodb-local/paris

MongoDB améliore la recherche

Soumis par francoistonic le

MongoDB annonce des améliorations sur la recherche et particulièrement sur la recherche vectorielle dans MongoDB Community Edition et Enterprise Server. Ces avancées étaient réservées à Atlas. 

Ces nouveautés doivent permettre aux développeurs de :

  • Tester et développer des applications d'IA localement : la recherche vectorielle permet la récupération d'informations sémantiques basée sur la signification encodée dans les intégrations vectorielles. Les utilisateurs peuvent ainsi gérer et développer des applications d'IA dynamiques qui s'appuient sur des données non structurées telles que des documents texte, des images, des vidéos, des fichiers audios, des messages de chat, etc., le tout dans leur environnement local ou sur site. 

  • Améliorer la précision grâce à la recherche hybride : Combiner la recherche par mot-clé et la recherche vectorielle permet d’obtenir des résultats unifiés à partir d'une seule requête et obtenir des résultats plus précis. Indispensable pour des solutions agentiques et des applications d'IA fiables, les développeurs peuvent facilement tirer parti de cette fonctionnalité directement via le cadre de requête familier de MongoDB. 

  • Doter les agents IA d'une mémoire à long terme : permettre aux données de MongoDB de servir de mémoire à long terme pour les agents IA, afin de créer des applications précises et contextuelles adaptées aux situations réelles. Avec Community Edition, les développeurs peuvent facilement prototyper des systèmes RAG. Les organisations qui s'appuient sur Enterprise Server peuvent ancrer en toute sécurité les agents IA au sein des données propriétaires de leur propre infrastructure. 

MongoDB Application Modernization Platform : une IA pour réduire la dette technique

Soumis par francoistonic le

Dette technique, modernisation applicatif. Ces deux termes sont parfois les cauchemars des entreprises et des équipes IT mais aussi des développeurs. Le patrimoine applicatif / IT n'est que le mainframe / Cobol, pensez à toutes les applications .Net, Java, PHP, C++, qui peuvent avoir 5, 10, 15 ans ! Il faut les maintenir, parfois les faire évoluer, et là tout se complique. La dette technique est une conséquence de ce legacy. La moindre app, le moindre site web est une dette technique. 

MongoDB a décidé, pour aider les entreprises, de sortir une plateforme dédiée : Application Modernization Platform. "MongoDB AMP aide les clients à se moderniser grâce à la fusion d'une plateforme logicielle basée sur l'IA, d'un cadre de livraison éprouvé et d'ingénieurs AMP expérimentés qui supervisent et guident le processus de mise en œuvre, soit une combinaison efficace d'outils, de techniques et de talents. En tant que fondement d'AMP, MongoDB offre aux clients la flexibilité du modèle de document et une architecture conçue pour une évolution continue. En combinant les outils AMP avec le cadre éprouvé et reproductible de MongoDB, les clients ont pu constater que des tâches telles que la transformation de code ont pu être accélérées d'un facteur 10 ou plus, et les projets de modernisation globaux accélérés de 2 à 3 fois. "

La promesse de la plateforme est de réduire le temps nécessaire pour migrer une application, de moderniser le code et d'automatiser les tâches. L'outil analyse l'application dans son ensemble puis peut proposer des tests de migration pour valider les étapes de transformation. Des agents IA aident à migrer et à transformer le code puis à intégrer les données. 

L'éditeur nous a précisé que la plateforme ciblait les applications et les piles techniques anciennes et/ou obsolètes pour les réarchitecturer. Par exemple, pour les données, il s'agit de les transposer en modèles MongoDB. Côté langage, l'éditeur supporte les environnements Java couplés à Oracle ou Sybase mais aussi en allant vers le monde .Net et C#, SQL Server, ou encore DB2. 

MongoDB rachète Voyage AI pour améliorer la qualité de la GenIA

Soumis par francoistonic le

MongoDB annonce le rachat de Voyage AI. Pour MongoDB, cet achat doit permettre de réduire les hallucinations IA. De facto, cela ne pourra qu'améliorer les résultats de la GenIA utilisée. 

MongoDB résume ainsi ce rachat :

  • Intégration des technologies de Voyage AI pour une récupération d’informations plus précise et pertinente.
  • Réduction des hallucinations et amélioration de la fiabilité des applications d’IA.
  • Une alliance stratégique pour permettre aux entreprises d’exploiter l’IA en toute confiance.

« Pour que les applications d'IA atteignent leur plein potentiel, les entreprises doivent faire confiance à leurs résultats, donc la récupération doit être profondément intégrée aux données opérationnelles pour être précise et pertinente », commente Tengyu Ma, Fondateur de Voyage AI. « Rejoindre MongoDB nous permet d'apporter notre technologie de récupération d'IA de pointe à un public plus large et de l'intégrer de manière transparente au sein d’applications critiques. En combinant notre expertise en embeddings et en reranking avec la base de données de premier ordre de MongoDB, nous pouvons aider les organisations à construire des applications d'IA qui fournissent des résultats plus précis et fiables à grande échelle, leur permettant d'appliquer l'IA avec confiance à des cas d'utilisation aux enjeux élevés. ». 

Réduire l’empreinte des vecteurs : la quantification vectorielle partie 2

Soumis par francoistonic le
Image
Image
Image

Dossier de Han HELOIR, EMEA Gen AI Solutions Architect (MongoDB)

La quantification vectorielle : Réduire pour mieux produire

1.   Pourquoi compresser les vecteurs ?

La quantification vectorielle est une méthode de compression des embeddings, qui consiste à réduire la précision des vecteurs pour diminuer leur taille en mémoire et leurs besoins en calcul. Cette approche s’inscrit dans une stratégie globale d’optimisation des systèmes d’IA générative, où chaque milliseconde et chaque octet comptent.

Sans quantification, les vecteurs sont généralement stockés en float32, un format numérique utilisant 32 bits par dimension. Cela garantit une précision élevée mais engendre des coûts de stockage exorbitants, une augmentation des latences, et des contraintes pour la scalabilité. La quantification répond à ces défis en réduisant la taille des vecteurs tout en maintenant une précision suffisante pour les tâches courantes.

2.   Les trois grandes méthodes de quantification

Chaque méthode de quantification propose un équilibre différent entre compression, précision, et performance. Voici un tour d’horizon des principales approches :

a) Quantification scalaire (int8) : La solution universelle

La quantification scalaire réduit la précision de chaque élément d’un vecteur en le mappant à un ensemble pré-défini de niveaux, comme les 255 niveaux disponibles en format int8. Cette méthode divise la taille des vecteurs par 4x à 32x, tout en conservant une grande partie de leur précision.

Comment ça marche?

  1. Les valeurs maximales et minimales de chaque dimension sont identifiées dans l’ensemble de données.
  2. L’espace entre ces valeurs est divisé en niveaux équidistants (ex. : 255 pour int8).
  3. Chaque élément du vecteur est associé au niveau le plus proche, réduisant ainsi sa précision.

Exemple:

Un vecteur original avec des valeurs précises comme [0.456, 0.789, -0.123] pourrait être réduit à [46, 78, -12], tout en maintenant sa signification dans les recherches.

Bénéfices:

-        Réduction importante des coûts de stockage.

-        Compatible avec la majorité des cas d’usage, des moteurs de recherche aux systèmes de recommandations

-        Conservation d’une précision élevée (jusqu’à 96 % dans certains scénarios).

b) Quantification binaire : La compacité maximale

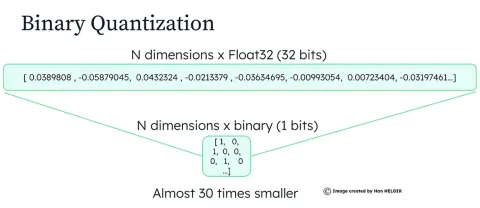
La quantification binaire pousse la compression encore plus loin en réduisant chaque élément à une valeur binaire (0 ou 1). Cela réduit drastiquement les besoins en stockage, mais au prix d’une perte de précision plus marquée.

Comment ça marche?

  1. Les vecteurs sont normalisés dans un espace restreint, souvent entre -1 et 1.
  2. Chaque élément est évalué : s’il est positif, il devient 1 ; sinon, 0.

Exemple :

Un vecteur [0.45, -0.23, 0.78] deviendrait [1, 0, 1].

Bénéfices :

-        Compression maximale, divisant les besoins de stockage par 32x à 64x.

-        Temps de calcul réduit grâce à des représentations simplifiées.

Risque de perte de précision, nécessitant des techniques complémentaires comme le rescoring ou l’oversampling.

c) Quantification par produit (PQ) : La solution modulaire

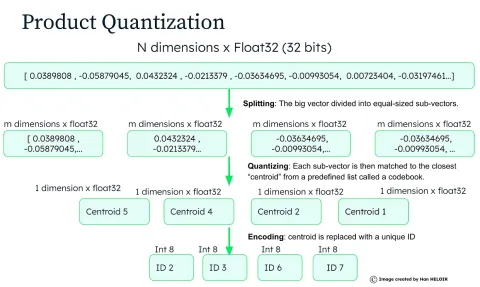
La quantification par produit (Product Quantization - PQ) divise un vecteur de haute dimension en sous-vecteurs de taille plus petite, chacun étant compressé indépendamment. Cette méthode offre un compromis idéal entre compression, précision, et efficacité computationnelle.

Comment ça marche?

  1. Le vecteur est divisé en plusieurs segments (ou sous-vecteurs).
  2. Chaque sous-vecteur est associé à un centroïde préalablement calculé (via des algorithmes comme k-means).
  3. Au lieu de stocker les sous-vecteurs eux-mêmes, on ne conserve que les indices des centroïdes correspondants.

Exemple :

Un vecteur [0.45, -0.23, 0.78, -0.11] pourrait être divisé en deux sous-vecteurs [0.45, -0.23] et [0.78, -0.11], chacun étant compressé indépendamment.

Bénéfices:

-        Permet une compression adaptative selon les besoins.

-        Très efficace pour des systèmes traitant des milliards de vecteurs, comme FAISS (Facebook AI Similarity Search).

Performances légèrement inférieures pour les recherches en temps réel.

Cas d’usage recommandé :

-        Systèmes nécessitant une forte scalabilité, comme les plateformes de commerce électronique ou les moteurs de recherche visuelle.

4.   Pourquoi choisir la quantification vectorielle en production ?

a) Réduction des coûts

Selon une étude réalisée par HuggingFace, la quantification scalaire ou binaire peut réduire les coûts de stockage par un facteur de 20x à 30x, tout en maintenant une précision suffisante pour la majorité des cas d’usage. Par exemple : Une base contenant 250 millions de vecteurs passe de 7,5 To à 240 Go.

b) Amélioration des performances

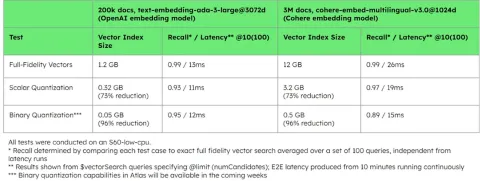
Avec des vecteurs compressés, les recherches deviennent plus rapides car il y a moins de données à traiter. Cela se traduit par une réduction significative de la latence, essentielle pour les applications en temps réel.

Significant storage reduction + good recall and latency performance with quantization on different embedding models(Source: MongoDB blog)

c) Scalabilité accrue

La compression permet de gérer des bases de données volumineuses sans augmenter proportionnellement les coûts en matériel ou en infrastructure cloud. Cela ouvre la voie à une scalabilité durable, même avec une augmentation rapide des utilisateurs et des requêtes.

4.   Techniques avancées pour compenser la perte de précision

Oversampling : Récupère un plus grand nombre de résultats initiaux pour maximiser les chances d’inclure les éléments pertinents.

Rescoring : Affine les résultats en recalculant leur pertinence avec les vecteurs originaux (float32), garantissant des recommandations de haute qualité.

Conclusion : Construire une IA générative scalable

Grâce à des techniques comme la quantification vectorielle et l’indexation HNSW, les entreprises peuvent réduire leurs coûts, améliorer leurs performances, et garantir une scalabilité durable. Ces approches sont essentielles pour transformer les PoC prometteuses en solutions de production robustes et économiques.

Invitation à l’action : Explorez ces techniques dans vos projets et découvrez leur impact sur vos systèmes IA !

Références : 

  1. HuggingFace: Binary and Scalar Embedding Quantization for Significantly Faster & Cheaper Retrieval (https://huggingface.co/blog/embedding-quantization#quantization-experiments)
  2. MongoDB blog: Significant storage reduction + good recall and latency performance with quantization on different embedding models (https://www.mongodb.com/blog/post/vector-quantization-scale-search-generative-ai-applications)

Réduire l’empreinte des vecteurs : la quantification vectorielle partie 1

Soumis par francoistonic le
Image

Dossier de Han HELOIR, EMEA Gen AI Solutions Architect (MongoDB)

Introduction : la révolution des embeddings et ses défis cachés

L’intelligence artificielle générative, notamment à travers le Retrieval-Augmented Generation (RAG), révolutionne la gestion des données en combinant la puissance des modèles génératifs avec des bases de connaissances structurées. Cette approche permet d’automatiser des tâches complexes tout en accédant en temps réel à des informations précises et pertinentes provenant de multiples sources. 

Au cœur de ces systèmes se trouvent les embeddings, des vecteurs mathématiques capables de représenter des données non structurées telles que des textes, des images, ou des vidéos. Ces vecteurs permettent de réaliser des tâches avancées comme les recherches sémantiques, les recommandations, ou encore l’analyse de similarité.

Cependant, derrière l’innovation se cache une complexité technique. Lors de la phase de PoC (Proof of Concept), la gestion des embeddings peut sembler relativement simple. Mais une fois en production, ces vecteurs deviennent une source importante de coûts, de latence, et de problèmes d’évolutivité. En effet, leur stockage, leur traitement, et leur recherche à grande échelle exigent des infrastructures coûteuses et complexes.

Dans cet article, nous explorons comment la quantification vectorielle, associée à des techniques de l’indexation comme HNSW(Hierarchical Navigable Small World), peut réduire significativement ces obstacles. Ces approches permettent de maintenir des performances élevées tout en rendant la scalabilité plus accessible.

Les défis techniques des embeddings en production

1. Explosion des coûts de stockage

Chaque embedding est une représentation numérique haute dimension, souvent en format float32. Cela signifie que chaque élément du vecteur utilise 32 bits de mémoire. Multipliez cela par des millions, voire des milliards d’embeddings, et vous obtenez des volumes de données astronomiques.

Prenons un exemple concret : une base contenant 250 millions d’embeddings, chacun ayant 1 024 dimensions. En format float32, cette base occuperait 7,5 To d’espace et coûterait environ 3 600 $ par mois sur une plateforme comme AWS. À cela s’ajoutent les frais pour les sauvegardes, la redondance, et la haute disponibilité. Ces coûts deviennent rapidement prohibitifs, notamment pour des start-ups ou des projets avec des budgets limités.

Embeddings et le coût associé (Source: HuggingFace)

2. Latence accrue et surcharge computationnelle

Les embeddings ne se limitent pas au stockage ; ils doivent également être interrogés pour effectuer des recherches rapides et précises. Ces recherches, appelées recherches de voisins les plus proches (Nearest Neighbor Search), nécessitent des calculs dans des espaces vectoriels de haute dimension. Chaque vecteur doit être comparé à d’autres pour déterminer les éléments les plus similaires.

Plus les vecteurs sont longs (haute dimension) et plus la base de données est volumineuse, plus la recherche devient longue. Cela pose un problème critique dans les applications en temps réel, où les utilisateurs s’attendent à des réponses quasi instantanées. Par exemple, une application de recommandations doit répondre en moins de 300 millisecondes pour maintenir une expérience utilisateur satisfaisante. Une recherche trop lente peut entraîner une frustration des utilisateurs et une perte de clients.

3. Scalabilité limitée

À mesure que le nombre d’utilisateurs et de données augmente, les exigences en calcul et en mémoire explosent. Cela entraîne des frais supplémentaires en matériel (serveurs, RAM) et en infrastructure cloud, créant un goulot d’étranglement financier. Les entreprises sont alors confrontées à un dilemme : réduire la qualité du service ou augmenter leurs dépenses.

HNSW : Une indexation intelligente pour les recherches rapides

1. Une structure hiérarchique

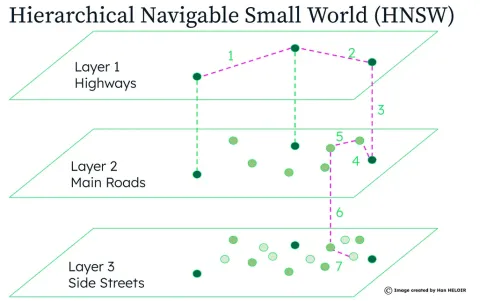
HNSW (Hierarchical Navigable Small World) est une méthode d’indexation conçue pour accélérer les recherches dans des bases vectorielles. Contrairement à une recherche linéaire, qui comparerait chaque vecteur à l’ensemble des autres, HNSW construit un graphe multi-niveaux pour organiser les données de manière plus efficace.

Ce graphe hiérarchique fonctionne comme une carte routière :

-        Niveau supérieur : Les autoroutes, qui permettent de parcourir rapidement de grandes distances.

-        Niveaux intermédiaires : Les routes principales, qui affinent la recherche.

-        Niveau le plus bas : Les petites rues, qui mènent aux résultats finaux.

En utilisant cette approche, HNSW réduit drastiquement le nombre de comparaisons nécessaires pour trouver les voisins les plus proches d’un vecteur, tout en garantissant une recherche rapide et précise.

2. Avantages et limitations

HNSW est particulièrement efficace car il :

-        Réduit les temps de recherche, même dans des bases massives.

-        Permet des mises à jour incrémentielles (ajout de nouveaux vecteurs sans reconstruire tout l’index).

Cependant, cette méthode exige une grande quantité de RAM, car le graphe doit être entièrement chargé en mémoire pour offrir des performances optimales. C’est ici que la quantification vectorielle devient essentielle, car elle réduit la taille des vecteurs et, par conséquent, les besoins en mémoire.

wal2mongo v1.0.7

Soumis par fredericmazue le

wal2mongo est un plugin de sortie de décodage logique PostgreSQL conçu pour simplifier la réplication logique de PostgreSQL vers MongoDB en formatant la sortie dans un format de type JSON accepté par MongoDB. wal2mongo est édité par HighGo Software qui vient d'annoncer la première version communautaire GitHub de wal2mongo v1.0.7.

wal2mongo v1.0.7 peut être utilisée pour répliquer les modifications de la base de données PostgreSQL dans un format de sortie pouvant être directement introduit dans l'outil client mongo pour réaliser une réplication logique entre PostgreSQLet MongoDB. Le plugin Wal2mongo est utile dans le cas où PostgreSQL est utilisé comme principale source de données brutes pour collecter des données du monde extérieur, mais MongoDB est utilisé en interne à des fins d'analyse de données. La migration manuelle des données entre PostgreSQL et MongoDB pose de nombreux problèmes potentiels et disposer d'un plugin de décodage logique comme wal2mongo peut aider à réduire la complexité de la migration des données entre les deux bases de données

wal2mongo est un logiciel libre sous licence Apache 2.0 disponible sur GitHub.