NoSQL

Apple publie le code de FoundationDB sur GitHub

Soumis par fredericmazue le

Il y a trois ans, Apple a racheté la startup FoundationDB, éditrice du système de base de données du même nom. La firme à la pomme vient de publier le code de FoundationDB sur GitHub.

FoundationDB est un système de base de données distribué NoSQL, construit avec une shared nothing architecture, terme qui signifie que tout noeud constitutif de l'ensemble est indépendant et auto-suffisant.

Dans FoundationDB, les données sont stockées selon le modèle clé-valeur. Le site officiel de FoundationDB décrit ce système comme étant extrêmement performant, même sur du matériel moyen, ce qui permet de supporter de très forte charge à faible coût. Il est précisé que les performances restent excellentes même au cours des opérations d'écritures intensives. FoundationDB expose une API.

Le code de FoundationDB est donc désormais sur GitHub. Des instructions sont données sur la page GitHub pour compiler le code sous macOS ou Linux. Par défaut une bibliothèque Python est générée pour invoquer les API de FoundationDB. Mais il est également possible de générer l'équivalent pour d'autres langages.

MongoDB 3.6 bientôt disponible

Soumis par fredericmazue le

MongoDB annonce le lancement de MongoDB 3.6.

« MongoDB a été créé par des développeurs pour des développeurs afin de leur offrir une base de données moderne conçue pour les applications très complexes d’aujourd’hui. Cette nouvelle version apporte des innovations majeures qui placent la barre encore plus haut pour ce que les développeurs sont en droit d’attendre de leur base de données, leur permettant ainsi de consacrer leur temps à la réalisation d’applications innovantes qui transforment leur entreprise », commente Dev Ittycheria, Président et CEO de MongoDB. « MongoDB 3.6 facilite et accélère la création d’applications actives à tout moment, qui réagissent en temps réel aux changements dans les données circulant entre des systèmes distribués. En outre, grâce à des fonctionnalités de gestion et de sécurité nouvelles ou étendues, les développeurs bénéficient de la liberté et de la confiance nécessaires pour exploiter MongoDB dans les environnements les plus exigeants au service d’applications critiques. »

Parmi les principales nouveautés :

  • Les détections de modifications permettent aux développeurs de créer des applications web, mobile et IoT réactives, capables de visualiser, de filtrer et d’exploiter les changements à mesure qu’ils se produisent dans la base de données. Chaque fois que des données sont modifiées dans MongoDB, ces changements sont automatiquement répercutés en temps réel dans l’application.
  • Les reprises automatiques d’écritures transfèrent la complexité de la gestion des pannes systèmes de l’application à la base de données. Evitant aux développeurs d’avoir à implanter du code personnalisé côté client pour gérer les erreurs réseau pendant les mises à jour, MongoDB retente automatiquement les écritures en cas d’erreur.
  • MongoDB Compass, qui facilite l’analyse et la compréhension par les utilisateurs du schéma de la base de données, intègre désormais le remplissage automatique des requêtes, l’historique des requêtes et des vues de tables
  • MongoDB Compass Community offre aux développeurs une nouvelle alternative gratuite d’interface utilisateur graphique au shell MongoDB, compatible avec les plus récentes fonctionnalités de la gamme Compass.

Disponibilité

La disponibilité générale de MongoDB 3.6 est prévue pour début décembre. 

MySQL 8.0 est en Release Candidate

Soumis par fredericmazue le
Image

L'équipe de développement de MySQL vient d'annoncer la disponibilité de MySQL 8.1 en Release Candidate. Une mouture qui rend MySQL meilleur pour les applications modernes, souligne le billet d'annonce.

Une application moderne est avant tout une application mobile, explique l'équipe de développement, c'est-à-dire une application qui tient compte de la localisation de son utilisateur et du fait qu'il faut réduire au maximum le nombre de clics qu'il doit effectuer. Sur cette base, MySQL apporte de nombreuses nouveautés, dont voici les plus remarquables selon nous.

Un support JSON amélioré

L'usage de JSON, qui est au départ le format de données pour le langage JavaScript, tend à généraliser, d'où l'importance de soigner son support pour l'équipe de MySQL. Ainsi arrive une fonction permettant de vérifier la taille, en terme d'espace disque, d'une données JSON. Arrivent des fonctions qui permettent d'agréger des tableaux et des objets, et arrive le support des plages de données (ranges). Ce qui permet d'extraire des éléments précis d'un tableau. Par exemple :

Du NoSQL dans MySQL

Le Document Store, introduit avec MySQl 7.5, permet de travailler avec des API NoSQL pour la lecture, l'écriture, la modification et l'effacement des données, tout en gardant la consistance des données. Le développeur n'est pas obligé d'abandonner SQL pour autant, car il reste possible d'accéder aux données du Docuement Store par ce moyen.

Unicode 9

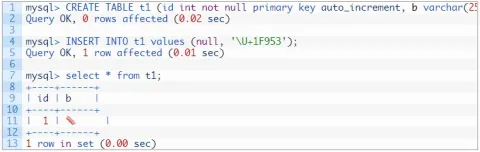
Avec l'internationalisation des applications, l'usage d'Unicode, et en particulier d'UTF-8, tend à se généraliser. MySQL 8.0 supporte le dernier standard Unicode 8 et laisse tomber (enfin...) latin1 comme jeu de caractères par défaut. Le jeu de caractères par défaut est désormais utf8mb4. Désormais, vos résultats de requêtes peuvent afficher des émojis :-)

MarkLogic lance un nouveau framework de hub de données d'entreprise

Soumis par fredericmazue le

MarkLogic a annoncé le lancement du framework de hub de données MarkLogic Data Hub, une architecture de référence conçue pour permettre aux architectes et aux développeurs informatiques d'intégrer rapidement et facilement des silos de données et d'exécuter des projets de transformation numérique. Ce nouveau framework est open source sous Licence Apache 2.0.

« Nous sommes à la pointe du secteur des bases de données NoSQL. Il nous a donc semblé important de créer un framework agile, destiné spécifiquement aux développeurs, afin d'accélérer et de faciliter les projets extrêmement complexes d'intégration de gros volumes de données ou de transformation numérique », explique Paxton Hare, Principal Community Engineer au sein de MarkLogic. « Soutenue par une communauté de développeurs dédiés dans le monde entier, cette nouvelle architecture de référence exploite les pratiques d'excellence que MarkLogic a élaborées au fil de ces déploiements Enterprise NoSQL au cours des dix dernières années. Nous sommes convaincus qu'un référentiel centralisé NoSQL ne peut que bénéficier aux entreprises qui veulent pouvoir accéder à leurs données, les gérer et les exploiter rapidement. »
 

Une nouvelle version de la plateforme de données Couchbase

Soumis par fredericmazue le

Couchbase vient d’annoncer la sortie d’une nouvelle version de sa plateforme de données Couchbase destinée à alimenter les applications web, mobiles et IoT (Internet des objets) pour les entreprises numériques. La solution améliorée permet, d'après l'éditeur, de déployer plus facilement des applications à l’échelle mondiale, présente des capacités de sécurité avancées et des fonctionnalités de développement plus flexibles et intègre désormais Couchbase Server 4.6, Couchbase Sync Gateway 1.4, Couchbase Kafka Connector 3.0 et Couchbase Spark Connector 2.0.

Principales caractéristiques de la plate-forme Couchbase
La toute dernière version de la plateforme de données Couchbase intègre les composants suivants :

  • Couchbase Server 4.6 – Déploiement facilité des applications à l’échelle mondiale, applications plus performantes, options de sécurité avancées, gestion intégrée des structures riches en données, telles que listes, cartes et ensembles de données, et développement intégré d’applications .NET
  • Couchbase Sync Gateway 1.4 – Évolutivité sans limite des applications mobiles et IoT, grâce à la nouvelle fonctionnalité Sync Gateway Accelerator
  • Couchbase Kafka Connector 3.0 –  Gestion de Kafka Connect, qui offre une plus grande modularité, des performances optimales et une capacité de diffusion en continu fiable entre Apache Kafka et d’autres systèmes ; ajout d’un nouveau connecteur Sink Connector, permettant aux données issues des sujets Kafka d’être conservées directement dans Couchbase Server
  • Couchbase Spark Connector 2.0 – Gestion de Apache Spark 2.0 et de son API de diffusion en continu structurée, offrant une meilleure manière d’analyser en continu les données opérationnelles et permettant à Couchbase d’opérer aussi bien en tant qu’entrée Sink et entrée Source Spark Structured Streaming

Progress : de nouveaux connecteurs DataDirect pour Apache Cassandra

Soumis par fredericmazue le

Progress annonce la sortie de Progress DataDirect for Apache Cassandra, une nouvelle série de connecteurs au sein de sa gamme DataDirect. Grâce aux interfaces standard ODBC et JDBC basées sur le langage SQL et reconnues par l’ensemble de l’industrie, DataDirect for Apache Cassandra garantit la compatibilité des applications existantes avec la base de données NoSQL Cassandra.

« Les entreprises leaders adoptent les bases de données Cassandra pour répondre aux exigences des solutions déployées sur Internet en matière de performances, d'évolutivité et de disponibilité », déclare Dion Picco, General Manager, Data Connectivity & Integration, chez Progress. « En présentant ses données sous la forme de tables relationnelles normalisées, la solution Progress DataDirect permet aux entreprises d'utiliser une solution standard basée sur le langage SQL avec des interfaces de connectivité ODBC et JDBC pour intégrer plus facilement Cassandra à leur infrastructure de gestion de données existante. »

Soirée NoSQL au ParisJUG

Soumis par fredericmazue le

Le Paris JUG est un groupe d'utilisateurs Java ayant pour but de réunir les acteurs du langage (professionnels, communautés open source, institutions, étudiants, enseignants...) afin d'échanger des idées et de discuter des avancées technologiques de la plateforme Java.

Le Paris JUG organise des rencontres le deuxième mardi du mois. Les réunions sont gratuites, ouvertes à tous et consistent en une présentation technique, une démonstration d'un produit, ou une table ronde. Après la réunion les participants se retrouvent généralement pour un échange informel autour d'un verre et d'un mini-buffet.

Le thème de la réunion de ce mois de mai est NoSQL. En voici le programme

19h15 à 19h30 : Accueil

19h30 - Neo4j reloaded: le graphe à portée de mains 

Neo4j 3.0 est sorti avec son lot de nouveautés qui rendent les graphes encore plus simples à manipuler et intégrables dans un SI traditionnel.
Dans un premier temps, nous démystifierons ensemble les bases de données graphe et leurs usages avant de plonger dans les dernières nouveautés de Neo4j.
Par Florent Biville

20h00 - Couchbase, the NoSQL, NoCache, NoMobile Database

No as not only. Couchbase is an OpenSource Document Database. Like most NoSQL DBs, it is distributed, highly available and schemaless. But unlike most NoSQL DBs, it also supports SQL querying with N1QL, a SQL query language for JSON documents, and Fulltext search through Bleve.

But No means not only, and Couchbase is not only a NoSQL DB. With its integrated Caching layer, you don't have to deploy any additional caching solution, everything you do is already in memory. And for mobile developers, Couchbase features a full mobile solution which resolves the offline synchronization problem.

In this presentation we will go over Couchbase's architecture and see what makes it possible to have such a versatile database. We'll end this presentation with some deployment or code examples.
Par Laurent Doguin

20h30 à 21h00 : Buffet

21h00 - Un moteur de recherche NoSQL pour chercher^H^H^H^H^H^H^H^H trouver...

Vous cherchez toujours dans vos données avec des SELECT * FROM person WHERE name like '%david%pilato%" ?
Au delà des performances obtenues, êtes-vous certain de renvoyer les résultats les plus pertinents pour vos utilisateurs d'abord ?
Venez découvrir comment un moteur de recherche vous aidera à répondre aux questions posées par vos utilisateurs, de manière pertinente et efficace, tout en apportant des fonctionnalités d'analyse des résultats et ce, quelque soit le volume...
Par David Pilato

21h30 - Apache Cassandra en 2016

Durant cette session on fera le point sur l'état d'Apache Cassandra en 2016 avec les principales fonctionnalités de la base, les nouveautés des 6 derniers mois, les cas d'utilisation couramment rencontrés dans l'industrie ainsi qu'un panel des différents déploiements de Cassandra en France et de part le monde.
Par Duy Hai Doan

Après : 3ème mi-temps des juggers au Les Négociants (23 Avenue des Gobelins,75005 Paris)

Informations pratiques :
Le 13 septembre 2016
Dans les locaux de l'ESIEA au 9 rue Vesale 75005 Paris.
Inscription ici

EntrepriseDB lance la plateforme EDB Postgres

Soumis par fredericmazue le

EnterpriseDB annonce la disponibilité de la plateforme EDB Postgres, plateforme intégrée fondée sur du code open source pour la gestion de base de données d’entreprise.

EDB Postgres est une première plateforme intégrée de gestion opérationnelle de données fondée sur code source ouvert et qui rassemble la totalité des composants nécessaires pour la gestion de données structurées et non structurées dans un modèle fédéré. Si la plateforme permet une intégration à travers différentes bases de données, elle prend également en charge la combinaison de données non structurées de solutions NoSQL avec des données transactionnelles d'entreprise dans des systèmes relationnels structurés.

La plateforme EDB Postgres comporte :

  • Le choix de deux versions de serveur pour EDB Postgres Database :  EDB Postgres Standard Server, base de données en source libre PostgreSQL ; ou ( EDB Postgres Advanced Server, version améliorée de PostgreSQL avec performance étendue de classe entreprise, modularité, fonctionnalités et capacités de sécurité : les clients disposent d'options multiples s'adaptant à leurs exigences spécifiques.
  • Des solutions dans la Management Suite, fournissant des capacités de récupération critique en cas de désastre, haute disponibilité, suivi et mise au point.
  • Une Migration Suite permettant aux organisations de migrer des charges de travail à partir d'autres solutions, notamment Oracle, au moyen de la compatibilité de base de données pour Oracle, développée par EDB.
  • Une Integration Suite mettant en vedette une collection de solutions prenant en charge la réplication de données et l'intégration d'EDB Postgres dans d'autres solutions telles que MongoDB et Hadoop.
  • Assistance et services pour compléter l'écosystème de la solution Postgres fournie aux clients EDB en tant qu'assistance mondiale 24 heures sur 24 et 7 jours sur 7. Des mises à jour sont comprises dans les souscriptions à la plateforme EDB Postgres ; des formations et services professionnels sont disponibles pour veiller à ce que les clients réalisent un retour sur investissement.

La plateforme EDB Postgres est disponible sous forme de souscription, comprenant la totalité des composantes de solutions pour gestion de données, l'assistance Postgres, les nouvelles versions de logiciel et un accès à une grande partie du réseau de partenaires d'EDB. Le logiciel EDB Postgres peut être déployé sur bare metal, virtuellement -y compris dans des environnements conteneurs -, ou dans des environnements cloud publics, privés et hybrides. EDB Postgres est basée sur un code source ouvert, sur des normes et elle fonctionne sur tous les grands systèmes opérationnels, dont divers distributeurs de Linux et Windows, souligne l'éditeur.

Site : www.enterprisedb.com

Oracle annonce la disponibilité de MySQL 5.7

Soumis par fredericmazue le

Oracle annonce la disponibilité de MySQL 5.7, la nouvelle version de la base de données en logiciel libre. Cette version améliore encore les performances, l'évolutivité et l'administration de MySQL. Sur le plan des performance, Oracle affirme que cette mouture est trois fois plus rapide que MySQl 5.6. Elle intègre des fonctions NoSQL enrichies avec le support de JSON et MySQL Router qui facilite la connexion des applications à plusieurs bases de données MySQL.

"MySQL 5.7 apporte de multiples innovations permettant aux développeurs, aux administrateurs de base de données et aux équipes DevOps de réaliser et de gérer des applications Web et cloud de nouvelle génération, capables de traiter des volumes toujours plus importants de données," déclare Tomas Ulin, Vice President, MySQL Engineering, Oracle. "MySQL 5.7 a bénéficié des versions intermédiaires de développement qui ont permis aux utilisateurs d'évaluer, de tester et de commenter le logiciel pendant son développement. Cette version résulte ainsi d'un processus collaboratif impliquant de nombreux membres de la communauté MySQL."

Voici les principales évolutions de MySQL 5.7 mises en avant par Oracle :

  • Vitesse améliorée : Dans des tests comparatifs utilisant des opérations en lecture seule de type SysBench Point-Selects, avec 1 024 connexions, MySQL 5.7 a pu traiter 1 600 000 requêtes par seconde (QPS) – soit 3 fois plus que MySQL 5.6.
  • InnoDB optimisé : Les nouveautés améliorent notamment les performances et la concurrence, les opérations en ligne, les index spatiaux ou encore le partitionnement natif.
  • Réplication plus robuste : Les améliorations des fonctions de réplication de MySQL intègrent notamment la réplication multi-sources, des identifiants globaux de transaction (GTID) renforcés, et des serveurs esclaves multi-threadés améliorés assurant une scalabilité et une disponibilité accrues.
  • Optimiseur enrichi : Le nouveau modèle de coût dynamique de l'optimiseur MySQL améliore la performance des requêtes et peut être mieux contrôlé par l'utilisateur.

Voici, toujours selon Oracle, les principales évolutions de MySQL 5.7 concernant l'administration :

  • Nouveau type de données natif JSON et nouvelles fonctions JSON : pour stocker, rechercher et manipuler des données sans schéma de façon efficace et souple, avec notamment un nouveau format binaire interne, une intégration plus facile dans SQL et la gestion des index sur les Documents JSON en utilisant les colonnes générées.
  • Performance Schema : il permet une instrumentation de la mémoire, des transactions, des routines stockées, des instructions préparées, de la réplication et des verrous.
  • MySQL SYS Schema : il fournit des objets utilitaires pour répondre facilement aux questions que l'on se pose habituellement en matière de performance, d'état du système, d'usage et de surveillance.
  • Sécurité renforcée : pour faciliter et sécuriser encore plus l'initialisation, la configuration et la gestion d'une instance MySQL
  • Support étendu des systèmes d'information géographiques (SIG) pour les applications mobiles : il intègre le support des index spatiaux dans InnoDB, GeoJSON et GeoHash.

Le nouveau routeur MySQL Router est également désormais disponible, il simplifie le développement applicatif en assurant le routage intelligent des requêtes sur différentes bases de données MySQL afin d'augmenter encore les performances et la disponibilité. MySQL Router assure également le support inter-langages pour MySQL Fabric, afin de simplifier la gestion des groupes de bases de données MySQL et d'assurer une disponibilité et une évolutivité maximales grâce à la segmentation automatique des données.

MySQL Group Replication est déjà disponible sur http://labs.mysql.com afin que les membres de la communauté puissent le tester et faire part de leurs commentaires. MySQL Group Replication permet de constituer des clusters de réplication active/active autorisant l'écriture sur tous les nœuds MySQL, avec une détection et une résolution automatiques des conflits.

MySQL 5.7 sera disponible en téléchargement sur http://dev.mysql.com/downloads/ à partir du 26 octobre 2015. Offre soumise à conditions.

RIAK TS : le stockage et l’analyse des données non structurées générées par l’Internet des Objets (IoT) ou les applications time-series

Soumis par fredericmazue le

Basho Technologies a annoncé aujourd'hui le lancement de Basho Riak TS, une base de données distribuées NoSQL conçue pour agréger et analyser des grandes quantités de données séquencées et non structurées qui peuvent être générées par l’Internet des Objets (IoT) ou par d’autres sources de données chronologiques (time-series). Riak TS est optimisé pour fournir des lectures et des écritures fiables et évolutives à une vitesse inégalée afin de permettre aux organisations de répondre aux besoins de stockage et de récupération de leur application time-series.

 « L’émergence des données non-structurées présente une forte opportunité d’innovation qui résulte en une demande accrue des entreprises de travailler avec des solutions de bases de données qui sont faciles à opérer et à optimiser pour spécifiquement gérer des données non-structurées. Riak TS nous permet d’être aujourd’hui le seul acteur du NoSQL qui a une offre spécialisée intégrant clé valeur , large objet, et données time-series. Riak TS va permettre à nos clients de plus facilement mettre à l’échelle et exécuter, entres autres, des cas d’utilisation adaptés à l’Internet des Objets. », commente Adam Wray, PDG, Basho Technologies.

Riak T est présentée par l'éditeur comme offrant une haute disponibilité et une mise à l’échelle massive. Riak TS, toujours selon Basho Technologies, comparativement aux bases de données relationnelles traditionnelles, peut être déployée à un coût moindre et est facile à gérer. Riak TS permet à ses utilisateurs de bénéficier des avantages des applications time-series avec diverses possibilités :

  • • Assurer que les applications IoT ou time series sont toujours disponibles pour des opérations de lecture ou d’écriture avec une possibilité d’adaptation pour répondre à l’augmentation du nombre d’appareils ou d’utilisateurs.
  • • Ajouter des noeuds aux grappes sans distribution des données (sharding). Avec Riak TS, la donnée est automatiquement et uniformément distribuée à travers la grappe.
  • • Archiver une performance de lecture et d’écriture plus rapide même sous des pointes de charges. La co--‐location des données permet de garantir que les données time-series sont stockées dans le même noeud par rapport au temps, géohash ou les deux afin d’éviter des tensions dans les grappes.
  • • Obtenir une précision des données avec la possibilité de valider les entrées de données.
  • • Obtenir des données d’interrogation en mode similaire aux interrogations SQL.
  • • Répondre aux besoins uniques d’une application avec des API solides et des bibliothèques client qui incluent du code Java, Rudby, Python, Go, Erlang, Node.js ou .NET.
  • • Intégrer de façon transparente Apache Spark pour permettre l’analyse facilitée et plus rapide des données time-series.
  • • Intégrer avec la Basho Data Platform, qui soutien plusieurs modèles de bases de données, simplifiant le travail de construction et de déploiement des charges de travail dans les applications Big Data, IoT et Cloud hybrides.