NoSQL

MapR présente la première base de données documentaire basée sur Hadoop

Soumis par fredericmazue le

A l’occasion de Strata + Hadoop World MapR Technologies a annoncé l’ajout du support natif de JSON à la base de données NoSQL MapR-DB. La première base de données documentaire basée sur Hadoop va permettre aux développeurs de fournir rapidement des applications à haute élasticité qui tirent elles aussi profit de l’analytique en continu sur des données temps réel.

Avec ces améliorations majeures, les développeurs bénéficient des avantages d’une base de données documentaire combinée avec l’échelle, la fiabilité et les capacités analytiques intégrées d’offres professionnelles Hadoop et Spark. Ces caractéristiques vont renforcer la capacité des entreprises à améliorer tout un éventail de cas d’usage – qu’il s’agisse de personnaliser et de fournir la meilleure expérience du shopping en ligne, comme de réduire le risque et prévenir la fraude en temps réel, ou encore d’améliorer l’efficacité de ses processus manufacturiers pour réduire ses coûts. Afin d’aider les développeurs à expérimenter et pratiquer MapR-DB, une préversion leur étant destinée et accompagnée de code d’illustration est disponible au téléchargement.

La distribution MapR intégrant Hadoop dispose d’une architecture conçue pour offrir une plateforme permettant d’exécuter des applications analytiques et opérationnelles. MapR-DB permet d’analyser en continu des données temps réel, tout en réduisant l’expansion des clusters, en éliminant les silos de données, et en réduisant le coût total de gestion des données. Le support natif de JSON dans MapR-DB permet également d’accélérer la création de valeur en donnant aux développeurs les moyens de produire plus vite un plus grand nombre d’applications métiers à partir de plus de sources et de types de données. MapR-DB supporte l’interface applicative Open JSON Application Interface (OJAI), qui est conçue comme une couche d’accès générique JSON pour bases de données, systèmes de fichiers, et flux de messages afin d’offrir une interface flexible et unifiée pour traiter d’importants volumes de données.

« MapR continue d’avancer sur la base de la plateforme de données innovante qui est au cœur de sa distribution Hadoop », explique Nik Rouda, analyste senior au sein de l’Enterprise Strategy Group. « L’ajout d’une capacité de base de données documentaire (JSON) étend élégamment la puissante offre NoSQL MapR-DB pour couvrir de manière transparente plus de types de données métiers non structurées. Cela simplifie et accélère la construction d’applications Big Data, sans la contrainte d’un déplacement initial des données ».

« MapR permet aux développeurs d’entreprise de créer de nouvelles applications à valeur ajoutée dont ils ne pouvaient que rêver jusqu’ici », indique Anil Gadre, Vice-Président senior produits, MapR Technologies. « En intégrant étroitement une base documentaire NoSQL au sein de notre plateforme, nous donnons aux développeurs les moyens de construire rapidement de nouvelles applications qui exigent une latence extrêmement limitée, et une flexibilité considérable pour le support de multiples types de données au sein d’un unique cluster ».

Disponibilité

Une préversion pour développeurs de MapR-DB avec support natif de JSON est dès à présent disponible et peut être téléchargée ici. Ces nouvelles capacités seront disponibles pour tous au sein de MapR-DB au cours du prochain trimestre.

Une démonstration interactive des nouvelles fonctionnalités de MapR-DB JSON combinées au logiciel Visual Action est disponible ici.
Basho : puissance NoSQL

Soumis par francoistonic le

L’éditeur Basho est en France depuis à peine 7 mois. Ce jeune éditeur est un acteur du monde Big Data et des plateformes NoSQL, capables d’une montée en charge exponentielle. Riak est l’outil le plus connu pour les bases et données et traitements hautement distribués. Riak est disponible en version Open Source et Entreprise. Cette dernière bénéficie de fonctions avancées. Basiquement, Riak s’articule autour de 3 fondamentaux : haute disponibilité, montée en charge et tolérance de pannes. 

Si le monde NoSQL et des bases massivement distribuées ont réussi à se faire une place auprès des développeurs, le marché reste très conservateur et on ne change pas de bases de données comme cela. Mais les entreprises font un constat de plus en plus concret : les données sont désormais massives (en qualité) et de nature très différente (structurée, semi-structurée et non-structurée). Pour traiter du non-structurée, mieux vaut une base dédiée, et là, nous tombons sur les bases dites NoSQL, capable d’injecter, de stocker et de traiter des données de toute origine et de tout type, sans pour autant, perdre en performances et en traitements. 

Pour répondre à ces problématiques, Basho propose plusieurs versions de Riak :

  • Riak KV : base de données distribuée dite NoSQL
  • Riak S2 : comparable sur le principe à Amazon S3, c’est la plateforme de stockage objet. 
  • Riak TS : nouvel outil qui apporte une langage de requête ressemblant sur le principe à SQL.
  • Riak Ensemble : librairie orientée multi-paxos. Paxos est un ensemble de protocole pour les consensus dans les réseaux. C’est une base du calcul distribué. Cette implémentation est écrite en Erlang.

Aujourd’hui, une vingtaine de personnes s’occupe de l’Europe. Les équipes devraient croitre courant 2016, notamment en France. 

François Tonic

ScyllaDB : Cassandra réécrite en C++ pour être 10 fois plus rapide

Soumis par fredericmazue le
Image

Voici une nouvelle qui ne manquera pas d'amuser les détracteurs de Java, qui depuis toujours lui reprochent sa lenteur, en dépit des indéniables améliorations que la machine virtuelle Java et son compilateur JIT ont connus au fil des années.

Cassandra est une base de données NoSQL et distribuée écrite en Java. Notre confrère Silicon a remarqué  que la société Scylla vient de réécrire Cassandra en C++. Cette mouture s'appelle ScyllaDB.

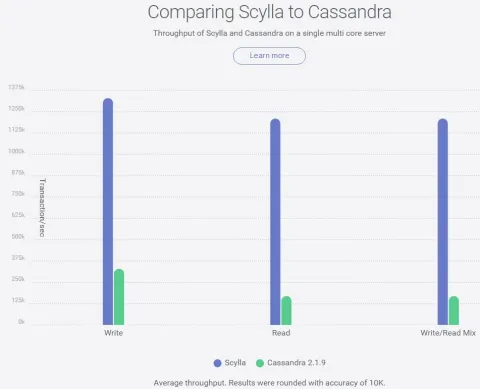
Scylla a publié un benchmark comparant ScyllaDB et Cassandra. Comme tous les benchmarks, il faut regarder les résultats avec un oeil critique. Cependant, ScyllaDB semble bien ridiculiser Cassandra sur le plan des performances.

Selon Scylla, ScyllaDB réalise jusqu'à 10 fois plus d'opérations par noeud que sa concurrente Cassandra. Un noeud ScyllaDB peut réaliser jusqu'à 1 million de transactions par seconde. Toujours selon l'éditeur, l'absence de ramasse-miettes permet de garantir un temps de latence au plus bas dans toutes les situations.

Cloud Bigtable un service de base de données NoSQL proposé par Google

Soumis par fredericmazue le
Image

C'est parce que les données sont de plus en plus importantes pour les entreprises et que cela ne fera que s'accroître avec l'Internet des Objets, explique Google, que le géant de l'Internet propose  son nouveau service Cloud Bigtable. A n'en pas douter c'est aussi pour se faire une place au soleil au milieu des nuages du cloud et pour concurrencer DocumentDB de Microsoft et DynamoDB d'Amazon que Google a mis en place Cloud Bigtable.

Cloud Bigtable est basé sur Bigtable qui est le système de base de données compressées orienté colonnes de Google. Un système de base de données NoSQL autrement dit. Mountain View l'utilise dans ses services comme Gmail ou Analytics.

Cloud Bigtable est, comme le nom l'indique parfaitement, Bigtable exposé sur le cloud de Google.

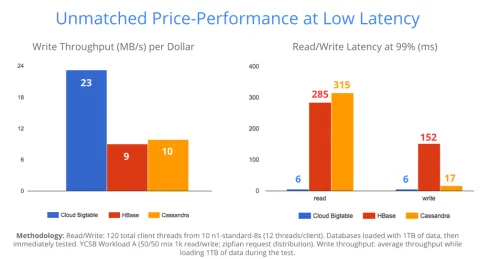
Bien sûr, il n'y a, à lire Google, que des avantages à utiliser Cloud Bigtable. Notamment des temps de latences qui cassent la baraque. Inférieurs à 10 millisecondes et des performances deux fois meilleures que HBase et Cassandra, qui sont, il faut le dire, des bases de données NoSQL inspirées de Bigtable.

Google insiste sur ses points forts. La maturité avec des applications critiques Google qui reposent sur Bigtable depuis plus de 10 ans. Un coût très faible, Mountain View dixit, pour un service de base de données gérées.

Google met encore en avant la simplicité. Reconfigurer un cluster Cloud Bigtable se fait en moins de 10 secondes depuis une interface d'administration Web. Les capacités de stockage grandissent automatiquement en fonction des besoins.

Enfin l'accès aux données de fait via l'API open source HBase qui est l'API d'Hadoop. Du coup cela permet d'importer des données depuis des clusters HBase, souligne encore Google.

Infotel recherche 120 nouveaux collaborateurs dans la région Ile-de-France

Soumis par fredericmazue le

Infotel recrute près de 300 nouveaux collaborateurs pour l’année 2015 sur tout le territoire français dont 120 postes dans ses agences parisiennes.

Les agences parisiennes d’Infotel (Bagnolet, Nanterre, Neuilly) permettront aux nouvelles recrues de se spécialiser au contact de grands comptes internationaux sur des technologies telles que la mobilité et le Big Data. La présence de sociétés comme Airbus, Air France, PSA Peugeot Citroën, BNP Paribas ou encore, l’Office Européen des Brevets, dans le portefeuille clients d’Infotel est le reflet d’une expertise de pointe.

« Avec plus de 13 agences en France, Infotel offre la flexibilité d’une entreprise locale et la force d’un groupe d’envergure nationale. Nous avons à cœur de faciliter l’insertion des jeunes dans le monde professionnel, c’est pourquoi, 50 % des recrutements en Ile-de-France seront des jeunes diplômés. Nous proposons également 25 stages de fin d’études » souligne Michel Koutchouk, Directeur Général d’Infotel.

120 postes en CDI sont à pourvoir dans les agences parisiennes Infotel.

Infotel propose des CDI, des stages de fin d’études ainsi que des formations pour les jeunes diplômés. Les annonces sont destinées à recruter des profils juniors ou plus expérimentés et correspondent aux métiers suivants : Ingénieur d’Études .NET (Asp.NET, C#, Sharepoint), Ingénieur d’Études Java JEE / HTML5 (AngularJS, Spring), Ingénieur d’Études Android (SDK Android, API Rest), Ingénieur d’Études iOS (Swift, Objective-C) et Ingénieur d’Études Big Data (Hadoop, Mongo DB, ElasticSearch).


La base de données NoSQL MarkLogic arrive en version 8

Soumis par fredericmazue le

MarkLogic Corporation annonce la nouvelle version de sa base de données NoSQL MarkLogic :  MarkLogic 8. MarkLogic 8 prend en charge JavaScript et JSON côté serveur et intègre aussi un ensemble de fonctionnalités comme la sémantique et le bitemporel. MarkLogic Bitemporal, souligne l'éditeur, permet aux entreprises de réduire les risques en observant l’évolution de la donnée en elle-même à partir de son enregistrement et tout au long de son cycle de vie.

MarkLogic permet aussi aux entreprises de déployer leurs premières applications MarkLogic dans le cloud grâce à une offre gratuite d'une durée d'un an de sa base de données Enterprise NoSQL sur les services web Amazon (AWS)- pour ses nouveaux clients.

L'éditeur de MarkLogic 8 met en avant ces nouvelles fonctionnalités :

  • Améliorations pour les développeurs : vitesse de développement accrue avec prise en charge native du JSON, format des données en pleine expansion. Exécution du code JavaScript près des données pour une puissance et une efficacité incomparables. Poursuivre avec JavaScript dans la couche métier avec le nouveau driver Node.js pour MarkLogic, ou tirer parti des nouvelles capacités de l'API client Java.
  • Bitemporel : Réduire le risque grâce à une technologie "Voyage dans le temps" – un horodatage et un possible retour en arrière sur les documents pour identifier les changements, ce qui est essentiel pour les entreprises régies par des réglementations afin de démontrer leur mise en conformité.
  • Sémantique : Trouver de nouveaux faits  et des relations nouvelles automatiquement dans des milliards de données, une fois stockées dans un format RDF (triple), ainsi qu’au support de « l’inférence » et au support élargi du langage SPARQL.
  • Et plus encore : De nouvelles API REST pour la gestion de la base de données, de nouvelles fonctionnalités sur la partie « Flexible Replication », une prise en main plus simple des développeurs et des temps de sauvegarde plus rapides.

NoSQL Matters Paris 2015

Soumis par fredericmazue le

Après le succès des conférences de Cologne, Dublin et Barcelone, la 8ème édition de la Conférence NoSQL Matters se tiendra à Paris les 26 et 27 mars 2015. Zenika, société de services informatiques spécialisée dans l’Open Source et les méthodes Agiles, s’associe à cette édition française en tant que Conference Partner.

Dédié aux développeurs, cet événement est une occasion unique d’échanger avec les experts du NoSQL et Big Data et d’approfondir ses connaissances grâce au format innovant de l’événement : une journée de formations et une autre de conférences.

“L’engagement de Zenika dans le NoSQL Matters Paris renforce sa présence dans l’écosystème du Big Data et NoSQL, et le positionne comme acteur reconnu de ces technologies”, déclare Carl Azoury, CEO de Zenika. “Cet événement s’inclut dans la stratégie orientée innovation de notre entreprise” ajoute Laurent Delvaux, Directeur Général de Zenika.

Une série de formations a lieu le jeudi 26 mars, au sein des locaux de Zenika. Adaptées à tous types de niveaux, elles vous permettront de découvrir de nombreuses technologies et notamment Apache Cassandra, Redis, Riak.

Acteur de référence dans la formation sur les technologies Open Source et Agiles, Zenika anime l’une d’entre elle. Arnaud Cogoluègnes, Directeur Technique de Zenika Lyon, présente le « Traitement batch sur Hadoop en un clin d'oeil ».

Les participants peuvent également s’inscrire à des conférences thématiques qui ont lieu le vendredi 27 mars au Tapis Rouge, en plein coeur de Paris. Cette 2ème journée sera marquée par l’intervention de Rob Harrop, CTO de Bamboo, qui fera un focus sur le NoSQL. Les participants pourront bénéficier, tout au long de cette journée, des retours d’expérience de plus de 15 intervenants français et internationaux sur les dernières tendances, développements et actualités du NoSQL et Big Data : cas pratiques clients (dont Amazon, Criteo, Google, Booking.com...) et démonstrations de technologies sont au rendez-vous.

Expert du Big Data, Bruno Guedes, Directeur Technique Zenika Paris, prendra la parole sur le thème « Hadoop realtime for dummies » et vous donnera les clés pour vous approprier les bases d’Hadoop.

Zenika vous donne également rendez-vous sur son stand, n’hésitez pas à venir rencontrer leurs équipes.

Pour plus d'informations sur la conférence NoSQL Matters Paris 2015, et pour vous y inscrire, rendez-vous sur le site internet de Zenika.

Cassandra au LorraineJUG

Soumis par fredericmazue le

Le Lorraine JUG (Java User Group de Lorraine) vous invite à prochaine conférence pour découvrir Cassandra en compagnie de Duy Hau DOAN et Michaël FIGUIERE.

Au programme de la soirée :

18:15 - Accueil et enregistrement

18:30 - Duy Hai DOAN et Michaël FIGUIERE

La présentation se découpe en 2 sessions.

    • la première session, 1h, est une présentation générale de Cassandra, de son modèle de données et les bonnes pratiques de modélisation: comment passer du monde SQL au monde NoSQL, par DuyHai DOAN
  • la deuxième session, 30 mins, présentera les outils pour aider le développeur Java à travailler efficacement avec Cassandra, par Michael Figuière

20:30 - Drink et tombola…

1 pass DEVOXX à gagner par tirage au sort pour les membres du LorraineJUG

30 septembre 2014, 18h30
TELECOM Nancy
193 avenue Paul Muller, 54602 Villers-lès-Nancy 

S'inscrire

Plus d'informations

Embarcadero met à jour ses outils de base de données

Soumis par fredericmazue le

Embarcadero Technologies annonce la nouvelle version majeure de sa gamme d’outils de base de données, qui comprend notamment ER/Studio, DBArtisan et Rapid SQL. Les nouveaux outils, d'après l'éditeur, répondent aux nouveaux enjeux liés à la gestion des données, tout en permettant une meilleure productivité sur un nombre élargi de systèmes de gestion de base de données (SGBD).

« Avec l’accroissement des volumes de données à un rythme exponentiel, les entreprises s’intéressent aux Big Data et systèmes NoSQL en corrélation avec les systèmes relationnel existants, afin de transformer leurs données en avantages compétitifs », commente Michael Swindell, vice-président senior en charge des produits chez Embarcadero. « Grâce au support du plus grand nombre de systèmes relationnels SGBD et de plateformes Big Data et NoSQL, la nouvelle gamme XE6 apporte des gains de productivité très importants aux administrateurs de bases de données, architectes données et développeurs SQL. »

Conçus pour les développeurs, les administrateurs de bases de données et les architectes, les outils Embarcadero permettent aux utilisateurs de concevoir, bâtir et lancer leurs bases de données et applications dans les environnements de leur choix. La gamme étendue XE6 fournit un nouveau support pour les principales plateformes, dont MongoDB, Hadoop Hive et PostgreSQL.

Disponibilité et versions d’essai

La gamme XE6 des outils de base de données, dont ER/Studio, DBArtisan et Rapid SQL, sont disponibles dès à présent auprès d’Embarcadero. Des versions d’essai sont téléchargeables à l’adresse suivante :

http://www.embarcadero.com/downloads

MongoDB propose enfin un support pour la version Community Edition de MongoDB

Soumis par fredericmazue le

Pour répondre aux demandes de sa communauté utilisateur, MongoDB vient de lancer Production Support, disponible à la vente en tant qu'offre unique et indépendante de la solution MongoDB Enterprise, permettant ainsi aux utilisateurs de Community Edition de bénéficier de l'aide des ingénieurs de talent travaillant pour l'écosystème MongoDB, pour résoudre leurs problèmes techniques.

Production Support propose aux utilisateurs de MongoDB Community Edition :

  • Un support de haute qualité 24h/24, 7j/7,  365 jours par an
  • Un SLA de 2 heures pour tout incident urgent
  • Des conseils et un support proactifs de la part des ingénieurs de la communauté

L'offre Production Support va donc au-delà du simple scénario « signalisation d'un problème / Résolution », puisqu'il propose des services de conseil et d'assistance proactifs de la part de son équipe qualifiée d'ingénieurs, sur des sujets aussi divers que variés.

Plus d'informations au sujet de cette nouvelle offre sont disponibles en ligne sur le blog de MongoDB.
