Arduino UNO Q : transformer la UNO Q en agent de codage avec Claude Code et Ollama
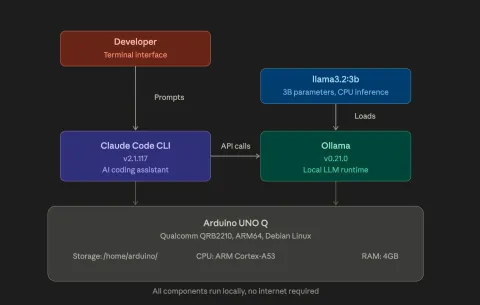
Voilà un PoC qui nous intigure : transformer sa Uno Q (Arduino) en agent de codage avec Claude Code Ollama. Il faut une version 4 Go, ce qui est déjà limite pour ce genre d'usage. L'idée est simple : faire un agent IA local avec Olloma et Claude Code.
A noter que nous avions eu le plus grand mal à installer proprement Ollama en janvier dernier.
Il faut :
- Uno Q 4 Go
- OS à jour
- installer Ollama 0.21.0
- Claude Code CLI (installation native)
- stockage paramétré pour améliorer les I/O
L'installation se fait depuis un ordinateur en connectant la Uno Q puis accès en remote.
1 / installation de Claude sur la carte
export CLAUDE_HOME=/home/arduino
export PATH="$CLAUDE_HOME/bin:$PATH"
puis les chemins permanents :
echo 'export CLAUDE_HOME=/home/arduino' >> ~/.bashrc
echo 'export PATH="$CLAUDE_HOME/bin:$PATH"' >> ~/.bashrc
2 / installation standard de claude : curl -fsSL https://claude.ai/install.sh | bash
puis which -a claude pour vérifer que tout soit bien installé.
3 / installation d'Ollama
curl -L https://github.com/ollama/ollama/releases/download/v0.21.0/ollama-linux-arm64.tar.zst -o /home/arduino/ollama.tar.zst
cd /home/arduino
tar --use-compress-program=zstd -xf ollama.tar.zst
chmod +x /home/arduino/ollama
puis on crée le bon répertoire : mkdir -p /home/arduino/.ollama/models
puis enfin, on déclare le bons paths :
echo 'export OLLAMA_MODELS=/home/arduino/.ollama/models' >> /home/arduino/.bashrc
echo 'export PATH="/home/arduino:$PATH"' >> /home/arduino/.bashrc
source /home/arduino/.bashrc
4 / il faut créer un service système Ollama :
sudo nano /etc/systemd/system/ollama.service
le contenu du fichier à créer :
[Unit]
Description=Ollama Service
After=network-online.target
[Service]
ExecStart=/home/arduino/ollama serve
Environment="OLLAMA_MODELS=/home/arduino/.ollama/models"
User=arduino
Group=arduino
Restart=always
RestartSec=3
[Install]
WantedBy=default.target
On quitte Nano et on suavegarde le fichier.
5 / vérification de la configuration du service :
sudo systemctl daemon-reload
sudo systemctl enable ollama
sudo systemctl start ollama
dernière vérification de la bonne installation : ollama --version
6 / on supprimer les fichiers inutiles : rm /home/arduino/ollama.tar.zst
7 / on installe llama3.2:3b puis on exécuter les commandes :
ollama
ollama run
8 / on utilise ollama avec claude : ollama launch claude
En cas de problèmes, rejouez :
rm /home/arduino/.local/bin/claude
ln -s /home/arduino/.local/share/claude/versions/2.1.117 /home/arduino/.local/bin/claude
chmod +x /home/arduino/.local/bin/claude
echo 'export PATH="/home/arduino/.local/bin:$PATH"' >> ~/.bashrc
source ~/.bashrc
et re- ollama launch claude
Bon codage. Attention : la Uno Q reste une carte aux performances limitées avec de fortes latences selon l'usage.
Source : https://projecthub.arduino.cc/AndreaRichetta/build-smarter-with-claude-code-ollama-on-uno-q-7c9660
P.S. : nous n'avons pas eu le temps de tester nous-même ce PoC