algorithme

Projet Nessie : un algorithme de manipulation des prix qui aurait rapporté 1 milliard de dollars à Amazon

Soumis par fredericmazue le

Lu sur The Verge. La Federal Trade Commission américaine (FTC) poursuit Amazon pour exploitation illégale de son monopole. Le document de plainte révèle de nombreuses pratiques déloyales comme le fait d'enterrer les offres proposées à des prix inférieurs par d'autres détaillants et facturer des frais élevés aux vendeurs afin de gonfler les prix des produits. 

Pour ce qui est de gonfler les prix, le document de plainte révèle l'existence d'un algorithme secret nommé en interne par Amazon « Projet Nessie » Cet algorithme ayant pour rôle d'identifier des produits spécifiques pour lesquels il est probable que d'autres boutiques en ligne suivront une augmentation de prix faite par Amazon. L"algorithme augmente alors les prix de ces produits et, surveillle si d'autres magasins emboîtent le pas. Si c'est le cas, algorithme maintient le prix plus élevé,ou, sinon, le rebaisse. Selon le document de plainte, Amazon a considéré le projet Nessie comme « un succès incroyable » ayant généré plus d'un milliard de dollars de profit excédentaire pour l'entreprise. Toutefois, consciente des retombées qu'elle risque, la société Amazon aurait désactivé le projet Nessie pendant des périodes de surveillance extérieure accrue, pour le réactiver aux moments où 'personne ne regarde'.

En plus de ce gonflage des prix, et toujours selon le document de plainte, Amazon dégrade volontairement les services qu'elle propose. Ainsi la vitrine en ligne d’Amazon donnait autrefois la priorité aux résultats de recherche pertinents et organiques. Suivant les instructions de son fondateur et alors PDG Jeff Bezos, Amazon a changé de vitesse pour remplir désormais sa vitrine de publicités payantes. Les dirigeants d’Amazon reconnaissent en interne que cela crée un « préjudice aux consommateurs » en rendant « presque impossible la conquête d’un contenu organique utile et de haute qualité par un contenu sponsorisé à peine pertinent ». Cette pratique nuit également aux vendeurs et aux acheteurs. La plupart des vendeurs doivent désormais payer pour la publicité afin d’atteindre la base massive d’acheteurs en ligne d’Amazon, tandis que les acheteurs sont par conséquent confrontés à des résultats de recherche moins pertinents et sont orientés vers des produits plus chers. Notamment, Amazon a augmenté non seulement le nombre de publicités diffusées, mais également le nombre de publicités indésirables non pertinentes, appelées en interne « défauts ». M. Bezos a demandé à ses dirigeants d'« accepter davantage de défauts », car Amazon peut extraire des milliards de dollars grâce à une publicité accrue, malgré la dégradation de ses services aux clients.
Twitter a ouvert le code de son algorithme de recommandation

Soumis par fredericmazue le

Twitter explique que son algorithme de recommandation à pour but de 'distiller' les 500 millions de Tweets publiés quotidiennement jusuq'à ce qu'une poignée des meilleurs Tweets pour un utilisateur s'affiche sur son appareil.

La base des recommandations de Twitter, est-il encore expliqué, est un ensemble de modèles et de fonctionnalités de base qui extraient des informations latentes des tweets, des utilisateurs et des données d'engagement. Ces modèles visent à répondre à des questions importantes sur le réseau Twitter, telles que "Quelle est la probabilité que vous interagissiez avec un autre utilisateur à l'avenir ?" ou, "Quelles sont les communautés sur Twitter et quels sont les Tweets à la mode en leur sein ?"

Twitter a ouvert le code correspondant qui est désormais disponible sur GitHub, ici et ici.

Ce code est sous licence BSD 3-Clause.

Nul doute que ce code intéressera de très nombreux informaticiens. Il n'a d'ailleurs pas fallu longtemps pour que certaines particularité sy soient remarquées.

Ainsi une utilisatrice de Twitter :-) a remarqué dans le codede surprenant critères de sélection des tweets. Le premier critère est de savoir si un tweet a pour auteur elon, comprendre Elon Musk, puis le code examine si l'utilisateur est un 'power user', pui ss'il est démocrates ou républicain...

x86-simd-sort : une bibliothèque de tri pour C++ signée Intel

Soumis par fredericmazue le

x86-simd-sort  est une bibliothèque de fichiers d'en-tête C++ pour le tri des types de données 16 bits, 32 bits et 64 bits basé sur SIMD sur les processeurs x86. Les routines de tri reposent uniquement sur la bibliothèque standard C++ et nécessitent un compilateur relativement moderne pour être construites (gcc 8.x et supérieur). Puisqu'ils utilisent le jeu d'instructions AVX-512, ils ne peuvent fonctionner que sur des processeurs équipés d'AVX-512. Plus précisément, les versions 32 bits et 64 bits nécessitent le jeu d'instructions AVX-512F et AVX-512DQ. Le tri 16 bits nécessite le jeu d'instructions AVX-512F, AVX-512BW et AVX-512 VMBI2. La suite de tests est écrite à l'aide du framework de test de Google.

Les idées et le code de cette bibliothèque sont basés sur des deux documents :

Tri sur place vectorisé rapide et robuste des types primitifs

Un nouvel algorithme de tri rapide hybride vectorisé à l'aide d'AVX-512 sur Intel Skylake 

x86-simd-sort est un logiciel libre sous licence BSD 3-Clause "New" or "Revised" License disponible sur GitHub. 

Swift dispose d'une nouvelle bibliothèque : Swift Algorithms

Soumis par admin le

L'équipe du langage Swift vient mettre à disposition le code d'un nouveau package : Swift Algorithms. L'ingénieur d'Apple Nat Cook le présente comme venant combler des lacunes de la bibliothèque standard de Swift.

Swift Algorithims expose des fonctionnalités similaires à celles de la bibliothèque itertools de Python ou la bibliothèque algorithms de C++.

Le package Algorithms comprend une multitude d'algorithmes génériques puissants que l'on trouve fréquemment dans d'autres langages de programmation populaires. Nous espérons que ce nouveau package aidera les gens à adopter les algorithmes, améliorant ainsi la qualité et les performances de leur code, souligne Nat Cook.

Le développement de Swift Algorithms n'en est qu'à ses débuts. La bibliothèque doit évoluer rapidement. Elle est toutefois déjà riche. On y trouve par exemple des algorithmes de combinaison, de permutation, d'unicité,  de produits... Plus clairement, l'algorithme produit permet d'itérer toutes les paires d'éléments de deux collections différentes. Par exemple :

let seasons = ["winter", "spring", "summer", "fall"]
for (year, season) in product(1900...2020, seasons) {
    // ...
}

// est équivalent à
for years in 1900...2020 {
    for season in seasons {
        // ...
    }
}

A remarquer aussi l'algorithme chunked, qui permet de diviser une collection en sous-séquences consécutives. L'exemple d'utilisation ci-dessous sépare un tableau en sous-séquences ascendantes :

let numbers = [10, 20, 30, 10, 40, 40, 10, 20]
let chunks = numbers.chunked(by: { $0 <= $1 })
// [[10, 20, 30], [10, 40, 40], [10, 20]]

Cet autre exemple d'utilisation recherche un changement dans la transformation de chaque valeur successive d'une collection. Vous pouvez l'utiliser pour séparer une liste de noms en groupes selon le premier caractère, comme ceci :

let names = ["Cassie", "Chloe", "Jasmine", "Jordan", "Taylor"]
let chunks = names.chunked(on: \.first)
// [["Cassie", "Chloe"], ["Jasmine", "Jordan"], ["Taylor"]]

Swift Algoritms est un logiciel libre sous licence Apache 2.0, disponible sur GitHub.

IBM Research s'apprête à dévoiler le premier algorithme d'IA capable de synthétiser les réseaux neuronaux profonds

Soumis par fredericmazue le

Lors de la conférence NeurIPS qui se tiendra le 8 décembre prochain à Vancouver, les scientifiques d'IBM Research dévoileront le premier algorithme d'IA capable de synthétiser les réseaux neuronaux profonds les plus efficaces pour classer des images provenant d’appareils connectés (maison intelligente, voitures autonomes).

Des milliards de dispositifs connectés déployant   de l’IA sont déjà utilisés aujourd'hui. Toutefois, selon Big Blue, leurs modèles traditionnels d'IA ne sont pas toujours conçus pour répondre aux contraintes spécifiques des dispositifs connectés. Ils sont par exemple limités par leur espace de mémoire, leur consommation énergétique ou encore leur temps de réaction.

Dans une voiture autonome par exemple, un réseau neuronal de pointe peut être en mesure d'identifier un humain traversant la rue la nuit avec grande précision. Cependant, l’identification de la personne prendrait probablement trop de temps pour prévenir un accident.

En se concentrant sur les contraintes de performance clés d'un cas d'utilisation donné, le nouvel algorithme d’IBM rationalise la recherche de modèles adaptés de réseaux neuronaux profonds. Sans avoir à utiliser des données d'apprentissage durant la phase de synthèse de l'algorithme. Dans le scénario d'une voiture autonome, les modèles de classification d'images synthétisées d’IBM fonctionneraient en quelques millisecondes, laissant suffisamment de temps au véhicule pour éviter un piéton.

Lors des tests effectués jusqu'à présent, la nouvelle recherche d'architecture de réseau neuronal profond s'est révélée capable de générer des modèles IA efficaces capables de fonctionner sur du matériel peu coûteux et d'atteindre une plus grande précision que les alternatives disponibles, souligne IBM Research. Cette technologie peut également s'appliquer à de multiples dispositifs connectés différents, offrant ainsi une nouvelle façon de rationaliser les systèmes back-end.

Alibaba Cloud rend disponible sa plateforme de machine learning algorithmique sur Github

Soumis par fredericmazue le

Alibaba Cloud annonce  que les principaux codes de sa plateforme algorithmique, Alink, ont été rendus disponibles en open source sur Github. La plateforme dispose d’une large gamme de bibliothèques d’algorithmes qui prennent en charge le traitement par lots et le traitement par flux, qui sont essentiel pour les tâches de machine learning comme la recommandation de produits en ligne et les services clients intelligents. 

Les data analystes et les développeurs de logiciels peuvent accéder aux codes sur Github pour construire leur propre logiciel, facilitant ainsi des tâches telles que l’analyse statistique, le machine learning, la prédiction en temps réel, la recommandation personnalisée et la détection d’anomalies.

« En tant que plateforme composée de divers algorithmes combinant l’apprentissage dans différents modèles de traitement de données, Alink peut être une option intéressante pour les développeurs à la recherche d’outils robustes pour le big data et le machine learning », a déclaré Yangqing Jia, President and Senior Fellow of Data Platform chez Alibaba Cloud Intelligence. « En tant que l’un des dix premiers contributeurs de Github, nous nous engageons à nous connecter avec la communauté open source le plus tôt possible dans nos cycles de développement logiciel. Partager Alink sur Github souligne notre engagement de longue date dans le domaine. »

Alink a été développé sur la base de Flink, un moteur de calcul unifié distribué. Basé sur Flink, Alink permet une unification transparente du traitement par lots et par flux, apportant aux développeurs une plateforme plus efficace pour effectuer des analyses de données et des tâches machine learning. Alink intègre non seulement les données stockées sur les systèmes d’Alibaba, mais aussi d’autres systèmes d’acquisition de données open-source, tels que Kafka, HDFS et HBase. 

Alink sur GitHub

Google Bert : Google déploie une mise à jour majeure de son algorithme de recherche

Soumis par fredericmazue le

Google commence à déployer, aux Etats-Unis et dans les pays anglophones pour commencer, une mise à jour de son algorithme de recherche. Cette mise à jour est, selon Google, le plus grand bond en avant des cinq dernières années et l'un des le plus grand saut dans l'histoire de Search. 

Ce nouvel algorithme s'appuie sur une nouvelle technologie baptisée BERT, pour Bidirectional Encoder Representations from Transformers. BERT, grâce au machine learning, est capable de comprendre les différents mots d'une recherche au sein d'une phrase plutôt que de manière isolée, ceci dans le but d'améliorer significativement la compréhension des requêtes naturelles. Les modèles BERT peuvent donc considérer le contexte complet d'un mot en regardant les mots qui le précèdent et le suivent, ce qui est particulièrement utile pour comprendre l'intention des requêtes de recherche, précise Google.

La technologie BERT semble plutôt gourmande en ressources. Google explique : Mais ce n’est pas uniquement grâce aux avancées logicielles que cela est possible: nous avions également besoin d’un nouveau matériel. Certains des modèles que nous pouvons créer avec BERT sont si complexes qu'ils repoussent les limites de ce que nous pouvons faire avec du matériel traditionnel. C'est pourquoi nous utilisons pour la première fois les derniers TPU Cloud afin de fournir des résultats de recherche et de vous fournir rapidement des informations plus pertinentes.

Les TPU, TPU pour Tensor Processing Unit, sont des puces développées par Google spécifiquement pour le machine learning. Google a construit, autour de ces puces, des supercalculateurs, les Cloud TPU Pods, et les utilise donc entre autres pour son moteur de recherche. D'après Google, ces supercalculateurs sont capables d'effecteur en quelques minutes ou quelques heures des tâches qui demandent des jours ou des semaines sur d'autres systèmes.

Google donne quelques exemples pour mettre en valeur les qualités de son nouvel algorithme. Ainsi : 2019 brazil traveler to usa need a visa. Le mot «to» et sa relation avec les autres mots de la requête sont particulièrement importants pour comprendre le sens. Il s'agit d'un Brésilien voyageant aux États-Unis, et non l'inverse. Auparavant, nos algorithmes ne comprenaient pas l'importance de cette connexion et nous avons renvoyé des résultats concernant les citoyens américains voyageant au Brésil. Avec BERT, Search est en mesure de saisir cette nuance et de savoir que le mot très courant «to» a beaucoup d'importance ici, et nous pouvons donc fournir un résultat beaucoup plus pertinent pour cette requête, souligne Google.

Projet Zipline : Microsoft ouvre son algorithme de compression sur Azure

Soumis par fredericmazue le

Comme tous les fournisseurs cloud, Microsoft est confronté au problème du stockage des données, qui sont toujours plus volumineuses.

Microsoft travaille à des solutions dans le cadre du projet Zipline. Ainsi Microsoft a développé un algorithme de compression de pointe et optimisée la mise en oeuvre matérielle.

L'algorithme de compression du projet Zipline donne des résultats nettement meilleurs, avec des taux de compression jusqu'à 2 fois plus élevés par rapport au modèle Zlib-L4 64 Ko couramment utilisé, indique Redmond, qui travaille parallèlement à des spécifications de conception matérielle.

Project Zipline est une technologie de compression de pointe optimisée pour une grande variété de jeux de données. Notre version RTL permet aux fournisseurs de matériel d’utiliser la conception de référence pour produire des puces matérielles permettant la compression la plus élevée, le coût et la puissance les plus bas, précise Microsoft.

Microsoft est en train d'ouvrir le code de cette algorithme, ainsi que les spécifications de conception matérielle. Le tout sera très bientôt disponible sur GitHub.

Algobrix : des briques de Lego pour apprendre à coder

Soumis par fredericmazue le
Image
Image

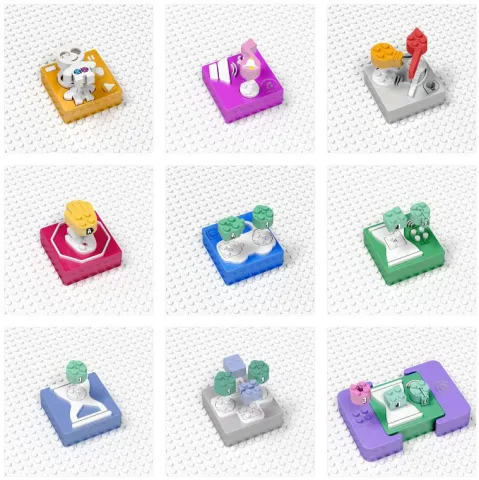
La start-up Algobrix révolutionne les Lego avec une gamme de produit consistant d'une part en des robots à construire et d'autre part en des blocs de fonctions à assembler pour commander les robots. Le tout formant un moyen d'initier les tous petits à la programmation et aux algorithmes (d'ou le nom Algo - Brix) de manière ludique. Ce projet, présenté sur KickStarter y rencontre un très gros succès, en réalisant une levée de fonds plus de 10 fois supérieure à ce qui était espéré.

Le choix de robots est assez riche

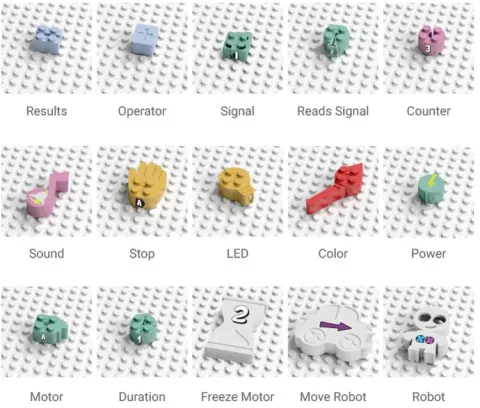
Les blocs de fonctions sont gros, colorés, faciles à manipuler. Ils sont ornés d'icônes décrivant clairement les fonctions : son, lumière, déplacement marche/arrêt, etc. Ainsi que des fonctions plus évoluées : attendre du signal d'un capteur, addition de deux nombre, boucle...

Ces blocs de fonctions sont réunis sur une plaque de Lego et ils peuvent recevoir d'autres blocs plus petits, qui eux aussi s'assemblent comme des briques de Lego et qui sont autant de paramètres aux fonctions.

La communication entre le robot et les blocs de fonctions se fait en Bluetooth.

Pour faciliter l'apprentissage des enfants, Algobrix fourni des cartes qui expliquent le rôle de chaque bloc et leur paramétrage.

Au final, l'enfant définit étape par étape les mouvements de son robot et définit ainsi de manière ludique un algorithme.

Les produits Algobrix sont compatibles avec les robots Lego EV3. Ils devrait être commercialisés à partir de 2018.

Site officiel : www.algobrix.com

[video:https://www.youtube.com/watch?v=o-bGJlvd23Y autoplay:0]

Google Guetlzi : un générateur d'images JPEG plus légères

Soumis par fredericmazue le
Image

Après avoir proposé Zopfli et Brotli, des algorithmes de compression de fichiers plus performants que Deflate, Bzip2 et autres, Google s'attaque au poids des images JPEG.

Ceci dans le but, dit Mountain View, de procurer la meilleur expérience aux internautes, et de permettre aux webmasters de créer des pages qui se chargent plus rapidement et qui requièrent moins de données.

Pour cela, Google propose Guetzli (qui est le nom d'un gâteau suisse allemand) un outil de génération d'image JPEG 35% plus légères que des images générées par les outils connus jusqu'ici. Bien sûr, les images ainsi générées sont compatibles JPEG et donc lisibles dans tout navigateur. Cette initiative semble plus heureuse que le format d'image WepP proposé en 2010 par Google et qui reste relativement peu utilisé, faute d'être suppporté par tous les navigateurs.

Guetzli, explique Google, travaille en trois étapes pour générer une image : transformation de couleurs, transformation cosinus discrète et quantification. Cette étape de quantification est le point fort de Guetzli. Il y introduit moins de pertes visuelles, tout en générant des images 35% plus légères. Guetzli établit un équilibre entre la perte visuelle et la taille du fichier au moyen d'un algorithme qui tente d'estomper les différences entre le modèle psychovisuel de JEPG et son modèle psychovisuel. Par contre, générer une image avec Guetzli prend plus de temps qu'avec les outils classiques, précise encore Google, sans donner de chiffres à ce niveau.

Guetzli est open source, disponible sur GitHub.


A gauche l'image d'origine,  au centre l'image JPEG classique générée par libjpeg, à droite l'image générée par Guetzli.

Commentaire actu

Anonyme (non vérifié)

Génial mais cette version ne gère pas le canal Alpha, utilise 300Mo et 1 minute CPU par million de pixels!  Vous imaginez passer 24 minutes pour compresser une image d'un appareil photo courant ? Lorsqu'actuellement ça se passe en moins de 30 secondes ?

Moi j'appelle ça une FBI! (Fausse Bonne Idée) 

mer, 22 Mar 2017 - 13:58 Permalien