algorithme

Des machines à sous dupées à l'aide d'un smartphone

Soumis par fredericmazue le

Aux Etats-Unis, nous apprend Wired, les machines à sous sont pilotées par un logiciel approuvé par le gouvernement qui assure un gain fixe au casino.

Seulement voilà, de nombreux casinos ont remarqué que certaines machines distribuaient aux joueurs plus d'argent qu'elles n'en recevaient d'eux, même sans accorder de jackpot, ce qui est normalement techniquement impossible.

Après enquête, il est apparu que des petits malins avaient trouvé le moyen d'exploiter le fait que les machines à sous ne sont pas régies par le hasard. Ils jouaient quelques pièces normalement - et donc perdaient normalement :-) - mais se faisant ils filmaient discrètement leurs parties et envoyaient les vidéos à leurs complices.

Ceux-ci analysaient les vidéos au moyen d'un algorithme puis renvoyaient aux joueurs, toujours au moyen du smartphone, des informations telles que le moment précis sur lequel appuyer sur les boutons de la machines. Par exemple le smartphone se mettait à vibrer exactement 1/4 de secondes avant le bon moment sur lequel appuyer sur le bouton. C'est d'ailleurs ainsi que les tricheurs ont été identifiés par les surveillants des casinos, en raison de l'activité très étrange et soudaine de leurs mains.

Des enquêteurs du ministère de la justice ont confisqué leurs smarthpones à des joueurs qui étaient des ressortissants russes.

Moralité : les machines à sous ne sont pas des jeux de hasard, ce qui veut dire que les casinos trichent avec, à coups d'algorithmes. Mais les joueurs eux n'en ont pas le droit :-) 
Edge supportera bientôt l'algorithme de compression Brotli

Soumis par fredericmazue le
Web

A l'automne 2015, et deux ans seulement après avoir proposé Zopfli, Google proposait un nouvel algorithme de compression sans pertes  open source : Brotli.

Alors que Zoplfi était présenté comme 3 à 8% meilleur que zlib, Google présentait Brotli comme 20 à 26% meilleur que Zopfli en ce qui concerne la réduction de la taille des contenus, tout en étant rapide et peu exigeant en ressources lors des phases de compression/décompression.

Brotli est donc intéressant pour la compression des données circulant sur Interent et de fait, au début de cette année, Google en annonçait le support dans son navigateur Google Chrome. Bien sûr il est nécessaire que Brotli soit également supporté côté serveur, mais c'est un autre sujet.

Dans un billet, Microsoft annonce emboîter le pas de Google pour amener le support de Brotli dans son navigateur Edge. Ceci pour une réduction substantielle du poids des pages débouchant sur une réduction de leur temps de chargement, sans surcoût CPU notable côté utilisateur, écrit Microsoft.

Ce support de Brotli dans le navigateur Edge est déjà actif pour les membres du programme Windows Insider. Pour le grand public, ce support viendra avec la prochaine grande mise à jour de Windows, en la personne de Windows 10 Creator’s Update, attendu pour le début 2017.

Mourrez vous dans un an ? Google aimerait le savoir

Soumis par fredericmazue le

« Nous pouvons dire quel patient décédera dans une semaine, six semaines ou un an », affirme Bill Frist, co-fondateur d’Aspire Health. Les algorithmes mis au point par cette société seraient capables de prédire quels patients atteints de maladies graves décéderont dans les 12 mois à venir.

Une information qui intéresse beaucoup Google, dont le fonds d'investissement Google Venture vient d'injecter 32 millions de dollars dans Aspire Health. Avec une injection comme ça, la société Aspire Health, elle, ne mourra probablement pas dans l'année ;-)

L'enjeu commercial est important : 150 milliards de dollars sont dépensés chaque année pour les soins des personnes dans leur dernière année de vie. Google veut savoir de qui il s'agit, pour gagner de l'argent en ciblant mieux ses publicités, ou en faire économiser à ses commanditaires.

En octobre dernier, quand Google a fait son injection de dollars, Bill Frist expliquait Aujourd'hui les patients atteints d'une maladie grave reçoivent souvent des soins mal coordonnés, non nécessaires et trop souvent pas en adéquation avec leur but et leur coût.

Et si l'algorithme se trompait ? Et la devise de Google Don't be evil dans tout ça ?

Expectra lance la compétition de coding C ou C++ « Jeux de rimes »

Soumis par fredericmazue le
Image

Expectra vient de lancer, en collaboration avec IttestsOnline.com la compétition de coding « Jeux de rimes », ouverte à tous les développeurs C ou C++ de France.

La compétition a commencé le 5 septembre et finira le 29 septembre, période pendant laquelle tous les développeurs français peuvent s’inscrire dans l’une des deux catégories : « Mission C », dédiée aux développeurs C, ou « Mission C++ », dédiée aux développeurs C++.

Il y aura un gagnant dans chaque catégorie et le grand prix sera une caméra vidéo GoPro Hero4 Silver ! Pour s’inscrire dans la compétition, les utilisateurs doivent savoir coder dans le langage de programmation C et, respectivement, C++.

Les développeurs candidats doivent écrire un algorithme en C ou C++ afin d’identifier les rimes, ainsi que le type de rime dans un texte !

La compétition de coding en ligne est organisée à l’aide d’ITtestsOnline.com, une plateforme gratuite d’évaluation en ligne des compétences IT, qui englobe des exercices algorithmiques et des tests techniques conçus pour les développeurs de logiciels du monde entier.

Pour vous inscrire dans la compétition ou pour en savoir plus sur la compétition de coding en ligne « Jeux de rimes » accédez au site de la compétition jusqu’au 29 septembre, le dernier jour de la compétition.

Microsoft place des composants de son moteur de recherche Bing en open source

Soumis par fredericmazue le

De plus en plus, Microsoft joue la carte de l'open source. Nous l'avons vu récemment par exemple avec l'ouverture du code de sa plate-forme .NET. Nous le voyons aujourd'hui avec l'ouverture de composants majeurs de son moteur de recherche Bing.

Ces composants sont BitFunnel, NativeJIT et Workbecnh

Sur son blog, Michael Hopcroft, un des ingénieurs de la première heure de Bing, explique comment BitFunnel est né et a évolué avec le temps. BitFunnel est une librairie hautes performances pour la recherche de texte sur Internet. Bitunnel travaille avec un algorithme probabiliste, pour classer les documents selon le contenu des requêtes : mots-clés, phrases et expressions mathématiques.

Au départ BitFunnel était une librairie sans dépendance, et elle l'est restée... dans l'esprit de Michael Hopcroft. En effet lorsqu'un chercheur lui avait demandé s'il pouvait travailler avec BitFunnel, Michael lui avait répondu 'bien sûr'. Et voulant l'aider pour cela, il a vite constaté que c'était devenu absolument impossible. En devenant open source le projet BitFunnel doit être épuré, dépouillé, et redevenir un moteur de recherche basique (bébé) utilisable pour tout un chacun. Une documentation, pour l'instant totalement absente, doit voir le jour également.

Un autre composant majeur est NativeJIT, une librairie de compilation Just-in-Time. Cette librairie C++ compile des structures de données de type C en faisant tout particulièrement attention à l'usage des registre du processeur, dans le code machine produit.

Enfin Workbench est un ensemble de librairies auxilliaires Java et Lucene pour BitFunnel. Pour la préparation du texte, notamment.

Les 3 projets sont sur GitHub.

Facebook s'inquiète d'une baisse des partages originaux

Soumis par fredericmazue le
Web

Selon un article de The Information Facebook se fait du souci en raison d'un fort recul des 'partages originaux'.

En clair, les 1,6 milliards de membres racontent de moins en moins leur vie sur le réseau social. -21% de partagesà caractère personnel entre le milieu de l'année 2014 et l'année 2015.

Globalement les partages baissent un peu, mais beaucoup moins : -5,5%. Les utilisateurs continuent de partager des vidéos, photos, et autres liens vers des articles mille fois vus et revus. Mais le manque d'apport personnel menace sérieusement de mettre à mal le modèle économique de Facebook qui repose sur un ciblage publicitaire personnalisé. Comment cibler quand il n'y a plus rien de personnel ?

Le phénomène peut s'expliquer de plusieurs façons. Tout d'abord, les utilisateurs semblent avoir de moins confiance en la capacité de Facebook (et des réseaux sociaux en général) d'assurer la confidentialité de leurs données.

Ensuite Facebook semble victime de son succès : trop de membres, trop d'amis, et un partage personnel qui peut être vu par trop de personnes. Les utilisateurs semblent être désormais davatange séduits par un Snapchat par exemple, qui permet des partages beaucoup plus restreints.

Facebook tente de réagir. Une équipe spécifique a été créée pour étudier la question. Le fameux algorithme du fil d'actualité a de nouveau été modifié, afin de donner plus d'importance aux contenus originaux. Une modification d'algorithme... Est-ce le remède ou est-ce le problème ? Il a souvent été reproché à Facebook de grenouiller à ce niveau, jugeant à leur place de ce que les utilisateurs voulaient voir dans leur fil d'actualités. Lorsque vous savez que vos amis verront d'abord des contenus sponsorisés, arbitraires, ou sélectionnés selon des critères sur lesquels vous n'avez pas la main, pourquoi écrire en vain les contenus personnels que vous auriez voulu leur adresser  ? 

PlaNet : un algorithme capable de déterminer l'endroit où une photo a été prise

Soumis par fredericmazue le
Image

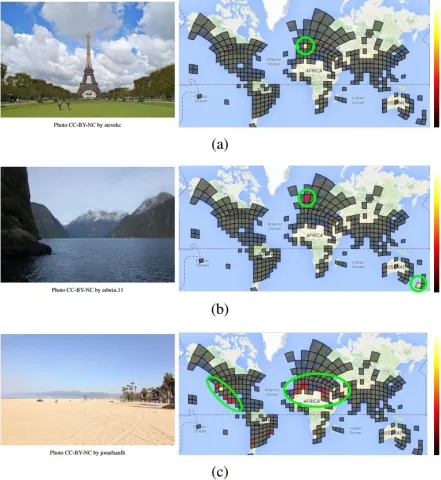
Google et ses puissants outils de deep learning travaillent, en collaboration avec une université d'Aix-la-Chapelle, à une tâche extrêmement difficile : déterminer où une photo a été prise, seulement en analysant celle-ci. Une recherche qui est décrite dans ce document.

Google a commencé par déterminer dans quels endroits du monde, la probabilité qu'une photo y soit prise est élevée. Ceci définit une zone qui a été subdivisée en 26 000 carrés. Après quoi, des millions de photos dont la géolocalisation est certaine ont été soumises au système et affectées à une zone. Le système se sert de cette base de données, lorsqu'on lui soumet une nouvelle photo. Par recoupement il détermine à quel endroit la photo a été prise, le résultat étant associé à une probabilité. Bien sûr, deep learning oblige, le système apprend et s'améliore au fil du temps.

A en croire Google, il ferait déjà mieux que les humains. Pour 3,6% des photos, il serait capable de dire jusqu'au nom de la rue dans laquelle la photo a été prise. Pour 10,1% des photos, il donnerait le nom de la ville. Il trouve le pays d'origine dans 28,4% des cas et le continent dans 48% des cas. Enfin quand le pifomètre de l'homme se trompe avec une erreur moyenne de 2320 km, PlaNet n'aurait qu'une marge d'erreur moyenne de 1131 km.

Twitter modifie sa timeline

Soumis par fredericmazue le
Web

Buzzfeed avait raison. C'est désormais officiel, Twitter modifie sa timeline. Jack Dorsey l'avait démenti à l'occasion du tollé que cela avait généré, mais cela n'a finalement rien d'étonnant. L'été dernier, le même Jack Dorsey déclarait que le timeline de Twitter était devenue obsolète.

Les tweets qui vous pourraient intéresser apparaîtront au sommet de votre timeline dit Twitter. Est-ce à dire que tous les autres tweets n'ont aucun intérêt ? ;-) La façon dont tel ou tel tweet est désigné comme susceptible de vous intéresser n'est pour l'instant pas donnée. Un algorithme sera au travail pour cela. Une douzaine de tweets 'intéressants' devraient donc se trouver regroupés en haut de la page.

Cette nouvelle fonctionnalité sera déployée et activée par défaut dans les semaines qui viennent. Cependant, les twittos curieux de voir ce que cela donne, auront rapidement la possibilité d'anticiper, en cochant une option 'Montrer les meilleurs tweets en premier' dans les paramètres de leur compte utilisateur.

Il pourront donc voir que Twitter commence à ressembler à Facebook ;-)

Google en train de devenir champion de Go ?

Soumis par fredericmazue le

Mettre au point un programme informatique capable de très bien jouer au Go est un challenge très difficile. Il est communément admis que le Go est un jeu beaucoup plus difficile à modéliser que le jeu d'Echecs.

En ce qui concerne les Echecs, IBM avec Deep Blue a obtenu un résultat remarquable en réussissant à battre le champion du monde Gary Kasparov il y a 20 ans. Depuis, les géants de l'informatique essaient de relever le défi du Go.

Facebook s'y essaie avec une approche originale : la reconnaissance de forme. Google, par la société britannique DeepMind qu'elle a rachetée en 2014, vient de s'illustrer à coups de réseaux neuronaux et de deep learning.

Là aussi l'approche est originale. Pas d'arbres de recherche avec élagage alpha-bêta comme il y en a dans d'autres programmes de jeux de réflexion dont les programmes d'Echecs. Selon un article publié dans Nature cette semaine, c'est un algorithme décrit comme généraliste qui travaille. Cet algorithme interprète des motifs de positions de jeu, d'une manière similaire à ce que DeepMind avait déjà fait pour jouer avec succès à 49 jeux d'arcade.

Par ailleurs, le programme de DeepMind joue sans cesse au Go contre lui-même des milliers de parties, ce qui lui permet de tirer des conclusions sur ce qui est ou n'est pas une bonne stratégie de jeu et ainsi, d'améliorer sans cesse son niveau.

Grâce à quoi, et en tournant sur un système doté de 1000 CPU, excusez du peu, Deep Mind a battu le champion d'Europe de Go Fan Hui dans un match sur un score impressionnant de 5 à 0. Cette rencontre s'est tenue dans le plus grand secret en octobre 2015. Etrangement ce succès de DeepMind a été tenu secret aussi.

DeepMind veut maintenant défier le champion du monde de Go, le coréen Lee Sedo. Demis Hassabis, co-fondateur de DeepMind se dit "assez confiant".

Mais s'attaquer au champion du monde de Go c'est encore tout autre chose. Lee Sedo lui aussi se déclare assez confiant : J'ai entendu dire que le système de DeepMind est étonnamment fort et qu'il ne cesse de se renforcer, mais je suis confiant et pense être en mesure de le battre au moins cette fois-ci" .

Une chose est certaine : la rencontre sera passionnante :-)

[video:https://www.youtube.com/watch?v=g-dKXOlsf98]

Comprendre l'algorithme Google Panda

Soumis par fredericmazue le
Web

Depuis quelques semaines, ou quelques mois, les webmasters constatent de nombreuses variations, parfois brusques et/ou importantes, dans les statistiques de fréquentation de leurs sites.

En décembre, nous évoquions une mise à jour 'Phantom 3', le terme de fantôme étant utilisé faute de mieux. Car Google est de plus en plus avare d'informations au sujet des modifications qu'elle apporte à son algorithme de recherche.

Penguin 4.0 devrait arriver vers la fin de ce mois de janvier. En attendant, Panda sévit :-)

Selon les spécialistes en référencement, les remous constatés en ce moment sont dus à la prise en compte des critères de Panda dans l'algorithme principal de Google. Même si Panda était déjà fortement influent auparavant. C'est l'avis de SearchEngineLand. C'est également l'avis de de TheSEMPost. Et cela semble crédible.

Pour mémoire, Panda est censé privilégier les contenus de qualité. Il doit descendre en flammes les fermes de contenus et plus encore les fermes de liens qui gonflent artificiellement le Page Rank d'un site.

D'ailleurs à terme le Page Rank doit totalement disparaître (depuis le temps que Google le dit...) Panda et son accolyte Penguin le remplaçant et dézinguant de concert les 'mauvais sites' cités plus haut.

Il est un fait que Panda, avant d'être intégré parmi les critères principaux, a fait des dégâts importants sur le trafic de certains sites. S'il est effectivement intégré dans les critères principaux, il est encore plus nécessaire de bien le comprendre. Pour cela, TheSEMPost vient de publier un excellent et très complet guide. Vous y trouverez des conseils quant aux contenus que vous devez supprimer (ou pas), aux contenus que vous devez modifier. Vous trouverez des conseils pour l'intégration des publicités, pour la gestion des sections à contenus potentiellement pauvres comme les forums, etc. A ne pas manquer si vous êtes webmaster.