NVIDIA

BlueField : NVIDIA étend le support des DPU à Red Hat et Mirantis
Soumis par francoistonic le
IA
Image

Un des enjeux de l'IA est le hardware et particulièrement les processeurs dédiés déployés dans les datacenters. NVIDIA est le leader des GPU mais possède aussi une solide gamme de processeurs spécifiques tels que BlueFiled, un DPU, Data Processing Units. Le DPU est là pour traiter des volumes de données importants. Pour NVIDIA, c'est donc un enjeu important. Red Hat a annoncé le support de ce DPU dans OpenShilft. 

Cette approche, qui permet d’isoler les applications d’IA et les charges de travail d’infrastructure (services réseau et sécurité, par exemple) exécutées sur BlueField, offre les avantages suivants :

  • Utilisation optimisée des ressources : la plateforme Red Hat OpenShift s’appuie sur une fonction de gestion intelligente des ressources pour délester les services réseau entre l’unité centrale (CPU) et le processeur de traitement des données (DPU), libérant ainsi des ressources pour les charges de travail d’IA tout en optimisant la consommation de ressources. 
  • Amélioration de la sécurité : Red Hat OpenShift on BlueField transfère les tâches d’infrastructure vers le processeur DPU et contribue à réduire la surface d’attaque des applications grâce à une approche multicouche qui améliore efficacement la posture de sécurité.
  • Réseau cloud avancé : Red Hat OpenShift, avec ses capacités de routage distribué optimisées par BlueField, contribue à améliorer la sécurité de la mutualisation, l'évolutivité du réseau, les performances et l'efficacité du trafic entre les clusters, tout en rationalisant les opérations réseau.

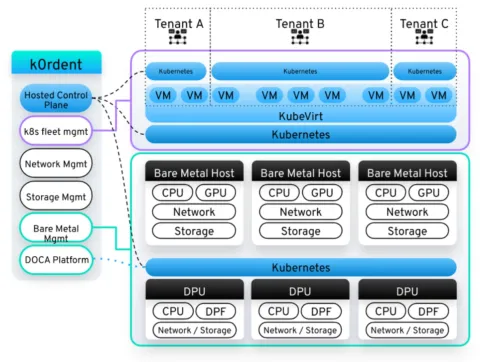
Mirantis, acteur important de l'écosystème Kubernetes, a aussi annoncé le support de BlueField. « Les charges de travail d’IA exigent de la précision, grâce à du hardware spécialisé, un réseau étroitement intégré, une multi-tenance sécurisée et un provisioning en temps réel, le tout orchestré efficacement et à grande échelle », déclare Shaun O’Meara, Chief Technology Officer chez Mirantis. « Grâce à l’intégration de Mirantis k0rdent AI et des NVIDIA BlueField DPUs, nous apportons un Kubernetes multi-tenant avec une isolation stricte à tous les niveaux, capable de prendre en charge des réseaux et des exigences d’isolation complexes, tout en offrant à chaque tenant un accès complet à son cluster Kubernetes. »

Pour l'éditeur, plusieurs avantages :

- Multi-tenance sécurisée pour concilier partage des ressources et isolation stricte ;

- Souveraineté des données adaptée aux workloads IA manipulant des modèles propriétaires et des données confidentielles ;

- Partage des GPU et ressources de calcul clés ;

- Isolation réseau avancée au niveau des interfaces, assurant que chaque tenant n’accède qu’aux VLAN et interfaces qui lui sont assignés ;

- Accès haut débit aux environnements de stockage.

Si pour l'utilisateur, le développeur, cela risque relativement transparent, pour un éditeur, ce support exige de nombreuses optimisations pour réellement s'appuyant sur les DPU.
DGX Spark : John Carmack est déçu par les performances de la machine

Soumis par francoistonic le

NVIDIA a sans doute de grandes ambitions pour son DGX Spark, et les autres machines reposant sur ce modèle (par exemple chez Dell et HP). Le fondateur promet beaucoup pour 3 999 $ : un supercalculateur sur son bureau pour faire de l'IA local. John Carmack, un des développeurs les plus respectés, à qui nous devons Doom, a testé le DGX Spark et il pointe 2 défauts :

- des performances pas aussi élevées qu'attendues

- une surchauffe importante

Il a publié son avis sur X. Tout d'abord, il pointe avec étonnement une consommation électrique ne dépassant pas 100 Watts, ce qui étonne car officiellement la machine est censée pousser à 240 Watts. Ce plafonnement bride de facto la puissance délivrée car il n'y a pas assez d'énergie pour alimenter les composants... Carmack estime que le Sparck délivre la moitié des performances annoncées : 60 TFLOPS au lieu des 125 teraflops. Serverthehome affiche un peu moins de 200 watts mais n'arrive jamais aux 240 watts. Carmack dit même que chez certains utilisateurs, le Spark reboote tout seul, sans doute à cause de la température élevée qui désactibilise le système.

Comme le note les testeurs, NViDIA utilise le structured sparsity. Cette fonctionnalité permet d'accélérer les calculs en écarter les valeurs nulles. Mais cette spécificité est réellement exploitée par des usages très précis et optimisés. Une des raisons de la différence de performances pourrait venir de cette subtilité technique...


Dell Pro Max : un mini-PC dédié à l'IA

Soumis par francoistonic le
Image

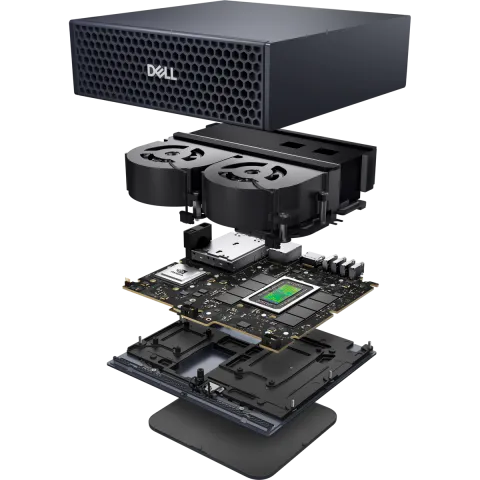
Dell annonce l'arrivée, très prochaine, du Pro Max avec GB10. Il s'agit d'un "PC" spécifiquement designé pour l'IA local. Le design est compact et reprend la philosophie du DGX Spark de NVIDIA. Il embarque le Grace Blackwell de NVIDIA et DGX OS. Il est doté de 128 Go LPDDR5x de mémoire unifiée, permettant de prendre en charge des modèles allant jusqu’à 200 milliards de paramètres et peut atteindre 1000 TOPS en FP4.

Il embarque CUDA, PyTorch, TensorRT, AI Workbench. Il est possible d'utiliser des LLM de plus de 70 milliards de paramètres. 

Les specs annoncées sont taillées pour l'IA :

- NVIDIA GB10, 20 coeurs

- 128 Go de mémoire unifiée (directement sur le SoC), non extensible

- jusqu'à 4 To de stockage NVMe

- Ethernet 10 Gb/s, Wifi 7

- connectique : HDMI, 3 ports USB-C

- DGX OS (basé sur Ubuntu)

- port ConectX-7 Smart NIC pour connecter un 2e système Dell Pro Max

Le tarif France n'est pas connu, mais sans doute aux alentours de 3 000 €.

OpenAI : NVIDIA investit 100 milliards, Microsoft temporise

Soumis par francoistonic le
Image

OpenAI et NVIDIA ont annoncé un accord stratégique : le fondeur va investir 100 miliards $ dans OpenAI. Le deux partenaires annoncent le déploiement d'une puissance de calcul de 10 gigawatts avec les plateformes NVIDIA. La course aux datacenters IA est relancée. 

Les premiers déploiements devraient intervenir dès mi-2026. OpenAI utilisera Vera Rubin de NVIDIA. Les datacenters seront construits au fur et à msure. La puissance totale doit atteindre les 10 gigwatts d'ici 2030. L'accord est à la fois financier et technologique. NVIDIA fournira les composants et GPU nécessaires. Pour OpenAI, la puissance de calcul est le nerf de la guerre. Le créateur de ChatGPT cherche à réduire sa dépendance à Microsoft. 

Les relations avec Microsoft se sont tendues dès le printemps dernier. Si un accord non contraignant a été signé, rien ne semble réellement réglé. Microsoft a investi plus de 13 milliards depuis 6 ans. Si l'éditeur a fait des concessions, il ne veut pas lâcher OpenAI. Microsoft aurait jusqu'à 30 % de la future société OpenAI. OpenAI accélère son développement et multiplie les accords. Il y a quelques jours, OpenAI et Oracle ont annoncé un énorme contrat sur 5 ans : 300 milliards $ pour une puissance de calcul de 4,5 gigawatts dès 2027.

Notre avis : que ce soit avec Oracle ou avec NVIDIA, OpenAI réduit sa dépendance envers Azure et Microsoft en construisant son infrastructure. L'infrastructure était le point faible d'OpenAI. Pour préparer son avenir et être capable de rivaliser avec les futurs géants de l'IA, OpenAI ne pouvait pas rester sans datacenters mais il faut des investissements colossaux et une expertise technologique qu'ils ne possèdent pas. Du côté de Microsoft, il y a la volonté de rentabiliser l'investissement déjà réalisé tout en cherchant à réduire l'importance des LLM GPT. 

NVIDIA : backdoor or not backdoor sur les H20

Soumis par francoistonic le

C'est LA saga de l'été : les Etats-Unis, la Chine et NVIDIA au milieu... Le 14 juillet, il fut annoncé que le fondeur allait reprendre la vente des H20 IA, des GPU dédiées à l'IA. Il s'agit d'une variante du modèle H100. Pour ce faire, NVIDIA doit se conformer aux restrictions américaines. Le fondeur avait publié un post sur une visite de Jensen Huang et d'une intense négociation avec le gouvernement américain. "Huang a également informé ses clients que NVIDIA déposait des demandes pour la commercialisation du GPU NVIDIA H20. Le gouvernement américain a assuré NVIDIA que les licences seraient accordées, et NVIDIA espère commencer les livraisons prochainement. Enfin, Huang a annoncé un nouveau GPU NVIDIA RTX PRO, entièrement conforme, « idéal pour l'IA de type jumeau numérique dans les usines et la logistique intelligentes »." expliquait le post officiel. Mais une confusion semble régner dans la réalité de la licence d'exportation qui n'aurait pas encore été donnée à NVIDIA.

Pour le fondeur, la Chine est un marché stratégique et l'embargo sur les GPU les plus puissantes pénalise NVIDIA et favorise la montée en puissance des puces chinoises. 

Depuis, des rumeurs de portes dérobées intégrées aux puces ont circulé... La Cyberspace Administration of China évoquait fin juillet des doutes sur la sécurité des "nouvelles" puces H20 et de la possibilité de l'existence de backdoors. Le fondeur a été interrogé et affirme qu'il n'y a aucune porte dérobée dans les puces.

Fin juillet, l'administration américaine a émis l'idée d'implémenter dans les puces IA les plus avancées un contrôle de localisation pour vérifier le lieu d'exploitation du composant et éviter toute localisation non autorisée. Le congrès soutient cette recommandation. Pour le moment, une telle obligation n'a pas été déposée, ni votée. 

RTX AI : utiliser les cartes RTX pour coder et faire de l'IA

Soumis par francoistonic le

Les GPU RTX sont les plus utilisées pour le gaming. Mais elles peuvent aussi servir à autre chose : faire de l'IA localement et du développement ! Avec RTX AI, NVIDIA veut montrer comment utiliser et exploiter les cartes graphiques en dehors des jeux. Grâce à la puissance des GPU, vous pouvez faire de inférence ou même entraîner des LLM localement et utiliser des outils IA ou de Vibe Coding sur sa machine. 

Pour NVIDIA, RTX AI a plusieurs avantages :

- utilisation sans limite ou presque

- réponse plus rapide (pas besoin de cloud)

- totalement hors ligne

- usage privé

Plusieurs assistants de codage sont optimisés pour RTX : Continue.dev, Tabby, OpenInterpreter, Ollama (outil que nous avons récemment présenté sur programmez.com). Ces outils peuvent exploiter les cartes RTX. NVIDIA évoque des perfomances jusqu'à 5 à 6 plus rapides qu'en utilisant une CPU. 

Pour aller plus loin : https://blogs.nvidia.com/blog/tag/rtx-ai-garage/

NVIDIA pousse l'IA en Europe, avec un soupçon de quantique

Soumis par francoistonic le
Image

Jensen Huang, le patron de NViDIA, était à Paris mercredi 11 juin. Sans détour, Huang voit l'avenir de l'IA en Europe et de rappeler les ambitions du fondeur. NVIDIA peut fournir les infrastructures nécessaires pour créer cette dynamique. " Nous avons désormais une nouvelle industrie, une industrie de l’IA, et elle fait désormais partie de la nouvelle infrastructure, qui sera utilisée par chaque pays, chaque société », a déclaré Huang, s’adressant à un public réuni dans l’emblématique Dôme de Paris." explique le CEO.

Bien entendu pour aider et développer cette Europe de l'IA, Nvidia met en avant ses GPU, particulièrement la GB200 NVL72, taillée pour l'IA. Plus de 1 000 systèmes GB200 peuvent être construits par semaine. Et cette scène, il a rappelé que Nvidia travaille étroitement avec les entreprises européennes, les Etats, les scaleurs et les opérateurs télécoms pour accéléder sur l'IA et... le quantique. Sur le quantique, il est amusant de constater qu'il y a encore quelques semaines, il ne croyait pas réellement à la révolution quantique. Maintenant, il n'hésite plus à le mettre en avant... Il cite que la plateforme CUDA-Q sur le supercalculateur Gefion (Danemark). 

« L'informatique quantique atteint un point d'inflexion », a déclaré Huang. « Nous sommes sur le point d'appliquer l'informatique quantique, et l'informatique quantique classique, à des domaines susceptibles de résoudre des problèmes intéressants dans les années à venir. » précise Huang.

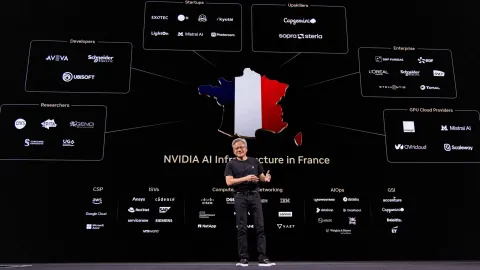
Comme pour appuyer sur le côté incontournable de Nvidia, le CEO montre les multiples accords et le déploiement des technologies Nvidia dans la recherche, les développeurs de jeux, les ESN, les scaleurs... Il montre une carte de la France qui résume bien la place centrale du fondeur.

Il rappelle aussi les annonces des derniers mois en France autour de l'IA. "« La France s'engage à investir dans l'IA pour renforcer notre économie, servir nos citoyens et défendre nos valeurs », a déclaré Emmanuel Macron, président de la République française. « En travaillant en étroite collaboration avec les plus grands innovateurs technologiques de notre pays et NVIDIA, nous fournissons aux chercheurs, aux entrepreneurs et aux institutions publiques les outils dont ils ont besoin pour explorer de nouvelles idées, relever des défis complexes et contribuer à façonner l'avenir de l'IA en France. ». Il rappelle aussi comment Mistral AI et Nvidia travaillent ensemble. Et qu'une infrastructure de 18 000 GPU Grace Blackwell sera déployée par Mistral d'ici 2026.

Si aujourd'hui, l'IA pousse les GPU et les SDK, Huang regarde vers demain. La prochaine vague pourrait être la robotique. Les plateformes IA de Nvidia peuvent s'intégrer dans les robots. 

UALink : un protocole d'interconnexion pour GPU au coeur des datacenters IA

Soumis par francoistonic le

Un des défis de l'IA est d'utiliser au mieux la puissance de calcul des GPU installées dans les datacenters. UALink (pour Ultra Aceelerator Link) a l'ambition de proposer une solution ouverte et interopérable. La version 1.0 du protocole était attendue depuis plusieurs mois. Elle a été définie par un consortium soutenu par AMD, AWS, Broadcom, HPE, Google, etc. pour créer une alternative au NVLink de NVIDIA. UALink a donc l'ambition de pouvoir créer des réseaux (Ethernet) de GPU interconnectées à faible latence. Ce protocole est taillé pour les usages intensifs de l'IA.

La version 1.0 permet d'utiliser une bande passante de 200 Gbps, tout en utilisant des GPU, des TPU et même des FPGA ou tout autre composant haute performance. Ces accélérateurs peuvent alors être connectées entre eux pour créer de véritables réseaux que les applications pourront exploiter (à condition de les adapter et de disposer du hardwave requis). 

Les objectifs d'UALink sont claires :

- améliorer l'efficacité des connexions bidrectionnelles entre la mémoire et la bande passante disponible pour les données

- réduire le coût des infrastructures Ethernet actuels en utilisant le matériel déjà déployé

- réduire la complexité logicielle

Les spécifications 1.0 définit une vitesse de transfert de 200 Gb/s maximum par ligne. Il est possible de déployer  4 lignes UALink par atteindre une bande passante théorique de 800 Gb/s. NVIDIA a bien compris que ce nouveau protocole est un concurrent direct à son NVLink. Le fondeur a annoncé qu'il ouvre les interconnexions vers des composants non-NVIDIA... 

Attention : une vulnérabilité dans NVIDIA Container Toolkit mal corrigée

Soumis par francoistonic le

NVIDIA avait corrigée la vulnérabilité CVE-2024-0132 avec un joli score de 9 dans le niveau critique. La correction se révèle incomplète et permet, en cas d'exploitation réussie, de mettre les données en danger. Cette faille permet d'avoir un accès non autorisée d'un conteneur. La vulnérabilité avait été dévoilée en septembre 2024 et rapidement patchée. Trend Micro a vérifié la résolution et conclut que le fix proposé n'est pas complet et qu'une faille est toujours présente. 

Elle concerne Docker sur Linux et permet de faire un déni de service. La faille est numérotée CVE-2025-23359. Plus grave, cette faille peut exposer les infrastructures et les données. Trend Micro a publié une analyse de la faille et propose même un exemple d'utilisation. 

En attendant une correction complète, Trend Micro conseille :

- réduire les accès API Docker

- désactiver tout ce qui n'est pas essentiel

- mettre en place un contrôle d'accès plus strict

- faire un audit des conteneurs et des interactions avec le système

Pour en savoir plus : https://www.trendmicro.com/en_us/research/25/d/incomplete-nvidia-patch.html

NVIDIA ouvre totalement PhysX

Soumis par francoistonic le

PhyX est un puissant framework / SDK pour la modélisation et la simulation en prenant en compte la physique des éléments. Il permet de reproduire la physique d'un objet, d'un système, d'un élément. Ces simulations exigent de la puissance de calculs et une implémentation profonde de la physique réel. NVIDIA cible les usages dans la robotique et les systèmes autonomes.

PhysX est disponible sur GitHub. En plus de PhysX, le SDK inclut : Flow et Blast. FLow est une librairie dédiée aux fluides. Blast est une librairie de GameWorks destruction qui remplace le module APEX Destruction. A noter que l'accélération GPU est incluse dans cette ouverture. 

Portail officiel : https://developer.nvidia.com/physx-sdk