Cloud

NABD Conference 2018 : du réel pour apprendre

Soumis par francoistonic le

Cette semaine, Criteo organisait sa Not Another Big Data Conference. Si l’accent était mis sur les ateliers, une matinée était réservée aux sessions générales et les interventions se sont succédées à un rythme élevé la 2e journée.

Pour nous réveiller, Guillaume Bort a parlé « Making Criteo Functional ». Comme ça, on se demande : ah ouais c’est quoi ? Scala a été le thème principal. Au départ de Criteo, les technologies étaient .Net, SQL Server, mais après quelques années, Hadoop, Java se sont imposés. Rapidement, les langages fonctionnels ont été considérés et particulièrement Scala. Ce langage fonctionnel s’est imposé chez Twitter. La plateforme avait besoin d’une forte montée en charge et de disponibilité. À cela se rajoutent les problèmes liés aux Big Data, vu la quantité de données traitées. Scala c’est imposé. Mais Scala ne s’invente pas : il faut des outils, du monitoring. Aujourd’hui, il existe de nombreuses librairies pour Scala : Doobie, Cats, FS2. Elles permettent d’étendre Scala et surtout de faciliter son intégration son SI. Doobie permet l’accès aux données.  FS2 fait du streaming I/O. Pour la partie outil, les développeurs Criteo utilisent IntelliJ qui supporte parfaitement Java et Scala, mais ce support ne va pas sans problème parfois… Il a fallu un temps d’adapter. Pour la partie Big Data, Spark est compatible avec le langage. 

Mais comme Criteo a une forte culture Java, pourquoi ne pas fusionner Java et Scala ? L’opération a donné ScaVa, en s’appuyant sur la pile technologie Scala de Twitter avec les mêmes piles pour les données (Finagle, Scalding, Algebird).

Passer les développeurs d’un langage impératif à un langage fonctionnel n’est pas toujours évident. Au départ, il a fallu avoir un hybride entre les deux modèles puis de passer au modèle fonctionnel. Et l’éditeur a commencé à attirer les développeurs fonctionnels et notamment avec des profils très différents (OCaml, F#, Haskell). Ces compétences, que Criteo n’avait pas, ont permis d’étoffer les bonnes pratiques internes. 

Il faut oublier les mauvaises pratiques et les anciens patterns. Ce qui n’est pas forcément évident.  

Plusieurs outils ont été développés pour compléter l’outillage Scala tel que Cuttle, un scheduler pour Scala ou encore Slab pour créer des tableaux de bord de monitoring. 

On enchaîne avec Justin Coffey « From Just a Bunch of Engineers to Data Reliability. L’ingénierie de données est cruciale pour Criteo et il faut des experts. Un des problèmes est de savoir comment monter en charge et étendre les clusters. Le data engineering est une discipline à part entière, tout comme le data reliability engineering (DRE). Chez Criteo, le DRE est apparu avec les problèmes de BI lorsque Hadoop a commencé à s’imposer, mais il manquait parfois d’outils et de bonnes pratiques. Et il fallait gérer les actifs en production et assurer la transition vers Hadoop. Ce qui n’allait pas sans difficulté avec la croissance de la charge et que les premières casses infrastructures sont apparues. Il fallait fixer en attendre la casse suivante. Avec une infrastructure aussi énorme de Criteo, il fallait comprendre comment aller au-delà des limites des outils. Le fonctionnel a aidé à le faire avec les notions de l’idempotente, la gestion du changement des données, la capacité à rejouer les données et les scénarios liés. Il a fallu pour ça maîtriser MapReduce, Spark, le stockage par colonne, les architectures SGBD, les systèmes distribués. Cette ingénierie a permis de résoudre les charges de données. Avec toujours en ligne de mire : la scalabité, la garantie de la disponibilité, le tout en incluant de la data visualisation. Le rôle de SRE (Site Reliability Engineering) prend tout son sens avec l’expertise du code, l’automatisation des déploiements et l’opérationel des serveurs. 

La session promettait beaucoup avec son titre “Lies, Damn Lies and benchmarks”. Hakan Jakobsson évoque les problématiques de performances et comment les mesures concrètement. Il faut donc parler de benchmark, mais dans le monde de la donnée rien n’est simple comme il va nous le rappeler. Aujourd’hui, une référence dans le monde serveur et des données est le TPC et les multiples déclinaisons telles que les TPC-H et TPC DS. Car finalement, comment comparer et mesurer Hortonworks et Cloudera ou Hive et Impala ? Quel rôle du benchmarking ?

“Nous jurons que nous avons fait de mieux pour être juste avec notre concurrent” ou encore “notre solution a toujours l’avantage dans l’expertise des performances”. Vous l’aurez compris, le benchmark en données est un sujet sensible et durant 30 minutes, on prend conscience du problème depuis la fin des années 1970… 

Ainsi, on apprend, si vous ne le savez pas déjà, qu’il existe des clauses non divulgations de benchmarks sans autorisation de l’éditeur, ni de citer explicitement le nom des SGBD dans des travaux universitaires. C’est la clause DeWitt du contrat d’utilisation. Oracle va réagir un benchmarking qui n’est pas à l’avantage de leur base, c’est le début de cette fameuse clause. 

Le TPC va alors tenter d’établir des règles pour faire un benchmarking capable de comparer les SGBD. L’industrie y est très impliquée depuis son apparition fin des années 1980. Cette présence n’est pas sans influence sur les protocoles de tests et les critiques seront régulières sur les capacités réelles des tests à aller loin dans le stress des systèmes. 

Le conseil : créer son propre benchmarking quand c’est possible.

On termine les sessions plénières avec Matthieu Blumberg qui évoque “The concrete reality of the cloud”. Comme évoqué plus haut, au départ, Criteo utilisait des centaines de serveurs SQL Server, de la BI sur SQL Server, mais rapidement les limites des bases ont commencé à se faire sentir. Puis, Hadoop est arrivé. Un premier POC fut monté avant de généraliser. En 2011, Criteo avait environ 1000 serveurs, aujourd’hui, on dépasse les 25 000 ! Et il fallait supporter les fortes latences, une disponibilité délicate et le coût des infrastructures. 

En 2015, il y avait -3000 serveurs Hadoop, fin 2017, on est à 15 000 pour plus de +1 exaoctets de données à gérer, stocker, analyser. 

L’infrastructure est au cœur de Critéo. Aujourd’hui plusieurs datacenters dédiés sont déployés dans le monde et d’autres vont suivre. Le cluster doit fonctionner 24/7 avec la plus faible latence réseau possible. Le déploiement généralisé de Hadoop a obligé à redésigner une grande partie de l’infrastructure sur les nœuds, le réseau, l’énergie. Il faut penser le câblage des datacenters, utiliser au mieux les espaces.

Pour faciliter le travail, une véritable datacenter factory a été créée pour automatiser tout ce qui est possible avec les ingénieurs, les responsables de l’exploitation et les outils comme Ansible. 

Autre aspect parfois méconnu, le capacity planning, bref la planification. Prévoir les charges et les décharges est un élément important pour éviter tout stress inutile aux datacenters. Il faut pouvoir prévoir la saisonnalité, adopter les capacités disponibles, gérer les maintenances, etc. L’analyse du trafic est en temps réel avec x points d’accès, des datacenters partout dans le monde. L’improvisation n’a pas sa place. 

François Tonic
Build 2018 : De l'Intelligence artificielle pour Visual Studio, les drones, l'IoT

Soumis par fredericmazue le

Microsoft a donné, mardi 7 mai, le coup d'envoi de sa conférence développeurs Build 2018 par une keynote de Satya Nadella, en compagnie de Scott Guthrie et Mark Russinovch, responsable Azure. La présence de dernier, si besoin était, montre que Microsoft est plus que jamais engagé sur le cloud.

Cette keynote d'ouverture a donc mis l'accent sur les services Azure, mais dans un contexte omniprésent d'intelligence artificielle et de machine learning.

L'ère du nuage intelligent et des objets intelligents est arrivée, a souligné Satya Nadella, PDG de Microsoft. Ces avancées créent des opportunités incroyables pour les développeurs et s'accompagnent également de la responsabilité de s'assurer que la technologie que nous construisons est digne de confiance et qu'elle profite à tous.

A la suite de quoi d'importantes annonces ont été faites présentant de nouveaux outils et moyens pour les développeurs :

  • Microsoft ouvre le code du Runtime Azure IoT Edge afin de donner à ses clients plus de contrôle sur les applications de périphériques
  • Custom Vision fonctionne désormais sur Azure IoT Edge, ce qui permet à des périphériques tels que des drones et des équipements industriels de prendre des mesures critiques rapidement sans nécessiter de connectivité au cloud. Il s'agit du premier service Cognitive Azure à prendre en charge le déploiement en périphérie.
  • DJI, une des plus grandes société de drones au monde, s'associe à Microsoft pour créer un nouveau SDK pour les PC Windows 10, et a également choisi Azure comme fournisseur de cloud pour faire évoluer ses solutions de drones commerciaux et de SaaS. Le SDK apportera des fonctionnalités complètes de contrôle de vol et de transfert de données en temps réel à près de 700M d'appareils connectés à Windows 10 dans le monde. Dans le cadre du partenariat commercial, DJI et Microsoft vont co-développer des solutions tirant parti d'Azure IoT Edge et des services d'IA de Microsoft pour permettre de nouveaux scénarios dans l'agriculture, la construction, la sécurité publique et plus encore.
  • Microsoft a annoncé un effort conjoint avec Qualcomm Technologies pour créer un kit de développement de vision AI utilisant Azure IoT Edge. Cette solution met à disposition les principaux matériels et logiciels nécessaires pour développer des solutions IoT basées sur des caméras. Les développeurs peuvent créer des solutions qui utilisent les services Azure Machine Learning et tirer parti de l'accélération matérielle disponible via la plate-forme Qualcomm Vision Intelligence et Qualcomm AI Engine. La caméra peut également alimenter des services Azure avancés, tels que l'apprentissage automatique, l'analyse de flux et les services cognitifs, qui peuvent être téléchargés depuis le cloud pour s'exécuter localement en périphérie.
  • Microsoft a encore annoncé Project Kinect pour Azure, un ensemble de capteurs, dont une caméra de profondeur de nouvelle génération, avec calcul intégré conçu pour AI on the Edge. En s'appuyant sur l'héritage de Kinect qui est passé par HoloLens, Project Kinect pour Azure permet de nouveaux scénarios pour les développeurs travaillant avec l'intelligence ambiante.

Microsoft ne pense malgré tout pas qu'au cloud. D'autres annonces concerne les développeurs qui ne travaille pas sur le cloud. Mais même là, l'Intelligence artificielle, donc le cloud, n'est jamais très loin. Par exemple Microsoft a annoncé Visual Studio IntelliCode qui est une nouvelle fonctionnalité qui améliore le développement logiciel au quotidien grâce à la puissance de l'IA. IntelliCode fournit des suggestions intelligentes pour améliorer la qualité et la productivité du code, assure Redmond, et est disponible en avant-première aujourd'hui dans Visual Studio.

L'événement Build 2018 s'étendant sur 3 jours, nous nous retrouverons très bientôt pour d'autres annonces Microsoft   

Azure Sphere OS : plusieurs puces et des conteneurs

Soumis par francoistonic le

Il y a quelques jours nous avons évoqué Azure Sphere et le partenariat avec Mediatek, avant d’autres annonces. Sphere OS doit être vu comme la continuité du travail réalisé sur Azure IoT Hub et certaines briques de ce dernier se retrouve dans l’OS annoncé. Un des freins restent la sécurité et le focus du projet est justement la sécurité. Comme nous l’a précisé Christopher Plieger de Microsoft France, Microsoft ne fabrique pas les puces mais l’architecture a été réalisée par l’éditeur. En réalité la plateforme embarque un SoC complet côté de deux processeurs ARM :

- Cortex A pour exécuter les applications et les services Linux

- Cortex M, deux coeurs, pour les autres tâches et notamment tout ce qui est I/O et le temps réel.

Cette approche est intéressante pour éviter de charger inutilement le processeur. A cela se rajoute un élément essentiel pour la sécurité : le coprocesseur Pluton, désigné par Microsoft. Pluton est une enclave de sécurité embarquée, Ce coprocesseur assure un boot sécurisé et il permet de crypter les communications et l’IoT et les services Azure ainsi que l’authentification. Une clé cryptée est présente dans cette enclave et est unique à chaque SoC.

Une question est de savoir pourquoi un noyau Linux et non pas Windows ? La réponse est claire : Windows n’est pas modulaire, ni assez petit pour pouvoir tenir sur des SoC aussi réduits. Linux, étant à l’aise avec les conteneurs et avec son côté hautement modulaire, a été choisi pour Sphere OS. D’autre part, Linux est très présent dans l’embarqué et les IoT. Il s’agit aussi d’une logique marché.

Sphere OS est un Linux en partie redéveloppé et adapté aux besoins et contraintes des IoT.

Le système propose 4 couches séparées : security monitor, noyau Linux, services de conductivités et le conteneur applicatif et conteneur applicatif temps réel (côté I/O). On peut rajouter une 5e couche, la plus basse : le matériel.

Et tout est compartimenté. Grosso modo, une couche = 1 conteneur. Il est intéressant de constater que Sphere OS propose des mécanismes de mises à jour. Oui il sera possible de mettre à jour le système et les applications embarqués dans l’IoT. Tout sera géré par le security monitor. Ce monitoring servira aussi à remonter les anomalies, les tentatives d’attaques, etc. La télémétrie permettra de suivre le comportement de l’IoT.

Sphere OS et les SoC embarquant l’OS se destinent à l’industrie et aux OEM pas aux utilisateurs ni aux développeurs. Les premiers SDK / kits de développements devraient être disponible durant l’été. Les premiers IoT et le lancement officiel sont prévus vers la fin de l’année. Les tarifs ne sont pas encore connus. On parle de quelques centimes pour les SoC. Le prix est un élément crucial dans l’IoT.

Azure Sphere a l’ambition de simplifier la conception et le déploiement en masse d’IoT, tout en assurant la sécurité et la connectivité.

Côté développement, ce qui est fonctionne sur IoT Hub fonctionnera sur ces SoC. Visual Studio supportera les projets Sphere OS.

François Tonic

Azure Sphère : une meilleure sécurité et un OS IoT basé sur Linux !

Soumis par francoistonic le

Microsoft vient de dévoiler un nouveau service Azure : Sphere. Avec un monde connecté, partout, tout le temps, la sécurité est un enjeu crucial. Le constat n’est pas nouveau. Cette sécurité concerne le cloud, bien entendu, mais aussi les IoT et les architectures locaux de type Edge Computing. Et là, les enjeux sont énormes car les IoT se multiplient, parfois de manière anarchique et la sécurité n’est pas forcément la priorité pour les constructeurs. En Edge, la sécurité doit être du même niveau que celui des fournisseurs cloud. Mais aussi on connecte la voiture, le téléphone, la maison, son frigo, etc. d’où l’exigence de sécurité. 

Sphere cible donc les infrastructures Edge et les IoT, allant du microcontrôleur (MCU) au cloud. Sphere a l’ambition de sécuriser ce fameux microcontrôleur, donc être au plus près du matériel. Microsoft décline trois points essentiels :

  1. Sphere colle aux dernières générations de MCU. Ainsi les fondeurs et constructeurs pourront utiliser et être compatible Sphere.
  2. Nouveau OS dédié aux IoT. Il repose sur un noyau Linux
  3. Sphere fonctionne aussi bien en cloud privé que public

Pour la première fois, Microsoft package et sort un système basé sur Linux et non un noyau Windows ! C’est une petite révolution ! Azure Sphere OS est taillée pour la sécurité et les IoT. C’est un système temps réel pour les plateformes microcontrôleurs actuelles. La stratégie annoncée est claire : créer un écosystème du silicon autour de cette offre. 

Pour le moment, seul Mediatek va inclure Sphere et l’OS Sphere dans ses puces. 

L’approche dévoilée par Microsoft ressemble aux démarches faîtes par Amazon et Google, avec respectivement FreeRTOS et Android Things. Things apparait tout de même de plus haut niveau que ceux de Microsoft et Amazon.

François Tonic

Oracle annonce Autonomous Data Warehouse Cloud, un service cloud de base de données auto-géré, auto-sécurisé et auto-réparable

Soumis par fredericmazue le

A l’occasion d’un événement organisé par Oracle, Larry Ellison, Oracle Executive Chairman & CTO, annonce la disponibilité du premier service basé sur Oracle Autonomous Database, la nouvelle base de données d’Oracle. Présenté comme un service cloud de base de données auto-géré, auto-sécurisé et auto-réparable, Oracle Autonomous Data Warehouse Cloud utilise l’apprentissage automatique (ou Machine Learning) pour atteindre sans intervention humaine les plus hauts niveaux de performance, de sécurité et de disponibilité du marché selon Oracle

« Cette technologie change tout » a ainsi déclaré Larry Ellison. « Oracle Autonomous Database est conçu à partir d’une technologie aussi révolutionnaire qu’Internet. Elle se patche, se règle et se met à jour toute seule. Les bases de données d’Amazon coûtent plus cher et font moins. »

Oracle détaille ainsi ces fonctionnalités phares 'auto' :

  • Auto-gestion. Suppression des interventions et des erreurs humaines pour la mise en œuvre, la sécurisation, la surveillance, la sauvegarde, la récupération, la réparation et l’optimisation de la base de données. Application automatique des mises à niveau et des correctifs sans interruption du fonctionnement de la base de données.
  • Auto-sécurisation. Protection contre les attaques externes et les utilisateurs internes malveillants. Application automatique des mises à jour de sécurité sans interruption du fonctionnement pour protéger la base de données contre les cyberattaques, et chiffrement automatique de toutes les données.
  • Auto-réparation. Protection automatique contre tout arrêt prévu ou non avec une disponibilité atteignant 99,995%, soit moins de 2,5 minutes d’arrêt par mois en comptant la maintenance planifiée.

Microsoft veut deux milliards de joueurs sur son cloud et être le Netflix du jeu vidéo

Soumis par fredericmazue le

Les jeux vidéo sur le cloud sont dans l'air du temps. En France, la société Blade propose Shadow qui permet de jouer ligne sur le cloud. Google travaille avec Ubisoft à une architecture cloud dédiée au jeux vidéo. Microsoft n'entend pas être en reste sur ce marché.

Un marché qui semble gigantesque... Selon The verge, Microsoft crée une nouvelle division : Cloud Gaming. Cette division sera dirigé par Kareem Choudhry qui a une solide expérience sur Outlook, DirectX et Xbox.

Lors d'une interview accordée à The Verge, Microsoft a clairement expliqué vouloir se poser comme un Netflix du jeu vidéo. Cloud Gaming devant se comprendre comme jeu à la demande. Nous pensons qu’il y aura deux milliards de joueurs dans le monde et notre objectif est de tous les atteindre souligne Kareem Choudhry.

Sur sa plate-forme Cloud Gaming, Microsoft devrait proposer les jeux les plus récents, et bien sûr les plus gourmands en puissance de calcul. Les joueurs pouvant jouer avec de modestes terminaux (et une bonne connexion internet) les calculs étant déportés sur le cloud de Microsoft.

Modestes terminaux ne signifie seulelent pas de vieux PCs de bureau poussifs. Microsoft veut Cloud Gaming partout : PCs, consoles, smart TVs et smartphones : Nous étudions des moyens de mettre le contenu à la disposition de tous, peu importe la plateforme utilisée précise Kareem Choudhry

Google et Ubisoft développent une architecture cloud dédiée aux jeux vidéo : Agones

Soumis par fredericmazue le
Image
Image

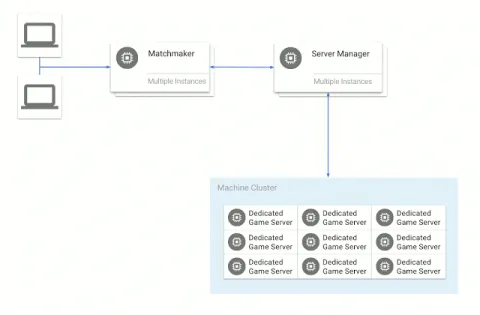
L'hébergement et la mise à l'échelle de serveurs de jeux dédiés aux jeux massivement multi-joueurs en ligne présentent des défis uniques, explique Google dans son billet présentant Agones.

Les serveurs de jeu dédiés sont des applications avec état qui conservent la simulation du jeu complète en mémoire. Mais contrairement à d'autres applications avec état, telles que les bases de données, leur durée de vie est courte. Un serveur de jeu dédié fonctionne pendant quelques minutes ou quelques heures. Les serveurs de jeux dédiés ont également besoin d'une connexion directe à un processus de serveur de jeux en cours d'exécution, hébergeant IP et port, plutôt que de s'appuyer sur des équilibreurs de charge (load balancer). Ces jeux au rythme rapide sont extrêmement sensibles à la latence, ce qu'un équilibreur de charge ne fait que rajouter.

Tels sont les défis techniques à relever, et pour Google, il n'est pas Il n'est pas surprenant que la gestion de la charge d'un serveur de jeu soit effectuée par un logiciel propriétaire, la plupart des systèmes d'orchestration n'étant  tout simplement pas conçus pour ce type de charge de travail.

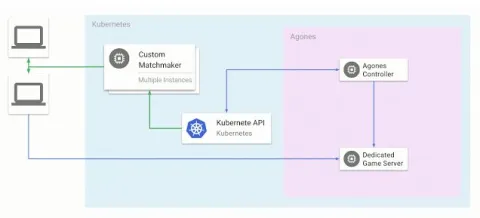
La bibliothèque open source Agones, développée conjointement par Google et Ubisoft est conçue pour remplacer les solutions de gestion des clusters et de montée en charge des serveurs de jeu avec un cluster Kubernetes qui inclut un contrôleur Kubernetes personnalisé et des définitions de ressources personnalisées GameServer correspondantes .

Avec Agones, Kubernetes obtient des capacités natives pour créer, exécuter, gérer et mettre à l'échelle des processus de serveur de jeu dédiés au sein des clusters Kubernetes en utilisant des outils et des API Kubernetes standard. Ce modèle permet également d'interagir directement avec Agones via l'API Kubernetes pour provisionner un serveur de jeu dédié.

Agones est une solution open source présentée comme étant agnostique, ce qui signifie qu’elle peut tourner sur un cloud public, mais aussi sur site ou sur une infrastructure hybride. Mais Google saura probablement attirer les éditeurs vers son cloud :-)

: « Agones nous aide en nous offrant la flexibilité d'exécuter des serveurs de jeux dédiés de manière optimale et en donnant à nos équipes plus de contrôle sur les ressources dont elles ont besoin » déclare Ubisoft.

Agones est sur GitHub.

Le cloud de Tesla utilisé par des pirates pour miner de la cryptomonnaie

Soumis par fredericmazue le

Le minage de cryptomonnaie est une activité en vogue. Le problème est qu'elle nécessite des moyens matériels très importants pour être un peu rentable. Dans ce cas, pourquoi ne pas utiliser l'ordinateur de quelqu'un d'autre, ou bien mieux, le cloud de quelqu'un d'autres ?

Les malwares qui minent de la cryptomonnaie à l'insu des internautes sévissent partout sur le web, mais cette fois les pirates ont vu les choses en grand. Pour cela il se sont introduits dans un compte Amazon Cloud de Tesla., qui avait laissé trainer une console Kubernetes sans protection par mot de passe. Ce sont des chercheurs travaillant pour RedLock qui ont découvert le pot-aux-roses :

"Nous n'étions pas les premiers à y parvenir [dans le cloud Amazon de Tesla]", a déclaré Varun Badhwar, PDG et co-fondateur de RedLock. "De toute évidence, quelqu'un d'autre avait lancé des instances qui exploitaient déjà la crypto-monnaie dans cet environnement particulier de Tesla." indiquent les chercheurs.

RedLock a immédiatement prévenu la firme Tesla, qui a corrigé la faille. RedLock a ainsi remporté un prix de 3000dollars dans le cadre du programme de Bug Bounty mené par Tesla dont un porte-parole a déclaré « nous menons un programme de Bug Bounty pour encourager ce type de recherches, et nous avons corrigé la faille en quelques heures après l’avoir apprise. L’impact semble limité aux voitures de test utilisées en interne, et notre enquête préliminaire n’a montré aucune fuite de données sur la vie privée de nos utilisateurs, ou la sécurité de nos véhicules. »

Source : Fortune

Suse Expert Days 2018 : niveau 300 pour mieux maîtriser les outils SuSe

Soumis par francoistonic le
Image

Rien ne vaut une bonne petite conférence technique de niveau 200-300 pour découvrir et maîtriser les outils et techniques. SUSE proposait début février une petite journée de rattrapage pour évoquer de nombreux sujets autour des solutions de l’éditeur Linux : la version 15 de l’édition entreprise, sécurité et gestion des systèmes, CaaSP, cloud privé avec la distribution openstack maison, PointText, stockage avec CEPH, cluster et haute disponibilité. Bref, un bonheur pour responsables d’infrastructure. L’amphi était quasi plein malgré le froid et la neige. Sur scène, ce sont les responsables techniques et les ingénieurs, et quelques développeurs (si, si) qui ont assuré le spectacle. 

La partie SUSE Manager était très intéressante. Il s’agit de la solution pour gérer les infrastructures SUSE via les scripts ou les interfaces graphiques. Si vous faites de l’infra as code, l’outil fonctionne avec SALT, l’environnement Infra as Code disponible sur SUSE. La prochaine version arrivera en juin et proposera de nombreuses nouveautés sur les conteneurs, le monitoring, la conformité. La version 3.2 apporte le support de SLE15, du SSO, du monitoring Prometheus et Grafana, du build de VM avec Salt et KIWI. La v4 (vers fin 2019 ?) sera uniquement compatible SLE15 et tous les composants seront des conteneurs. 

Mais une des grosses actualités de SUSE est la sortie de SUSE Linux Enterprise Server 15 qui sera disponible en juin 2018. Cette version ciblera les infrastructures d’entreprises classiques et les infrastructures définis par logiciel (SDI). Cette version supportera les architectures X86-64, Power, System Z, ARM64 que se soit en local, virtualisation, en hébergement et en cloud. On y retrouvera en vrac : noyau 4.12, GCC 7, Gnome 3.26, de nouveaux mécanismes de haute disponibilité (comme cluster en RAID 10), un nouvel annuaire (389-DS à la place d’openLDAP), OpenJDK 9, etc. Bref, une nouvelle version stratégique pour SUSE qui doit remplacer l’actuelle version 12. La v12 aura droit à deux nouveaux services packs (SP4 et SP5) en 20018 et 2019. Le SP1 pour SLE15 arrivera l’an prochain. Les enjeux de la v15 sont l’approche multitude, installation unifiée, la modularité accrue. Les modules ne seront pas tous identiques à chaque version. De base, nous avons les fondations système, les applications, la Haute Disponibilité, les applications serveur, les performances, les outils de développement, les conteneurs, les fonctions cloud public. 

Pour plus d’infos : https://www.suse.com/betaprogram/sle-beta/

La sécurité est bien entendu un point important et SUSE ne pouvait pas ne pas en parler, il s’agissait de la session sécurité et gestion des systèmes. La partie gestion est assurée par le Software Defined Infrastructure et la livraison des applications. Plusieurs outils rentrent en action : SUSE Manager, SUSE OpenStack Cloud Monitoring et la partie Public Cloud. La partie livraison se fera sur la plateforme CaaS et SUSE Cloud Application Platform (le PaaS de SUSE). 

Pour chaque attaque ou crash plateforme, SUSE propose des solutions pour mieux sécuriser les infrastructures et assurer la continuité :

- attaque massive sur le stockage et indisponibilité des sites : utilisation de Kubernetes et Portus

- attaque sévère WanaCry et NotPetya : utilisation de ceps et de SQL Server Linux

- etc.

Sur les failles processeurs, là aussi, SUSE se veut rassurant sur Spectre et Meltdown. 

Nous avions parlé de Salt. Salt est pour SUSE la pierre angulaire de l’infrastructure as code maison. Aujourd’hui, SALT c’est 7 ans d’existence, +600 contributeurs, plusieurs millions de téléchargement. Un des objectifs est d’apporter le moins d’adhérence possible dans les modèles d’infrastructure, d’être très flexible dans les déploiements et la production, de supporter tous les systèmes serveurs importants du marché. Les experts ont rappelés plusieurs points importants sur SALT :

- système basé sur des événements - réponses

- une gestion très dynamiques des noeuds

- la possibilité de coder en yawl, jinja et python

Personnellement, la session qui nous a le plus intéressé est celle sur OpenQA et plus précisément CaaSP. L’exemple donné était de faire de l’intégration et livraison continue avec les outils SUSE (et non-SUSE) pour mettre en place le développement, le build, le test et le déploiement. On passera par un référentiel Git, du Jenkins pour la partie intégration et build, puis une bonne couche de tests, dans l’outil OpenQA, directement relié à Jenkins et aux outils de déploiement. SUSE propose en effet plusieurs outils très intéressants :

- Open Build Services pour réaliser des builds à la chaine et reproductibles, avec du packaging automatique et la génération d’images. La génération d’images est réalisée par l’outil KIWI. 

- OpenQA est un outil pour les tests au niveau OS pour tester l’installation, la configuration, la migration. Il est utilisé dans SLE et openSUSE. Il teste les composants de l’OS et il peut tester l’interface graphique. 

Sur la partie purement CaaSP (plateforme conteneur), l’approche de SUSE se fait sur 3 segments :

- orchestration avec Kubernetes

- système dédié microservice et conteneur avec SUSE MicroOS

- configuration avec Container Engines et Salt

Sur la partie cloud privé, SUSE mise sur OpenStack et propose sa propre distribution. Le cycle d’évolution est annuelle, avec un support de 2 ans pour chaque version, et bientôt 3. La v7 permettait de supporter +300 noeuds, le support de Cisco ACI. Pour renforcer son offre Cloud, SUSE a beaucoup racheté de sociétés et de compétences : les compétences HPE d’OpenStack, de CloudFoundry et des services PaaS ! Actuellement, SUSE vit une transition entre OpenStack Cloud 7 et HPE Helion OpenStack 5. L’éditeur veut faire converger les deux distributions sur une unique solution : le futur SUSE OpenStack Cloud 8. Cette v8 supportera la version Pike d’OpenStack, MariaDB pour le SGBD, nouvelle version de RabbitMQ, architecture x86_64 / s390x / ARM (prévision technique uniquement) mais pas de PowerPC. apparition d’OpenDaylight et d’opennfv.

Sur la partie infrastructure, on parlera forcément de stockage. Pour SUSE, on parlera de stockage distribué avec ceph et l’ensemble des services Enterprise Storage (stockage objet / fichier / bloc, x86/ARM, disques standard, etc.). SUSE se positionne sur la partie données d’entreprise et la sauvegarde et restauration. Pour se faire, SUSE implémente Ceph qui permet de gérer le stockage dans son ensemble, de l’unité de stockage au monitoring. Il propose même des fonctions d’auto-réparation en cas de défaillance sur un OSD (Object storage daemon). Si le sujet vous intéresse, consultez d’urgence la session jouée : https://www.slideshare.net/ElisaPortefaix/suse-expert-days-paris-2018-softwaredefined-storage-et-gdpr

Nous retrouverons très prochainement sur les différents outils SUSE dans le magazine.

François Tonic

Google pourrait se lancer dans le streaming de jeux vidéo

Soumis par fredericmazue le

Ceci selon les informations de The Information. Les jeux vidéo sont un très gros marché, et il semble bien que Google en veuille sa part. Google prépare, selon The Information, un service similaire à PlayStation Now (Sony) ou GeForce Now (NVIDIA). Nom de code : Yeti.

L'idée est de permettre aux gamers de jouer en streaming sur Internet, plutôt que de devoir acheter les jeux sur un support physique, ou même les télécharger, et sans même avoir une grosse configuration matérielle. La startup française Blade propose une solution similaire avec Shadow.

Moyennant une bonne connexion à Internet, les gamers pourront donc s'abonner à ce service cloud qui a sans doute l'ambition de devenir le Netflix du jeu vidéo.

Quid du matériel ? Alors qu'avec Shadow, on peut utiliser son vieux PC, sa tablette ou même un téléviseur Android, Google pourrait fournir une sorte de console pour son service Yeti, selon The Information qui souline que le projet Yeti serait piloté par deux responsables de la branche hardware de Mountain View