SEO

Penguin 4.0 fait désormais partie du coeur de l'algorithme de Google et travaille en temps réel

Soumis par fredericmazue le
Web

Comment l'entreprise Google définit-elle les critères de classement servant à positionner une page parmi d'autres résultats ? Globalement c'est un mystère qui donne des cheveux blancs à bien des webmasters.

Google donne toutefois quelques indications générales. L'algorithme de Google prend en compte plus de 200 indicateurs tels que les mots spécifiques qui s'affichent sur les sites Web, la fréquence d'actualisation du contenu, la région, etc.

Un de ces critères est Penguin. Pour mémoire, Penguin est un filtre dont la tâche est de pénaliser les liens présents dans les fermes de contenus, ou les 'mauvais liens' supposés  avoir été achetés uniquement pour augmenter artificiellement l'ancien PageRank que Penguin remplace. Certains sites se sont vus pénaliser jusqu'à 40% de leur trafic par Penguin, et l'animal étant loin d'être infaillible, ils ne s'agissait pas toujours de sites malpropres sur eux.

Malheureusement revenir d'une pénalité infligée par Penguin était jusqu'ici très difficile, notamment parce que celui-ci ne travaillait pas en temps réel. Cela signifie que lorsqu'un webmaster améliorait son site, Penguin n'en tentait compte que lorsqu'il était actualisé chez Google. Contrairement à d'autres critères qui sont actualisés chaque fois que le robot de Google visite le site, ce qui est ce que Google appelle temps réel.

Fort heureusement, Google annonce une amélioration majeure de ce point. A partir de maintenant les données Penguin seront actualisées en temps réels.

Plus important encore peut-être, Penguin aura une action plus fine, ne déclassant que les pages concernées par de mauvais liens, et non l'ensemble du site.
Google pénalisera bientôt les sites mobiles qi affichent des pop-ups ou des interstitiels

Soumis par fredericmazue le
Web
Image
Image

Avis aux webmasters. Google a fait une annonce qui aura des répercussions sur le référencement des sites mobiles à partir du 10 janvier 2017. Et oui, pour une fois Google donne une date précise :-)

En hors d'oeuvre, Google indique qu'elle va supprimer (sans indication de date cette fois) la mention site mobile dans les résultats de recherche, afin d'épurer ceux-ci. Google fait le constat que désormais 85% des sites répondent à ses critères 'mobile friendly' et considère que cette indication n'est plus nécessaire. En revanche le caractère 'mobile friendly' continue d'être un critère de classement dans les résultats.

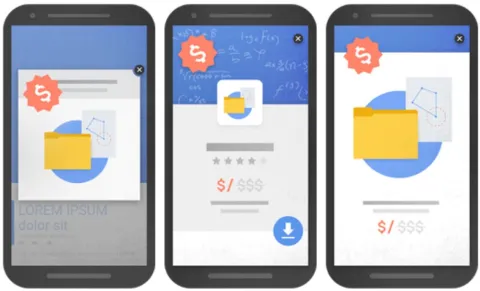
Le point le plus important de l'annonce de Google est que les sites mobiles qui manquent d'ergonomie en raison des publicités pop-ups ou interstitielles qu'ils affichent seront pénalisés à partir de la date indiquée.

Voici selon Google les pratiques qui nuisent à l'accessibilité du contenu sur mobile :

  • Afficher une pop-up qui recouvre le contenu principal, dès que l'utilisateur accède à une page depuis les résultats de recherche ou lorsqu'il parcourt la page.
  • Afficher un interstitiel autonome que l'utilisateur doit fermer avant d'accéder au contenu principal.
  • Utiliser une mise en page où la partie au-dessus de la ligne de flottaison s'affiche comme un interstitiel autonome, mais où le contenu d'origine est intégré sous la ligne de flottaison. 

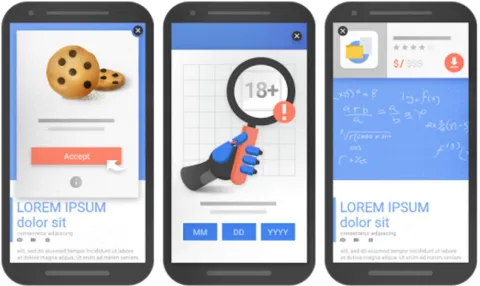
Sont en revanche tolérés

  •  Les interstitiels qui semblent répondre à une obligation légale (par exemple utilisation de cookies ou la vérification de l'âge du visiteur).
  • Les boîtes de dialogue de connexion sur les sites dont le contenu n'est pas indexable publiquement. Cela peut notamment comprendre le contenu privé de type adresse e-mail ou le contenu non indexable situé derrière un paywall.
  • Les bannières qui occupent un espace à l'écran raisonnable et qu'on peut facilement fermer. Par exemple, les bannières d'installation d'applications fournies par Safari et Chrome utilisent un espace à l'écran raisonnable.

Google tempère son annonce en précisant que ce ne sera qu'un critère de classement parmi les centaines d'autres (sans jamais qu'ils exactement ce qu'ils sont :-) et que l'intention de recherche demeure un critère très important.

Recherche Google : RankBrain est utilisé pour toutes les requêtes

Soumis par fredericmazue le
Web

RankBrain est une fonctionnalité de machine learning que Google a introduite petit à petit dans son moteur de recherche.

Le rôle de RankBrain est de comprendre le sens de requêtes difficiles. Par exemple pour une requête telle que Quel est le titre d'un consommateur au plus niveau d'une chaîne alimentaire RankBrain se base sur des connexions (appelées vecteurs) entre mots connus pour essayer de deviner le sens d'une phrase. Avec RankBrain, Google veut améliorer la compréhension des requêtes des internautes. Cette fonctionnalité ne concerne donc pas le classement des sites directement, mais elle aura malgré tout une répercussion importante sur les résultats. Un site jugé pertinent en réponse à une requête avant RankBrain peut ne plus l'être avec lui.

Google communique très peu à propos de RankBrain. Fin octobre 2015, la firme indiquait que RankBrain était utilisé pour seulement 15% des recherches inédites (c'est-à-dire une requête saisie pour la première fois par un internaute), qu'il travaillait hors ligne car il était en phase d'apprentissage et que ses conclusions étaient vérifiées par des humains.

La donne a désormais changé (et le trafic sur vos sites peut-être aussi).D'après Search Engine Land, Google ayant désormais confiance dans RankBrain, celui-ci est désormais utilisé pour toutes les requêtes et cela a une grosse répercussion sur les résultats.

Que faire par améliorer le classement de son site dans ce contexte ? A priori rien :-( La seule solution est d'avoir un bon contenu susceptible de répondre à ce que l'internaute a exprimé - ou a eu l'intention d'exprimer... - en tapant sa requête dans le moteur de recherche.

Amit Singhal démissionne de Google !

Soumis par fredericmazue le

Amit Singhal, qui vient d'annoncer sa démission de Google, démission qui sera effective le 26 février, était le Vice-président senior de l'activité moteur de recherche.

Au-delà du titre ronflant, non seulement Amit Singhal n'était pas n'importe qui, mais il était peut-être (sans doute) le personnage le plus important du moteur de recherche de Google. Plus importants que Larry Page ou Sergeï Brin, pourtant beaucoup plus connus que lui.

En 2000, Mountain View a embauché Amit Singhal au département Search Quality. Son travail a été de veiller constamment à la pertinence des résultats remontés par le moteur, dont il a entièrement réécrit l'algorithme en 2001. Chez Google il était qualifié de 'fellow' ce que l'on peut traduire par ingénieur distingué, ou éminent.

Ce départ est très certainement une grosse perte pour Google. Comme une sorte de séisme dont les secousses se ressentiront sans doute dans le trafic des sites Web à l'avenir.

Amit Singhal sera remplacé par John Giannandrea, qui est impliqué dans de nombreux projets d'intelligence artificielle chez Google. Il est notamment responsable de RankBrain, la partie machine learning de Google Search, qui est devenu le troisième critère de classement des résultats.

Amit Singhal souhaite se consacrer à sa famille et à des projets philanthropiques.

Référencement Google : quelques indications

Soumis par fredericmazue le
Web

Amis webmasters ne rêvez pas, ce n'est pas encore aujourd'hui que Google fera des révélations fracassantes sur son algorithme, ni demain la veille. Ce qui est sûr c'est que l'opacité restera son premier paramètre pendant longtemps :-)

John Mueller, Webmaster Trends Analyst chez Google, donne fréquemment des hangouts aux cours desquels il livre de petites informations. En voici quelques-unes, tirées de son hangout de janvier 2016

Les images

Google, nous le savons, indexe les images. Mais l'algorithme considère que ce sont des données qui changent peu. Dans la pratique, cela signifie que si une image est déjà indexée, et que vous la modifiez ensuite, alors la nouvelle version de l'image pourra ne pas être indexée avant plusieurs mois. Donc bien faire attention lorsqu'on publie un nouveau contenu à donner une version définitive de ses illustrations. Cela vaut bien sûr d'autant plus que le site sur lequel on publie est rapidement indexé. Google indexe certaines sites, par exemple les sites de presse, quasiment en temps réel. Tandis qu'il n'en visite d'autres qu'une fois par semaine ou moins.

La balise Title

Optimisée ou pas ? Les webmasters se posent souvent la question. Voici la réponse (de normand) : la balise Title est importante. Mais on peut être très bien classé dans elle. Mais si elle est optimisée, c'est mieux. Débrouillez vous avec ça :-)

Les URL

Entre deux URL pointant sur un même contenu, Google choisit la plus courte sauf si des indications canonical l'incite à faire autrement. Il ne s'agit pas ici d'un facteur de classement dans les résultats, mais seulement de l'URL qui va apparaître dans le résultat d'une recherche. Ce qui peut avoir son importance aux yeux des webmasters.

Les adresses IP

Serveurs dédiés ou mutualisés, classes d'adresses IP, tout cela n'aucune importance selon John Mueller.

[video:https://www.youtube.com/watch?v=gfXGfvKJnPY]

Désormais Google indexe les URL HTTPS de préférence

Soumis par fredericmazue le
Web

Cela fait pas mal de temps que Google agit pour promouvoir HTTPS et la sécurité des internautes par ce biais.

L'année dernière Google a donné un petit peu de poids aux pages HTTPS dans le classement des résultats de recherche.

Aujourd'hui, dans un billet de blog, Google annonce aller un petit peu plus loin.

Dans le cas où deux URLs, l'une en HTTP, l'autre en HTTPS, présenteraient des contenus identiques, Google n'indexera plus que celle en HTTPS. Mais sous certaines conditions pour le moment, car Google ne veut pas non plus déstabiliser les internautes en émettant des avertissements à tous les coins de pages Web.

Google indexera donc une page HTTPS uniquement, si :

  • elle ne contient pas de dépendances non sécurisées
  • elle n'est pas mentionnée dans un fichier robots.txt comme ne devant pas être indexée
  • elle ne contient pas de balise meta robots noindex
  • elle ne redirige pas les internautes vers une page HTTP non sécurisée
  • elle ne contient pas un lien rel="canonical" vers une page HTTP
  • elle ne comporte pas de lien sortant vers des URLs HTTP
  • sdans le cas où le site présente une sitemap, si l'URL HTTPS est mentionnée par celle-ci et que l'URL HTTP ne l'est pas
  • le serveur a un certificat TSL valide

Par ailleurs Google recommande de construire des pages Web avec un en-tête HSTS, celui-ci indiquant aux navigateurs clients de communiquer avec le site par le protocole HTTPS. 

Référencement Google : Penguin 4.0 devrait arriver fin janvier 2016

Soumis par fredericmazue le
Web

L'hiver c'est la saison des pingouins, c'est bien connu :-) Dans un hangout (à partir de 18mn dans la vidéo ci-dessous) John Muller le responsable chez Google indique que le déploiement d'une nouvelle version, la 4.0, de l'algorithme Penguin devrait être faite fin janvier.

En dépit de l'impatience de nombreux webmasters, John Muller précise qu'il n'est pas exclu qu'il y ait des retards.

Pour mémoire, Penguin est un filtre dont la tâche est de pénaliser les liens présents dans les fermes de contenus, ou les 'mauvais liens' supposés achetés uniquement pour augmenter artificiellement l'ancien PageRank que Penguin remplace.

Des webmasters pressés de voir une mise à jour de l'algorithme de Google arriver ? C'est plutôt rare en effet. Mais dans ce cas, c'est compréhensible. Certains sites se sont vus pénaliser jusqu'à 40% de leur trafic par Penguin, et ils ne s'agissait pas toujours de sites malpropres sur eux.

Revenir de cette pénalité est très difficile. Or, et c'est la bonne nouvelle, Penguin 4.0 devrait être intégré au moteur au lieu de travailler en parallèle, ce qui doit normalement signifier qu'il sera beaucoup plus réactif lorsqu'il s'agira de corriger des pénalités.

[video:https://www.youtube.com/watch?v=ZgTwc8tnW0s]

Google aurait mis à jour son algorithme le 19 novembre avec Phantom 3

Soumis par fredericmazue le
Web

Amis webmasters, avez-vous remarqué de brusques variations dans le trafic de vos sites depuis quelques jours ? Si oui, vous vous demandez sans doute la raison.

Hélas, Google pratique de plus en plus l'opacité en ce qui concerne l'algorithme qui classe les résultats d'une recherche dans son moteur. Opacité ? C'est bien peu dire. Un flacon d'encre de Chine a la limpidité d'une eau de source cristalline en comparaison de l'opacité dont Google fait preuve.

Parfois Mountain View communique sur les modifications, parfois il les nie purement et simplement. Une modification évidente, niée par Google, a en son temps été surnommée Phantom par Glenn Gabe, un blogueur spécialisé dans le référencement.

Google nie, mais quand tous les webmasters constatent des variations, ce n'est pas sans raison. Phantom avait, de l'avis général, pour but d'améliorer la pertinence des pages remontées dans les recherches, sans que les algorithmes Panda ou Penguin soient concernés pour autant.

Est ensuite arrivée une mise à jour Phatom 2, également niée par Google. Mais de l'avis de tous les webmasters, lourde de répercussions. Une mise à jour ravageuse pour certains.

Si vous avez constaté des variations de trafic inexplicables depuis fin novembre, vous partagerez probablement l'avis de searchengineland.com qui évoque une mise à jour Phantom 3.

En quoi consiste-t-elle ? Nul ne le sait. Google dément. John Muller, le responsable de l'algorithme chez Google a twitté en substance : circulez, y a rien à voir :-) Cependant, les variations de trafic sont bel et bien là. Il semblerait que Phantom 3 concerne elle aussi la pertinence. Comme le fait remarquer searchengienland.com, Google apporte de fréquents ajustements à son algorithme. Jusqu'à 400 par an selon certaines sources, soit plus d'un par jour quand même... Dans son tweet John Muller dit 100 par an toutefois.  Quoiqu'il en soit, il n'est pas exclu qu'un tout petit ajustement ait de grands effets. Cependant Phantom 3 pourrait bien être une réalité.

Et vous ? Croyez-vous aux Phatoms ? :-)

RankBrain : du Machine Learning dans Google Search

Soumis par fredericmazue le

Toujours soucieux d'améliorer la pertinence de ses résultats, Google a intégré le Machine Learning dans son moteur de recherche.

Greg Corrado, de Mountain View, a donnée une interview à Bloomberg dans laquelle il nous apprend que l'intelligence artificielle est désormais de la partie lorsqu'il s'agit d'analyser une requête.

Cette fonctionnalité s'appelle RankBrain. Elle est venue faire discrètement (Un peu trop discrètement... Google est toujours trop avare d'informations à ce niveau) partie des critères qui influent sur les résultats d'une recherche. Selon Greg Corrado, RankBrain est impliqué dans seulement 15% des recherches inédites pour le moment. Recherche inédite se comprend par une requête qui est saisie pour le première fois par quelqu'un dans le moteur de recherche. Mais quand il est impliqué, il est bien loin d'être un critère mineur. En effet sur la centaine, si ce n'est beaucoup plus, de critères pris en compte pour remonter des résultats, il est devenu le troisième de ceux-ci depuis les quelques mois qu'il a été déployé. (Mais on ne sait évidemment toujours pas quels sont les deux premiers :-).

Si, amis webmaster, vous avez constaté de grosses fluctuations de trafic sur vos sites ces derniers temps, il n'est pas du tout exclu que RankBrain y soit pour quelque chose et même pour beaucoup.

Que fait RankBrain ? Son rôle est de comprendre le sens de requêtes difficiles. Greg Corrado donne un exemple : Quel est le titre d'un consommateur au plus niveau d'une chaîne alimentaire. RankBrain se base sur des connexions (appelées vecteurs) entre mots connus pour essayer de deviner le sens d'une phrase.

RankBrain ne travaille pas en temps réel, du moins pour l'instant, selon des précisions que Google a apportées à Search Engine Land. RankBrain travaille hors ligne pour ce qui est de sa phase d'apprentissage. Des lots d'historiques de recherches lui sont donnés à ingurgiter, et il apprend à faire des prédictions à partir de ces données. Ces prédictions sont vérifiées par des humains chez Google et si elles sont validées, alors sont basculées dans la partie de RankBrain qui travaille en live.

Pages indexées par Google : quand un bug rencontre une modification d'algorithme

Soumis par fredericmazue le
Web

Amis webmaster, si vous consultez fréquemment les Webmaster Tools de Google, sans doute avez-vous remarqué quelques bizarreries sur la page totalisant les pages indexées par Google en ce qui concerne vos sites.

Très probablement, entre le 19 et le 26 juillet, vous avez remarqué une brusque hausse des pages indexées, ceci sans raison apparente. Puis jusqu'au 16 août ce nombre s'est stabilisée. Pour chuter très brusquement entre le 16 et le 23 août. Une chute qui a sans doute amené le nombre de vos pages indexées en deçà de ce qu'il était le 19 juillet.

Depuis le 23 août ce nombre remonte, pour ce stabiliser à un niveau intermédiaire entre le pic du 26 juillet et le gouffre du 23 août ?

Que s'est-il donc passé ? Ne cherchez plus, John Mueller de Google donne la réponse dans un Hangout. Enfin... si l'on peut appeler ça une réponse.

John Muller explique (vers 5 mn 30 dans la vidéo ci-dessous) que cette brusque variation est due à la coïncidence d'un bug dans le comptage et d'une modification d'algorithme.

Belle explication technique qui confirme que Google fait ce qu'elle veut ici comme en matière de référencement. Aucune indication (claire) n'est donnée en ce qui concerne les algorithme. Un webmaster ne peut même pas savoir concrètement quelles sont les pages indexées.

Bien sûr un esprit simple penserait que s'il a un site qui publie (au sens visibilité sur Internet du terme) 1000 pages, alors logiquement les Webmaster Tools devraient indiquer mille pages indexées.  

Mais ce serait trop simple :-)

[video:https://www.youtube.com/watch?v=25PhSP_eh5k]
